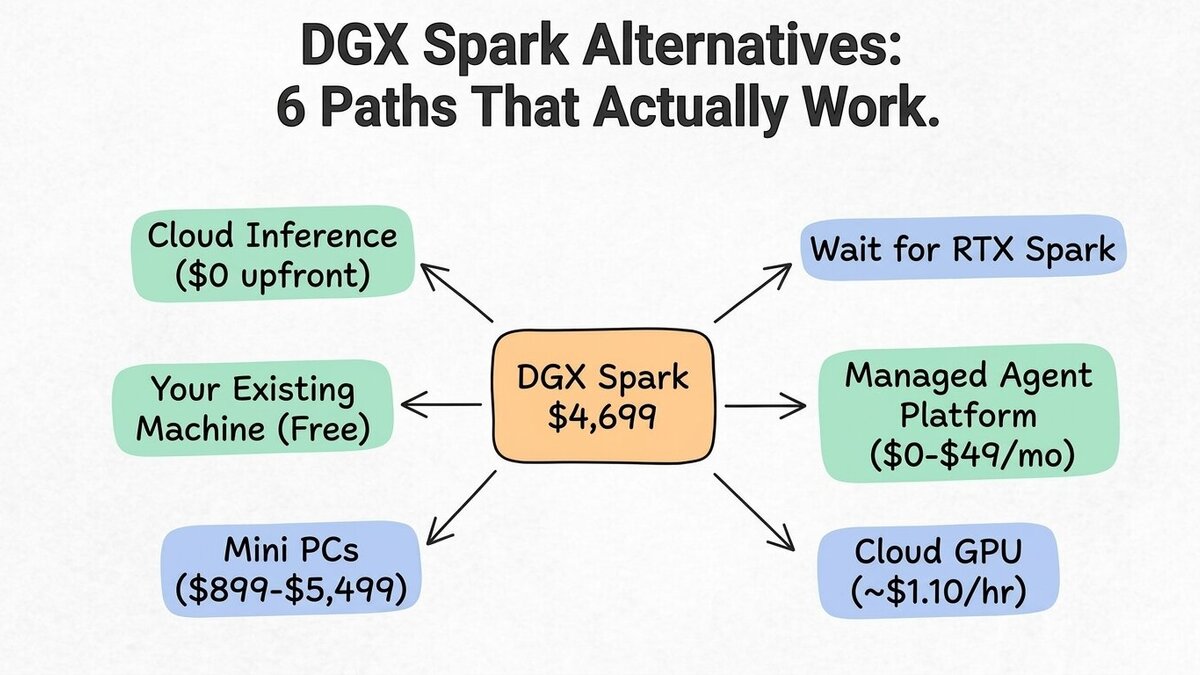
O DGX Spark já custa US$ 6.950 e, no Brasil, passa de R$ 53 mil. Antes de comprar, veja estas seis alternativas: algumas custam metade, outras não custam nada e uma delas gera tokens mais rápido.
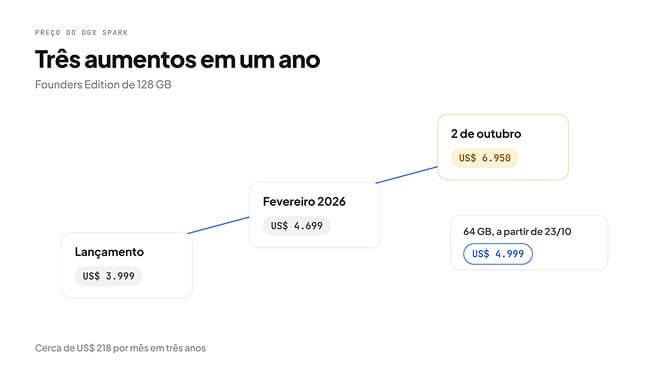
Quando a NVIDIA anunciou o DGX Spark, eu fiquei animado: 128 GB de memória unificada e modelos de 200 bilhões de parâmetros em cima da mesa. Aí veio o preço: US$ 3.999 no lançamento, US$ 4.699 em fevereiro de 2026 e US$ 6.950 desde 2 de outubro. Só Linux.
E tem um detalhe que os vídeos de lançamento não contam: em inferência de LLM, o DGX Spark não supera uma RTX 5090. A velocidade dos tokens é limitada pela largura de banda da memória (em inglês), 273 GB/s, a mesma faixa de várias máquinas mais baratas. Aqui você encontra o preço real, onde comprar no Brasil, o que acontece se trouxer do Paraguai e seis alternativas a partir de US$ 0.
O que é o DGX Spark?
O DGX Spark é o computador de mesa da NVIDIA para IA local: uma caixa pequena com o superchip GB10 Grace Blackwell, 128 GB de memória unificada e a pilha de software de IA da NVIDIA pré-instalada no DGX OS, um Linux baseado em Ubuntu. Ele serve para desenvolver, ajustar e rodar modelos grandes na sua mesa, principalmente se o seu trabalho depende de CUDA, e não roda Windows.
É um produto real para pesquisadores, engenheiros de ML e equipes que vivem no ecossistema da NVIDIA. Se você só quer agentes de IA ou um modelo rodando em hardware próprio, provavelmente vai pagar por coisas de que não precisa.
Quanto custa o DGX Spark em 2026?
O DGX Spark Founders Edition com 128 GB de memória unificada e 4 TB de armazenamento custa US$ 6.950 direto da NVIDIA. Ele saiu por US$ 3.999, subiu para US$ 4.699 em fevereiro de 2026 e a NVIDIA aumentou de novo para US$ 6.950 em 2 de outubro de 2026, as duas vezes citando a oferta de memória. Na prática, a Founders Edition aparece no site da NVIDIA com o botão "Notify Me" (avise-me), ou seja, sem estoque para compra direta.
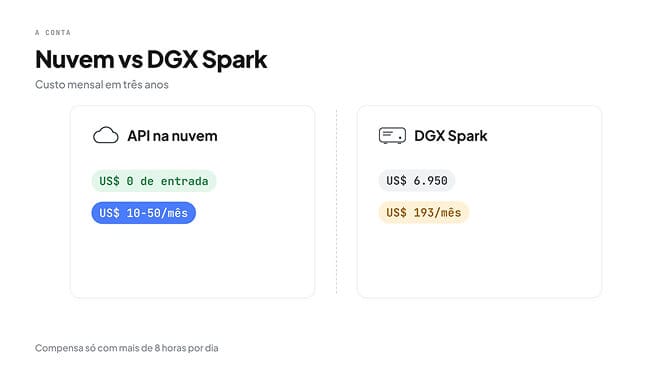
Dividido em três anos, o modelo de 128 GB sai por cerca de US$ 193 por mês em hardware, ou uns US$ 218 com a energia calculada pelos 240 W nominais da fonte, ligada o tempo todo (o pior caso, porque um agente passa quase o dia inteiro ocioso). Cada alternativa desta página é, no fundo, uma comparação com esses US$ 218 por mês. As versões de outros fabricantes com o mesmo chip têm preços próprios; elas estão na seção de clones.
64 GB vs 128 GB: qual compensa?
No mesmo 2 de outubro, a NVIDIA anunciou um DGX Spark de 64 GB por US$ 4.999, que está à venda desde 23 de outubro de 2026. Ele mantém o chip GB10, o DGX OS e todo o software da NVIDIA, com metade da memória. Segundo a NVIDIA, uma unidade roda modelos de até 100 bilhões de parâmetros, contra 200 bilhões do modelo de 128 GB.
Quatro detalhes importam antes de escolher:
- Não é vendido pela NVIDIA. Ele é vendido só por Acer, ASUS, Dell, GIGABYTE, HP e MSI, então o preço final e a garantia dependem de cada fabricante.
- O armazenamento depende do fabricante. Não conte com os 4 TB da Founders Edition.
- Dá para juntar duas unidades. Duas máquinas de 64 GB ligadas por um cabo QSFP nas portas ConnectX-7 somam 128 GB, e o novo Sync Cluster Assistant da NVIDIA configura essa ligação para você. A NVIDIA fala em até 1,7 vez o desempenho de uma unidade sozinha no próprio teste com o Qwen 3.8 27B. Mas duas unidades custam US$ 9.998, contra US$ 6.950 de um único modelo de 128 GB.
- A economia mensal é menor do que parece. Em três anos, ele sai por cerca de US$ 139 por mês, contra US$ 193 do modelo de 128 GB.
Nossa recomendação: se os seus modelos cabem em 64 GB com folga para o contexto, o modelo menor faz sentido. Se você quer rodar modelos de 70B com contexto longo, ou o GPT-OSS 120B, precisa dos 128 GB. E se não precisa de CUDA, um mini PC Strix Halo com 128 GB custa menos que o Spark de 64 GB.
Preço do DGX Spark no Brasil (e vale comprar no Paraguai?)
A maioria das buscas em português pede a mesma coisa: quanto custa aqui e onde comprar. A resposta curta é que você vai pagar bem mais que o preço em dólar, porque ao valor da NVIDIA se somam importação, impostos e a margem de quem vende.
Todos os preços desta seção foram coletados depois do aumento de 2 de outubro. Confira de novo no dia da compra.
Brasil
No Brasil, o DGX Spark aparece principalmente em marketplaces, com lojistas parceiros vendendo dentro de grandes lojas. Os anúncios que conferimos no KaBuM:
| Anúncio no KaBuM | Vendedor | Modelo | Preço | Data |
|---|---|---|---|---|
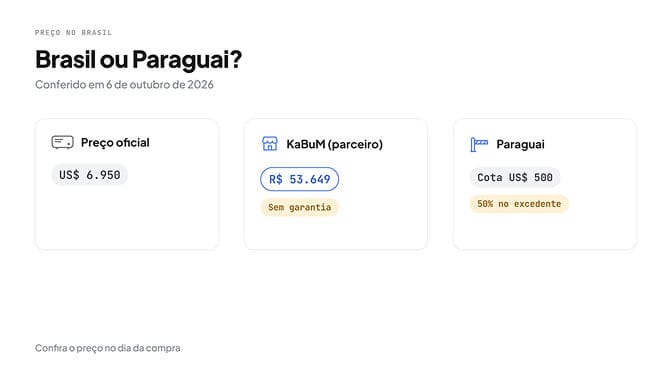
| "Dgx Spark Personal Ai Supercomputer" | Infotecdez importados USA (parceiro) | 128 GB / 4 TB NVMe | R$ 53.649 à vista ou 10x de R$ 5.364,90 sem juros | 6 de outubro de 2026 |
| "Servidor de IA Nvidia DGX Spark GB10 Blackwell 128GB 4TB" | EFACINI (parceiro) | Founders Edition 128 GB / 4 TB | R$ 59.779,90 ou 10x de R$ 5.977,99 | 6 de outubro de 2026 |
Os dois anúncios descrevem o modelo de 128 GB com 4 TB, e os dois aparecem como disponíveis. Mas atenção: nenhum é vendido pelo próprio KaBuM, e o campo de garantia do site mostra "Sem Garantia" em ambos. O segundo vendedor promete garantia oficial e nota fiscal na descrição; confirme isso por escrito antes de pagar.
Antes de comprar, confira três coisas: se é mesmo o modelo de 128 GB e 4 TB, quem dá a garantia no Brasil e se há nota fiscal brasileira.
Vale a pena comprar o DGX Spark no Paraguai?
Muita gente pesquisa "dgx spark no paraguai" esperando economizar. O preço na prateleira pode até ser menor, mas a conta muda na volta, por três motivos.
A cota de isenção é pequena para um produto desse valor. Pela regra da Receita Federal (página atualizada em 27 de janeiro de 2026), quem entra no Brasil por via terrestre, como pela Ponte da Amizade, tem cota de isenção de US$ 500 por pessoa. Ela só vale uma vez a cada 30 dias e é individual: não dá para somar a cota da família para trazer um único aparelho.
O excedente paga 50% de imposto. Acima da cota, a bagagem é tributada em 50% sobre o valor que passar. Pagando o preço oficial de US$ 6.950, o excedente seria de US$ 6.450 e o imposto, de US$ 3.225: cerca de US$ 10.175 no total. E a Receita pode recusar o tratamento de bagagem se entender que a compra tem finalidade comercial.
Não há garantia local. Se o aparelho der defeito, o suporte normalmente fica no país onde foi comprado.
Resumo honesto: para um equipamento de quase US$ 7 mil, o Paraguai raramente compensa. Se o seu objetivo é economizar, um mini PC Strix Halo ou a inferência na nuvem, mais abaixo, economizam muito mais do que qualquer rota de importação.
As melhores alternativas ao DGX Spark, por preço
Se o preço é o que decide, aqui estão todas as opções numa tabela, da mais barata à mais cara. O DGX Spark fica no fim, como referência.
Preços conferidos pela última vez em 28 de setembro de 2026; DGX Spark atualizado em 5 e 23 de outubro, RTX Spark incluído em 16 de outubro e ASUS GX10 conferido em 14 e 27 de outubro de 2026. Leia como uma foto, não como algo fixo. A falta de DRAM e NAND em 2026, que levou o próprio Spark de US$ 3.999 para US$ 4.699 e depois para US$ 6.950, mexeu no preço de todas as máquinas com memória unificada desta lista, quase sempre para cima, e várias configurações estão em pré-venda em vez de em estoque. Os preços estão em dólares americanos.
| Opção | Preço | Memória | O que você perde em relação ao DGX Spark |
|---|---|---|---|
| Ollama no hardware que você já tem | US$ 0 | A que você tiver | Capacidade. Na prática, modelos de até uns 30B com 32 GB |
| Inferência na nuvem (OpenRouter, Groq, Together) | US$ 0 de entrada, uns US$ 10-50/mês | Ilimitada | Soberania dos dados e uso offline |
| Plataforma de agentes gerenciada (BetterClaw) | US$ 0 no plano gratuito, US$ 49/mês no Pro | Não se aplica, usa suas chaves | Acesso direto à GPU. Você não hospeda o modelo |
| Aluguel de GPU na nuvem (Vast.ai, RunPod) | A partir de uns US$ 0,94-1,79/h (uns US$ 150-290/mês a 8 h × 20 dias) | A100 de 80 GB ou mais | Soberania dos dados, latência estável, custo 24/7 |
| Mac mini M6 | A partir de US$ 899 | 16 GB na base | Capacidade de 128 GB. Bom para modelos abaixo de 30B |
| Mac Studio M5 Max | A partir de US$ 2.499 (36 GB), US$ 5.399 com 128 GB | 36-128 GB | CUDA. Ganha até 614 GB/s de largura de banda |
| Notebooks RTX Spark (Surface Laptop Ultra, ASUS ProArt) | A partir de US$ 2.599; uns US$ 5.900 com 128 GB | Até 128 GB | DGX OS, uns 7% de velocidade em agentes e o formato desktop. Ganha Windows, portabilidade e 300 GB/s. Os desktops (Surface RTX Spark Dev Box, US$ 5.999) chegam em novembro |
| Bosgame M5 (Strix Halo) | US$ 3.099 | 128 GB | CUDA. ROCm e Ollama funcionam; NIM e TensorRT-LLM não |
| Framework Desktop (Strix Halo) | US$ 3.449 (esgotado) | 128 GB | CUDA. Ganha modularidade e reparabilidade |
| GMKtec EVO-X2 | US$ 3.499,99 (1 TB), US$ 3.649,99 (2 TB) | 128 GB | CUDA. Ganha a máquina barata mais testada pela comunidade |
| AMD Ryzen AI Halo Developer Platform | US$ 3.999 | 128 GB | CUDA. Ganha suporte a Windows |
| ASUS Ascent GX10 | Uns US$ 5.999-6.900 (1 TB), conforme a loja | 128 GB | Nada na arquitetura: mesmo chip GB10, mas já não é sempre mais barato |
| HP Z2 Mini G1a | A partir de uns US$ 4.000 (128 GB) | 128 GB | CUDA. Ganha garantia corporativa |
| Mac Studio M5 Ultra | A partir de US$ 5.499 | 96-512 GB | CUDA. Ganha 1,2 TB/s, cerca de 4 vezes a largura de banda |
| NVIDIA DGX Spark (referência) | US$ 6.950 (128 GB); US$ 4.999 (64 GB, desde 23 de outubro) | 64 ou 128 GB | - |
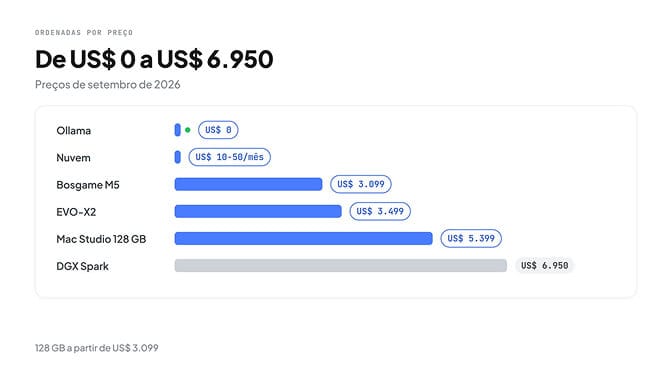
Três conclusões desta tabela:
O jeito mais barato de ter 128 GB custa US$ 3.099, não US$ 6.950. O Bosgame M5 iguala os 128 GB do Spark com largura de banda parecida (uns 256 GB/s contra 273 GB/s) por US$ 3.851 a menos, e US$ 1.900 a menos que o Spark de 64 GB. O GMKtec EVO-X2 (US$ 3.499,99) é o mais testado pela comunidade; cuidado, por US$ 2.199,99 você leva a versão de 64 GB. Nos dois casos você perde CUDA.
A opção mais barata que coloca agentes para trabalhar custa US$ 0. Se você quer agentes e não hardware, comece com inferência na nuvem ou uma plataforma gerenciada, e compre hardware depois se a conta mudar.
A vantagem da AMD encolheu em 2026 e depois voltou a crescer. O EVO-X2 saiu perto de US$ 1.500 e o Framework Desktop de 128 GB por US$ 1.999; a mesma falta de LPDDR5x encareceu os dois. Depois do aumento do Spark para US$ 6.950, eles custam mais ou menos a metade dele: com 128 GB, a AMD economiza entre uns US$ 2.950 e US$ 3.850.
Qual "Spark"? DGX Spark vs RTX Spark
Existem quatro produtos diferentes chamados "Spark", com alternativas completamente diferentes.
NVIDIA DGX Spark: o computador de mesa para IA de US$ 6.950 (ou US$ 4.999 o modelo de 64 GB, à venda desde 23 de outubro), com o superchip GB10 Grace Blackwell e 128 GB de memória unificada. É o produto desta página.
NVIDIA RTX Spark: notebooks e desktops compactos com Windows em Arm, baseados no superchip RTX Spark (N1X é um apelido do setor, não o nome da NVIDIA), apresentado pela NVIDIA na Computex em 31 de maio de 2026. A pré-venda abriu no evento da Microsoft em 7 de outubro. A versão mais alta combina uma CPU Grace de 20 núcleos, uma GPU Blackwell RTX de 6.144 núcleos e até 128 GB de memória unificada, com 300 GB/s de largura de banda; os chips de notebook trabalham entre 45 e 80 W e os de desktop chegam a 140 W. Os notebooks estão à venda desde 16 de outubro de 2026, a partir de US$ 2.599 (Surface Laptop Ultra, ASUS ProArt P14), e as versões de 128 GB custam uns US$ 5.900. O Surface RTX Spark Dev Box custa US$ 5.999 e começa a ser enviado em novembro, junto com os outros desktops compactos. Há equipamentos de ASUS, Dell, HP, Lenovo, Microsoft Surface e MSI.
Alternativa ao RTX Spark: o que mais está à venda com especificações parecidas
Se você procura uma alternativa ao RTX Spark, ou quer comparar antes de comprar um, estas são as máquinas portáteis com memória unificada comparável:
| Máquina | Memória unificada | Largura de banda | Observações |
|---|---|---|---|
| Notebooks RTX Spark (Surface Laptop Ultra, ASUS ProArt e outros) | Até 128 GB | 300 GB/s | À venda desde 16 de outubro. A partir de US$ 2.599; uns US$ 5.900 com 128 GB. CUDA no Windows em Arm |
| MacBook Pro M5 Max | Até 128 GB (só com GPU de 40 núcleos) | 460 GB/s (GPU de 32 núcleos), 614 GB/s (40 núcleos) | Já à venda. O líder em largura de banda num notebook, e o preço acompanha |
| Notebooks e tablets Strix Halo (Ryzen AI Max+ 395) | Até 128 GB | Uns 256 GB/s | Já à venda. Mesma faixa de largura de banda do DGX Spark, com ROCm no lugar de CUDA |
| Equipamentos com GPU RTX 5090 para notebook | 24 GB GDDR7 (dedicada) | Muito maior, com muito menos capacidade | Mais rápido por token, mas 24 GB limitam bem abaixo dos modelos de 70B |
| DGX Spark ou um clone GB10 (desktop) | 128 GB | 273 GB/s | A mesma ideia de Grace mais Blackwell, uns 7% mais rápida em agentes, mas é um desktop com Linux, não um notebook com Windows |
Resumo honesto: nenhum outro notebook junta CUDA e 128 GB de memória unificada como o RTX Spark. O M5 Max dá a memória e cerca do dobro da largura de banda sem CUDA; o Strix Halo dá a memória barata sem CUDA; um notebook com RTX 5090 dá CUDA sem a memória.
Gemini Spark: o agente de IA do Google, de US$ 100 por mês e só nos Estados Unidos; veja as alternativas ao Gemini Spark (em inglês).
Apache Spark: o framework de processamento de dados distribuído, sem relação com a NVIDIA.
GPU equivalente do RTX Spark
Resposta curta: em gráficos, a GPU do RTX Spark rende como uma RTX 5070 de notebook nos benchmarks nativos, e fica mais perto de uma RTX 5060 de notebook em alguns jogos, como Cyberpunk 2077 em 1440p. Para IA local, a melhor comparação nem é uma placa de vídeo: ele fica a cerca de 7% de um DGX Spark, porque é basicamente o mesmo projeto Grace Blackwell rodando com menos energia.
As análises saíram na semana de 15 de outubro de 2026. Isto é o que elas mediram (em inglês):
- 3DMark Steel Nomad: 3.134 pontos, empatado com uma RTX 5070 de notebook (3.075), segundo a Notebookcheck.
- Cyberpunk 2077, Ultra, 1440p: 56,8 fps, contra 57 fps de uma RTX 5060 de notebook.
- Fora da IA: o Windows Central resume o desempenho como de classe RTX 4070, 5060 ou 5070 na maioria das tarefas.
A diferença está na memória por trás da GPU: uma RTX 5070 de notebook tem 8 GB de VRAM dedicada, enquanto o RTX Spark entrega 64 GB à GPU por padrão numa máquina de 128 GB, e mais se você aumentar essa divisão.
Desempenho em IA local
É aqui que o RTX Spark justifica o preço. A Artificial Analysis (em inglês) rodou a mesma carga de agente local, com 168 turnos, em várias máquinas (modelos em 4 bits, sem contar o tempo das ferramentas):
| Sistema | Qwen 3.8 27B | Qwen 3.6 35B-A3B | Ling 3.0 Flash (MoE de 124B) |
|---|---|---|---|
| GeForce RTX 5090 (desktop) | 4,9 min | 2,0 min | Não cabe |
| DGX Spark | 17,3 min | 7,3 min | 14,9 min |
| Notebook RTX Spark | 18,7 min | 7,6 min | 15,3 min |
| AMD Ryzen AI Halo (Strix Halo) | 34,5 min | 11,7 min | 25,1 min |
| MacBook Pro M5 Pro, 64 GB | 37,6 min | 11,9 min | Não cabe |
Menor é melhor. Fonte: Artificial Analysis AgentPerf-Local, 15 de outubro de 2026.
O notebook RTX Spark é cerca de 7 a 8% mais lento que um DGX Spark, com um chip de 45 a 80 W. As duas máquinas da NVIDIA terminam o trabalho com modelos densos em mais ou menos metade do tempo de um Strix Halo. E uma RTX 5090 de desktop é mais de três vezes mais rápida que as duas, desde que o modelo caiba nos 32 GB dela.
A seguir, as mesmas opções agrupadas por abordagem, com o raciocínio de cada uma.
Alternativa 1: inferência na nuvem (sem hardware)
Custo: US$ 0 de entrada. Você paga por token.
Se o seu objetivo é rodar agentes de IA e não manter hardware local, a inferência na nuvem dá acesso a todos os modelos sem comprar nada. OpenRouter (US$ 0,30 por milhão de tokens de entrada no MiniMax M3, US$ 0,07 no GLM 5.3 e US$ 2 no Claude Sonnet 5), Groq (inferência rápida de Llama) e Together.ai (hospedagem de modelos open source) oferecem endpoints compatíveis com suas próprias chaves de API. Se estiver em dúvida entre usar o OpenRouter ou ir direto a cada provedor, comparamos as duas opções em OpenRouter vs API direta para agentes (em inglês).
Quando faz sentido: seu agente executa menos de 5.000 tarefas por dia, a sensibilidade dos seus dados permite usar uma API e você quer acesso a modelos de ponta (Claude Opus 5.5, GPT-6) que nenhum hardware local consegue rodar.
Quando não faz: você precisa de soberania dos dados, seu volume é tão alto que o custo da API passa a amortização do hardware, ou você precisa trabalhar offline.
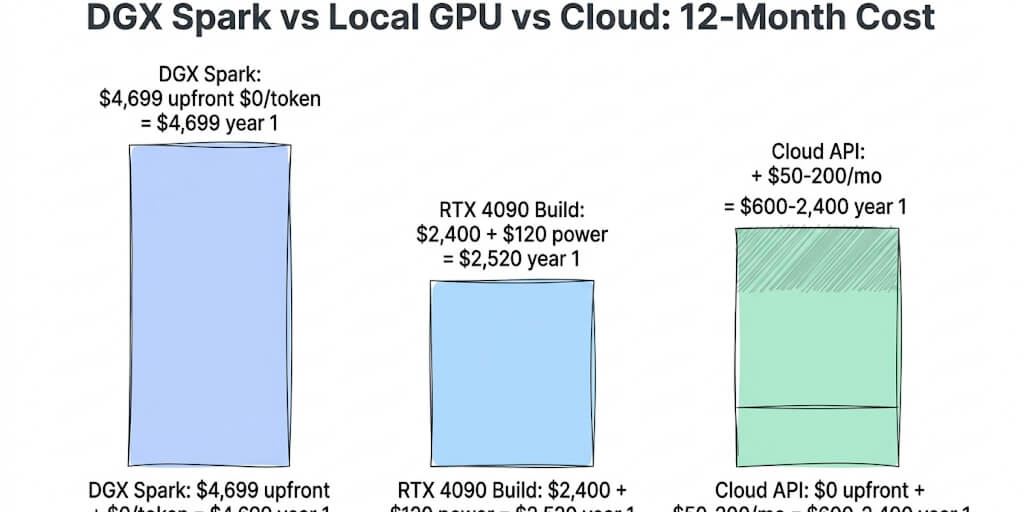
A conta: um DGX Spark de US$ 6.950 se amortiza em cerca de US$ 193 por mês em três anos. Com preços de API típicos, a maioria das cargas de trabalho de agentes custa entre US$ 10 e 50 por mês. Você precisaria rodar inferência mais de 8 horas por dia, com muito volume, para o hardware local compensar. A comparação completa de 12 meses está em DGX Spark vs GPU local vs API na nuvem (em inglês).
Alternativa 2: Ollama no seu próprio PC (grátis)
Custo: US$ 0.
Antes de gastar US$ 6.950, veja o que você já tem. O Ollama (em inglês) roda em Mac, Windows e Linux. Com 16 GB de RAM, você roda Gemma 4 12B, Qwen 3.6 35B-A3B (só 3B de parâmetros ativos) ou Llama 3.1 8B numa velocidade usável. O Qwen 3.6 continua sendo o MoE pequeno de referência: o Qwen 3.8 pulou esse tamanho e foi direto do 27B denso para o Qwen 3.8 Flash-Next, um MoE de cerca de 180B no total com 6B ativos.
Com 32 GB (qualquer Mac com Apple Silicon, incluindo os M5 e M6 atuais, ou um PC com 32 GB de RAM), você roda o Qwen 3.8 27B e a maioria dos modelos open source que importam para agentes. Se quiser saber qual modelo gratuito rende mais, temos o nosso guia dos melhores modelos gratuitos.
Um único comando:
brew install ollama && ollama run gemma4:12b
Pronto. Sem US$ 6.950. Sem obrigação de usar Linux. O modelo roda no seu próprio computador.
Para usar esses modelos com agentes na nuvem que funcionam 24/7, o app de desktop do BetterClaw (em inglês), gratuito, conecta o Ollama, LM Studio ou llama.cpp do seu computador aos seus agentes do BetterClaw, sem abrir portas.
Quando faz sentido: você quer testar IA local, tem um Mac com Apple Silicon ou um PC gamer com uma GPU razoável, e seus modelos têm menos de 30B parâmetros.
Quando não faz: você precisa de modelos de 70B ou mais, seu computador tem menos de 16 GB de RAM, ou você precisa de uma máquina dedicada ligada 24/7 enquanto usa o computador principal para outras coisas.
Alternativa 3: mini PCs para IA local
Custo: de US$ 899 a US$ 5.499.
É aqui que o DGX Spark tem mais concorrência, e onde o mercado mais mudou no meio de 2026.
Apple: Mac mini (a partir de US$ 899) e Mac Studio M5 (a partir de US$ 2.499)
A memória unificada do Apple Silicon e a aceleração por GPU com Metal fazem dessas as máquinas de IA local mais fáceis de usar. Se você está em dúvida entre os dois ecossistemas, nossa comparação de Apple Silicon vs NVIDIA para agentes de IA (em inglês) explica o equilíbrio entre capacidade e velocidade.
O Mac mini agora começa em US$ 899 com 16 GB (M6 na base desde 22 de setembro; M5 Pro a partir de US$ 1.699). Com modelos pequenos, o limite não é o chip, são os 16 GB.
O Mac Studio foi renovado em 25 de agosto de 2026 com M5 Max e M5 Ultra (atenção: um Mac Studio "M4 Ultra" nunca chegou a ser vendido):
- M5 Max, a partir de US$ 2.499. 36 GB na base, configurável até 128 GB. 460 GB/s com a GPU de 32 núcleos e 614 GB/s com a de 40. Com 128 GB, iguala a capacidade do Spark com cerca de 2,25 vezes a largura de banda. A configuração de 128 GB exige a GPU de 40 núcleos e custa US$ 5.399 com 1 TB, US$ 1.551 a menos que o Spark depois do aumento de outubro.
- M5 Ultra, a partir de US$ 5.499. 1,2 TB/s de largura de banda, cerca de 4 vezes os 273 GB/s do Spark, com 96 GB na base e até 512 GB de memória unificada (em 27 de outubro a Apple ainda indicava a opção de 512 GB como "coming late October", então por enquanto o máximo que dá para encomendar é 256 GB). É o jeito mais rápido de gerar tokens com um modelo local grande em cima da mesa, e o preço acompanha.
ASUS Ascent GX10 (uns US$ 5.999-6.900, e muito variável)
O mesmo superchip GB10 do DGX Spark (o silício é da NVIDIA, a caixa é da ASUS), com 128 GB de LPDDR5x, SSD de 1 TB, rede ConnectX-7 e DGX OS. Durante boa parte de 2026 ele custava perto de US$ 3.099 com 1 TB, e depois disparou: em 14 de outubro, Newegg e B&H anunciavam por US$ 5.999 e vendedores terceiros na Amazon por uns US$ 6.900. A loja da própria ASUS lista US$ 5.999 (1 TB), US$ 6.999 (2 TB) e US$ 7.999 (4 TB), todos esgotados em 27 de outubro.
Você leva CUDA e o software da NVIDIA, com suporte da ASUS em vez da NVIDIA. Na melhor das hipóteses, o GX10 sai uns US$ 950 mais barato que o Spark de US$ 6.950, então compare várias lojas. Confirme configuração e preço na hora de pagar. A ASUS também é uma das seis parceiras que vendem o novo DGX Spark de 64 GB por US$ 4.999.
Clones do DGX Spark: as outras máquinas com GB10
O GX10 não é o único clone do Spark. A NVIDIA licenciou o superchip GB10 para os parceiros de sempre, e cada um vende os mesmos 128 GB, os mesmos 273 GB/s e o mesmo DGX OS numa caixa um pouco diferente, com outra garantia, outro armazenamento e outro preço.
| Máquina | Preço (EUA) | Armazenamento | Observações |
|---|---|---|---|
| NVIDIA DGX Spark Founders Edition | US$ 6.950 (desde 2 de outubro; antes US$ 4.699) | 4 TB | A unidade de referência. O modelo de 64 GB custa US$ 4.999, pelos fabricantes parceiros, desde 23 de outubro |
| ASUS Ascent GX10 | US$ 5.999 (Newegg, B&H) a uns US$ 6.900 (terceiros na Amazon), 14/10 | 1 TB na base | Veja acima |
| GIGABYTE AI TOP ATOM | US$ 5.999,99 (1 TB, esgotado) na Newegg, 25/10 | 1 TB ou 4 TB | No mesmo preço do GX10, quando tem estoque |
| HP ZGX Nano G1n AI Station | US$ 5.999,99 (1 TB, esgotado), uns US$ 6.030 (4 TB) na Newegg, 28/9 | 1 TB ou 4 TB | Garantia da linha HP Z |
| Lenovo ThinkStation PGX | Consultar na B&H ou CDW | 1 TB ou 2 TB | Suporte ThinkStation |
| Acer Veriton GN100 | Consultar na Acer Store ou B&H | 4 TB | |
| MSI EdgeXpert | Consultar na loja | De 1 a 4 TB | Saiu a partir de US$ 2.999. Anunciado como MS-C931 e vendido com códigos EdgeXpert |
| Dell Pro Precision with GB10 (antes Pro Max) | A partir de US$ 6.213 (1 TB), US$ 6.593 (2 TB), US$ 9.043 (4 TB) no dell.com, em estoque, 27/10 | De 1 a 4 TB | Caminho de compra corporativa, com Dell ProSupport |
A regra prática: é o mesmo silício, então só mudam o preço, o estoque e quem atende quando quebra. Se houver um clone em estoque abaixo de US$ 6.950, compre o clone.
Framework Desktop com Strix Halo (US$ 3.449, em pré-venda)
O Framework Desktop com AMD Ryzen AI Max+ 395 é a opção reparável e expansível: 128 GB de memória unificada e componentes modulares, pensado para durar mais de três anos. A configuração DIY de 128 GB saiu por US$ 1.999 e em setembro de 2026 custava US$ 3.449, esgotada. Mesmo assim custa metade de um Spark, e a comunidade já validou o modelo para IA de classe 70B em Q4. O que você perde é CUDA.
| DGX Spark | Framework Desktop | |
|---|---|---|
| Preço | US$ 6.950 (desde 2 de outubro de 2026) | US$ 3.449 (128 GB DIY, em pré-venda) |
| Preço de lançamento | US$ 3.999 | US$ 1.999 |
| Memória | 128 GB unificada | 128 GB unificada |
| Largura de banda | 273 GB/s | Uns 256 GB/s |
| Expansível | Não | Sim: modular e reparável |
| Software | CUDA, NIM, TensorRT-LLM | ROCm, Ollama, llama.cpp, vLLM |
| Sistema operacional | Só Linux (DGX OS) | Linux ou Windows |
| Suporte | NVIDIA | Framework mais uma comunidade open source muito ativa |
O resto das opções Strix Halo
O Ryzen AI Max+ 395 já não é uma escolha de "EVO-X2 ou nada". Vários fabricantes vendem o mesmo chip com o mesmo máximo de 128 GB:
- Bosgame M5 (US$ 3.099 com 128 GB / 2 TB): a máquina Strix Halo de 128 GB mais barata que encontramos em estoque, enviada de um depósito nos Estados Unidos.
- GMKtec EVO-X2 (US$ 3.499,99 com 128 GB / 1 TB, US$ 3.649,99 com 2 TB): a mais validada pela comunidade entre as baratas, com mais detalhes abaixo. Por US$ 2.199,99 você leva o modelo de 64 GB.
- HP Z2 Mini G1a (a partir de uns US$ 4.000 com 128 GB; os anúncios abaixo de US$ 3.000 são de 32 GB): o mesmo chip com garantia corporativa da HP.
- AMD Ryzen AI Halo Developer Platform (US$ 3.999): a máquina oficial da AMD, com Linux ou Windows 11 Pro.
- Minisforum MS-S1 Max (US$ 3.919 com 2 TB, envio no fim de novembro), Beelink GTR9 Pro (US$ 4.349) e Corsair AI Workstation 300 (US$ 4.599,99), todos com 128 GB: o resto do grupo, os que mais subiram por causa da memória.
Alternativa 4: alugar uma GPU na nuvem
Custo: você paga por hora. Sem hardware de entrada. A partir de uns US$ 0,94/h.
RunPod, Vast.ai e Lambda Labs alugam instâncias com GPU por hora. Uma A100 de 80 GB custa a partir de uns US$ 0,94/h na Vast.ai e de US$ 1,19 a 1,79/h na RunPod (verificado em 14 de outubro). Usando 8 horas por dia, 20 dias por mês, dá cerca de US$ 150 a 290 por mês, com muito mais poder que um Spark.
Quando faz sentido: cargas pontuais, treinamento ou fine-tuning (em que o DGX Spark fica fraco de qualquer jeito), projetos curtos e equipes que precisam de GPU por semanas, não anos.
Quando não faz: você precisa de soberania dos dados, de latência estável ou roda inferência 24/7.
Onde fica o ponto de equilíbrio: ter um DGX Spark de 128 GB sai por cerca de US$ 218 por mês em três anos, com energia incluída. A US$ 1,79/h (RunPod), isso paga cerca de 122 horas de GPU alugada por mês, umas 4 horas por dia (cerca de 230 horas na tarifa mais barata da Vast.ai, US$ 0,94). Acima disso, comprar sai mais barato. Fizemos a conta completa, com valor residual e os custos que a tarifa por hora esconde, em DGX Spark: alugar GPU na nuvem ou comprar o hardware? (em inglês)
Alternativa 5: uma plataforma de agentes gerenciada
Esta é a pergunta que quase nunca aparece quando alguém procura uma alternativa ao DGX Spark: você precisa mesmo rodar os modelos localmente?
Se o seu objetivo é criar agentes de IA que automatizem seu trabalho, o modelo é uma peça, não o produto. Você não precisa hospedá-lo. Precisa que ele funcione.
O BetterClaw se conecta a mais de 28 provedores de modelos com suas próprias chaves de API. Você pode usar uma chave do OpenRouter (qualquer modelo open source), da Anthropic (Claude), da OpenAI (GPT), do Google (Gemini), da MiniMax (M3) ou de outro provedor. Também dá para apontar para a sua própria instância do Ollama no hardware que você já tem. Se procura um agente de IA gratuito para começar, o plano gratuito é o ponto de partida.
A plataforma cuida da lógica do agente, das integrações, do agendamento de tarefas, da memória e da segurança. O modelo quem escolhe é você.
Custo: plano gratuito (US$ 0 por mês, 1 agente, 100 créditos por mês, skills básicas). Pro: US$ 49 por mês. Mais o que o seu provedor de modelos cobrar.
Quando faz sentido: você quer agentes funcionando, não GPUs funcionando. Quer alternar entre modelos na nuvem e locais sem mexer na configuração do agente. Não quer administrar infraestrutura.
Quando não faz: você faz pesquisa de ML que exige acesso direto à GPU, ajusta modelos (agentes usam inferência, não treinamento) ou quer montar sua própria pilha para servir modelos.
Alternativa 6: esperar a próxima geração
O hardware de IA local avança rápido. Esta seção foi escrita como previsão no meio de 2026; aqui ela está revisada no fim de outubro de 2026: o que já chegou e o que ainda falta.
Já à venda
Notebooks RTX Spark (16 de outubro de 2026). Os primeiros notebooks que juntam CUDA e até 128 GB de memória unificada, a partir de US$ 2.599. As análises colocam o desempenho em agentes a cerca de 7% de um DGX Spark (veja a GPU equivalente do RTX Spark).
DGX Spark de 64 GB (23 de outubro de 2026). US$ 4.999 por Acer, ASUS, Dell, GIGABYTE, HP e MSI, com a opção de juntar duas unidades pelo Sync Cluster Assistant da NVIDIA.
Mac Studio M5 Max e M5 Ultra, HP Z2 Mini G1a, AMD Ryzen AI Halo e Framework Desktop de 128 GB. Todos já estão à venda (veja a alternativa 3), ainda que vários mais caros que no lançamento e muitas vezes esgotados.
Perplexity Portable Computer. Lançado em 25 de agosto de 2026 com a NVIDIA, roda toda a pilha do agente na sua máquina, sem custo por token nas etapas locais, no DGX Spark e em GPUs RTX de 24 GB ou mais. Se você ia comprar um Spark, é o primeiro software que faz a dependência valer a pena; se não ia, não é motivo para começar.
Ainda por vir
Desktops compactos RTX Spark, novembro de 2026. Incluindo o Surface RTX Spark Dev Box, por US$ 5.999. Serão os primeiros desktops Windows com CUDA e 128 GB de memória unificada. Os principais motivos para esperar já passaram (notebooks RTX Spark em 16 de outubro, Spark de 64 GB em 23 de outubro); este é o que sobra.
Equipamentos com LPDDR6, do fim de 2026 a 2027. A LPDDR6 oferece cerca de 2,25 vezes a largura de banda por chip da LPDDR5X, mas chega primeiro aos celulares; os desktops, em 2027. Quando chegar, o teto de 273 GB/s do Spark e do Strix Halo vai subir bastante.
Modelos cada vez menores. O Gemma 4 12B já roda em 16 GB (em inglês). O Qwen 3.6 35B-A3B ativa só 3B de parâmetros. À medida que os modelos ficam mais eficientes, o hardware necessário para inferência local continua caindo.
Um alerta: a falta de DRAM não está melhorando, e todas as máquinas desta página ficaram mais caras em 2026. Espere os desktops RTX Spark (novembro) se quiser um desktop Windows com CUDA, mas não espere indefinidamente os preços caírem.
DGX Spark vs RTX 5090, Mac Studio, Strix Halo e outros
Estas são as comparações mais buscadas em português, numa tabela só. Os preços estão em dólares americanos.
| Máquina | Memória | Largura de banda | Preço | CUDA | Sistema operacional |
|---|---|---|---|---|---|
| NVIDIA DGX Spark | 128 GB unificada (ou 64 GB) | 273 GB/s | US$ 6.950 (128 GB); US$ 4.999 (64 GB, desde 23 de outubro) | Sim | Só Linux (DGX OS) |
| Notebook RTX Spark | Até 128 GB unificada | 300 GB/s | A partir de US$ 2.599; uns US$ 5.900 com 128 GB | Sim | Windows em Arm |
| NVIDIA RTX 5090 (GPU de desktop) | 32 GB GDDR7 dedicada | 1,79 TB/s | US$ 1.999 no lançamento; uns US$ 4.100-5.000 nas lojas dos EUA em setembro de 2026 | Sim | Windows ou Linux |
| Mac Studio M5 Max | 36-128 GB unificada | 460 GB/s (GPU de 32 núcleos), 614 GB/s (40 núcleos) | A partir de US$ 2.499; US$ 5.399 com 128 GB | Não | macOS |
| Strix Halo / Ryzen AI Max+ 395 (Bosgame M5) | 128 GB unificada | Uns 256 GB/s | US$ 3.099 | Não (ROCm) | Linux ou Windows |
| ASUS Ascent GX10 | 128 GB unificada | 273 GB/s | Uns US$ 5.999-6.900 conforme a loja | Sim | Linux (DGX OS) |
| HP ZGX Nano | 128 GB unificada | 273 GB/s | US$ 5.999,99 (1 TB, esgotado); uns US$ 6.030 (4 TB, Newegg) | Sim | Linux (DGX OS) |
| NVIDIA RTX Pro 6000 | 96 GB GDDR7 dedicada | 1,79 TB/s | US$ 13.998-16.000 | Sim | Windows ou Linux |
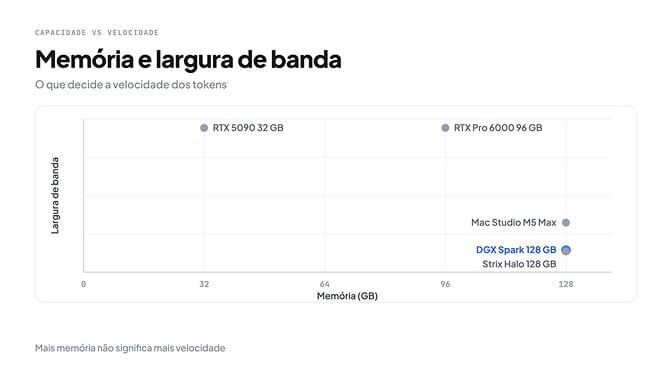
Como ler a tabela:
DGX Spark vs RTX 5090. A 5090 é muito mais rápida para gerar tokens com modelos que cabem na memória dela, porque a largura de banda é várias vezes maior. O problema é a capacidade: com 32 GB você não carrega um modelo de 70B com contexto longo, e o Spark carrega. E a 5090 já não é a opção barata: com a falta de GDDR7, ela é vendida por mais do dobro do preço de lançamento, e você ainda precisa do PC em volta. Se os seus modelos cabem em 32 GB, a 5090 ganha em velocidade; se não, o Spark (ou um Strix Halo) é quem carrega.
DGX Spark vs Mac Studio. Com 128 GB, o Mac Studio M5 Max tem a mesma capacidade, mais do dobro da largura de banda e custa menos. O que você perde é CUDA. Se você não precisa dela, o Mac Studio é a melhor máquina para gerar tokens localmente.
DGX Spark vs Strix Halo. Mesma capacidade, largura de banda parecida, menos da metade do preço. O Spark é claramente mais rápido para processar o prompt; na geração de tokens os dois andam quase juntos. Mais detalhes na próxima seção.
DGX Spark vs RTX Pro 6000. Outra categoria: 96 GB de memória dedicada com largura de banda muito maior, por mais do dobro do preço e dentro de um PC que você precisa montar. Se você está avaliando esse nível, veja nossas alternativas ao DGX Station (em inglês).
A alternativa da AMD
A AMD é a única fabricante que vende uma resposta direta à arquitetura do DGX Spark, e faz isso em duas faixas de preço.
GMKtec EVO-X2 (US$ 3.499,99) é a máquina barata de referência: Ryzen AI Max+ 395, 128 GB de memória unificada e uns 256 GB/s, 6% menos largura de banda que o Spark pela metade do preço. Os testes da própria GMKtec, publicados pelo TechRadar (em inglês), dão vantagem a ela na geração de tokens. O teste independente do The Register (em inglês), com o HP Z2 Mini G1a (mesmo chip), viu um ritmo de geração parecido, mas o Spark foi de 2 a 3 vezes mais rápido no processamento do prompt.
AMD Ryzen AI Halo Developer Platform (US$ 3.999) é a máquina oficial: os mesmos 128 GB, suporte da AMD e Windows, que o DGX Spark não oferece. É vendida com exclusividade na Micro Center desde 10 de julho de 2026.
A contrapartida nos dois casos não tem a ver com desempenho: você tem ROCm no lugar de CUDA. Ollama, llama.cpp e vLLM funcionam bem; NVIDIA NIM, TensorRT-LLM e NemoClaw não. Se o seu trabalho depende do software da NVIDIA, nenhuma máquina AMD substitui.
Existe um equivalente da AMD ao DGX Spark? Sim: um mini PC Strix Halo como o Bosgame M5 (US$ 3.099) ou o GMKtec EVO-X2 (US$ 3.499,99) pelo caminho barato, ou a Ryzen AI Halo Developer Platform da AMD por US$ 3.999 para ter suporte oficial e Windows. Todas igualam os 128 GB do Spark e ficam a menos de 6% da largura de banda dele. Nenhuma é compatível com CUDA.
O que dizem donos e testadores
O veredito de donos e testadores independentes é o mesmo desde o lançamento: o Spark é uma máquina de desenvolvimento para quem precisa de CUDA, não a opção mais econômica para rodar modelos. Três conclusões se repetem em fóruns de desenvolvedores e testes comparativos:
- Quem tem um EVO-X2 e um Spark vê a geração de tokens quase idêntica, com o Spark de 2 a 5 vezes mais rápido no processamento do prompt e melhor para PyTorch e vLLM.
- Pesquisadores com orçamento apertado defendem o Spark como máquina de prototipagem CUDA, e é para isso que ele serve, não como caixa de inferência.
- Em testes comparativos de vários dias, os tokens por segundo acompanharam a largura de banda de memória, e um Mac M5 no máximo deixou o Spark e o Strix Halo para trás.
Melhores modelos para o DGX Spark
Se você já tem um Spark, ou quer saber se 128 GB bastam antes de comprar, aqui está o resumo prático frente a esse limite de memória. Deixe uns 10-15 GB de folga acima dos pesos para o cache KV e o sistema operacional: um modelo que no papel cabe em 120 GB não cabe na prática.
Rodam com folga, com espaço para uma janela de contexto longa:
- Qwen 3.8 27B: denso, cerca de 17 GB em Q4. Medido a cerca de 11,4 tok/s sem decodificação especulativa e a 24-26 tok/s com decodificação especulativa MTP no vLLM (fórum de desenvolvedores da NVIDIA, em inglês). O Ollama não suporta MTP, então conte com o número mais baixo nele. A melhor escolha padrão para agentes num Spark.
- Gemma 4 31B: cerca de 17,5 GB em 4 bits (número do Google; não existe Gemma 4 27B). Muita folga, e uma segunda opção forte para agentes. Se estiver em dúvida entre Gemma e Qwen, comparamos os dois em Gemma 4 vs Qwen 3.6 (em inglês).
- Qwen 3.6 35B-A3B: MoE com só 3B de parâmetros ativos. O mais rápido desta categoria numa máquina limitada pela largura de banda, porque esse custo depende dos parâmetros ativos, não do total.
- Llama 3.3 70B em Q4_K_M: uns 43-49 GB, a cerca de 4-5 tokens por segundo. Cabe, mas é lento para um agente interativo.
Cabem, mas no limite:
- GPT-OSS 120B em MXFP4: cerca de 60 GB. A NVIDIA mediu cerca de 1.725 tok/s no pré-preenchimento e 55 tok/s na decodificação no Spark. De longe, a melhor capacidade por gigabyte da lista.
- Llama 3.3 70B em Q8_0: cerca de 70 GB de pesos. Carrega, mas quando uma janela de contexto real enche o cache KV você fica perto do limite. O Q4_K_M é a melhor escolha para quase todo mundo.
Não cabem:
- DeepSeek V4 e outros MoE da classe de 671B: centenas de gigabytes mesmo em Q4. Nuvem ou servidor com várias GPUs, não um desktop.
- Llama 3.1 405B: mais de 800 GB em precisão completa; em Q2/Q3 a qualidade cai tanto que um bom 70B ganha dele.
- GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5: não têm pesos abertos. Só por API, seja qual for o seu hardware.
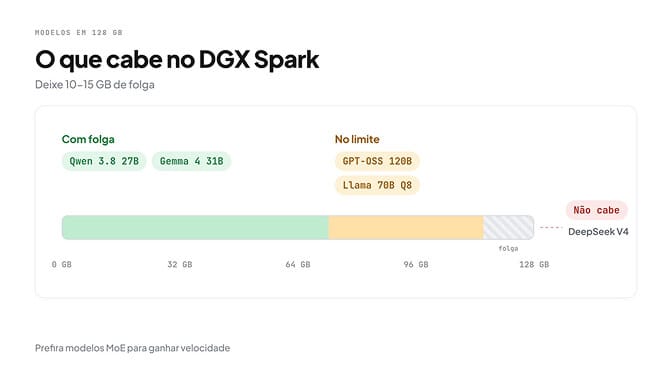
O limite que importa é a largura de banda (em inglês), não a capacidade. Nos 128 GB do Spark cabe um modelo de 70B, mas os 273 GB/s decidem a velocidade dos tokens. O truque prático é preferir modelos MoE: o Qwen 3.6 35B-A3B move 3B parâmetros por token em vez de 35B.
Mais uma coisa antes de escolher o modelo: a maioria dos donos de um Spark roda a inferência com o Ollama, e nem todo modelo do Ollama suporta chamadas de ferramentas, algo de que um agente precisa. A tabela completa de quais modelos do Ollama suportam ferramentas (em inglês) está no nosso guia.
Veredito: o que escolher para cada caso
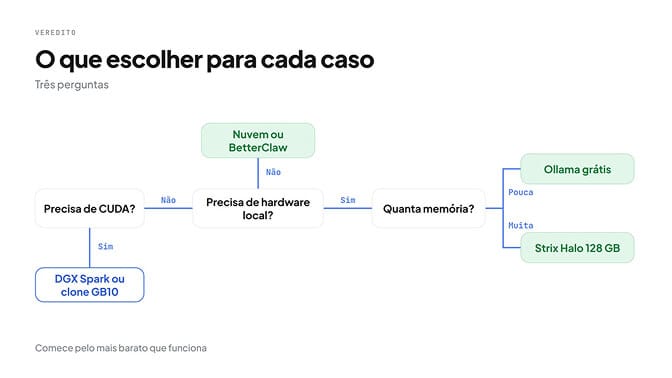
"Crio agentes de IA e quero o menor custo." Inferência na nuvem com o OpenRouter mais o plano gratuito do BetterClaw. De US$ 0 a 50 por mês. Sem hardware.
"Quero IA local por privacidade, mas não posso gastar US$ 6.950." Ollama no seu Mac ou PC atual, de graça. Ou um Bosgame M5 (US$ 3.099) como máquina dedicada de 128 GB, o caminho mais barato até a capacidade do Spark.
"Preciso de 128 GB de memória unificada e Windows." AMD Ryzen AI Halo (US$ 3.999). A mesma memória, US$ 2.951 a menos que o DGX Spark, e roda Windows.
"Preciso do ecossistema CUDA da NVIDIA." DGX Spark (US$ 6.950 com 128 GB, ou US$ 4.999 o modelo de 64 GB, à venda desde 23 de outubro). Num desktop com Linux, só ele e os clones GB10 oferecem CUDA com 128 GB de memória unificada. Se você aceita Windows e um notebook, um RTX Spark de 128 GB (uns US$ 5.900) fica a cerca de 7% dele em agentes.
"Quero a melhor experiência no Mac para IA local." Mac Studio M5 Max (a partir de US$ 2.499), ou M5 Ultra (a partir de US$ 5.499) para a geração de tokens mais rápida em cima da mesa, com 1,2 TB/s.
"Quero o mesmo chip do DGX Spark por menos." O ASUS Ascent GX10, comparando preços antes: mesmo GB10, mesmos 128 GB e CUDA, com suporte da ASUS.
"Já tenho um Spark e quero saber o que rodar." Qwen 3.8 27B para agentes em geral, GPT-OSS 120B em MXFP4 para a maior capacidade que cabe e Qwen 3.6 35B-A3B quando você quer velocidade.
"Ainda não sei e não quero me comprometer." Comece com inferência na nuvem. Use uma API. Crie primeiro o seu agente e otimize o modelo depois. O modelo dá para trocar. A lógica do agente é o que importa.
O Gartner prevê que 40% dos aplicativos corporativos terão agentes de IA específicos para tarefas até o fim de 2026, e a maioria vai rodar em APIs na nuvem, não em hardware de US$ 5.000 a 7.000. Em quem realmente precisa de um DGX Spark (em inglês) explicamos os quatro perfis que justificam a compra.
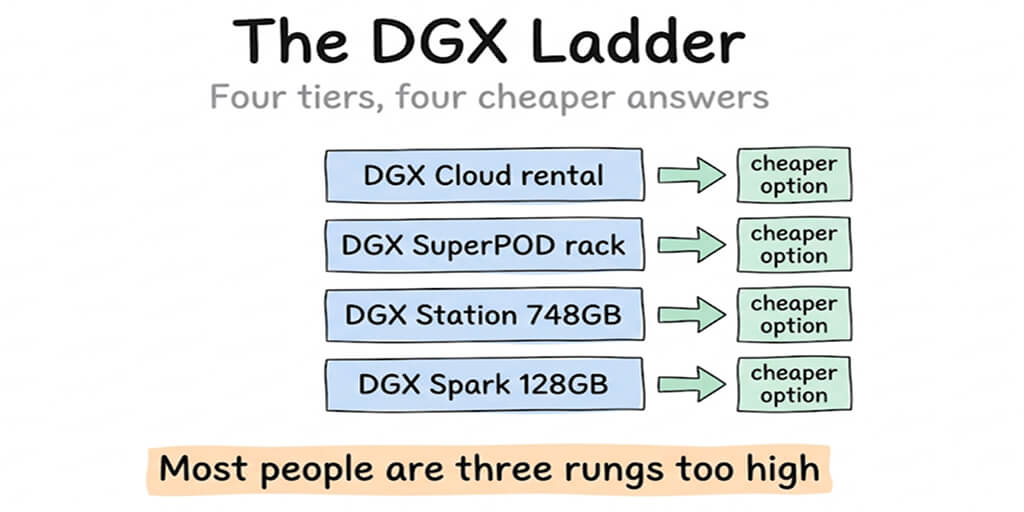
Esta página trata do Spark de mesa. Se você está avaliando toda a linha, o guia de alternativas à NVIDIA DGX (em inglês) cobre todos os níveis, do Spark ao SuperPOD.
Perguntas frequentes
O que é o DGX Spark?
O DGX Spark é o computador de mesa da NVIDIA para IA local, com o superchip GB10 Grace Blackwell, 128 GB de memória unificada e o software de IA da NVIDIA pré-instalado no DGX OS (Linux). Ele serve para desenvolver, ajustar e rodar modelos de até cerca de 200 bilhões de parâmetros na sua mesa, principalmente se o seu trabalho depende de CUDA. Não roda Windows.
Quanto custa o DGX Spark no Brasil?
Em 6 de outubro de 2026, o anúncio mais barato no KaBuM era de R$ 53.649 à vista ou 10x de R$ 5.364,90 sem juros, do vendedor parceiro Infotecdez importados USA, para o modelo de 128 GB e 4 TB. Um segundo vendedor parceiro, a EFACINI, anunciava a Founders Edition por R$ 59.779,90. Nos dois casos o site mostra "Sem Garantia", então confirme garantia e nota fiscal antes de comprar.
Vale a pena comprar o DGX Spark no Paraguai?
Quase nunca. Pela via terrestre, a cota de isenção da Receita Federal é de US$ 500 por pessoa a cada 30 dias, e o que passar paga 50% de imposto sobre o excedente. Pagando o preço oficial de US$ 6.950, o imposto seria de cerca de US$ 3.225, e você ainda ficaria sem garantia local.
DGX Spark ou RTX 5090 para IA local?
Depende do tamanho dos seus modelos. A RTX 5090 gera tokens muito mais rápido graças à largura de banda, mas os 32 GB dela não carregam modelos de 70B com contexto longo, e com a falta de memória ela já custa mais de US$ 4.000 nos Estados Unidos. O DGX Spark tem 128 GB de memória unificada e carrega modelos muito maiores, ainda que mais devagar.
DGX Spark ou Mac Studio?
Se você não precisa de CUDA, o Mac Studio. O M5 Max com 128 GB tem a mesma capacidade do Spark, mais do dobro da largura de banda (614 GB/s contra 273 GB/s) e custa US$ 5.399, US$ 1.551 a menos. Escolha o Spark só se o seu trabalho depende do software da NVIDIA.
Qual é a alternativa mais barata ao DGX Spark?
O Ollama no computador que você já tem, que é gratuito e roda modelos de até uns 30B com 32 GB de RAM. Se você precisa de uma máquina dedicada com os mesmos 128 GB, o Bosgame M5 (Strix Halo) custa US$ 3.099, menos da metade do Spark, mas não é compatível com CUDA. E se você quer agentes de IA, a inferência na nuvem custa entre US$ 0 e 50 por mês, sem hardware.