O OpenClaw não cobra nada. O modelo que faz ele pensar, às vezes cobra. Veja o que é grátis de verdade, qual modelo escolher para o seu caso, como trocar o modelo na configuração e o que cada provedor grátis faz com os seus dados.
Você instala o OpenClaw, conecta no Telegram, pede alguma coisa… e ele pede uma chave de API. “Mas não era grátis?” É. Só que um agente precisa de um modelo por trás, e é aí que aparecem as letras miúdas.
A boa notícia: dá para usar o OpenClaw sem pagar nada. A má: “grátis” quer dizer três coisas diferentes, e cada uma tem a sua pegadinha.
O OpenClaw é gratuito ou pago?
O OpenClaw é gratuito. É software open source: você baixa, instala e usa sem licença nem assinatura. O que pode custar dinheiro é:
- O modelo de IA. O OpenClaw não traz um modelo próprio. Ele usa o que você configurar: um modelo na nuvem (com chave de API) ou um modelo local no seu computador.
- O servidor. Se você quer o agente ligado 24 horas e não tem um computador sempre ligado, vai precisar de uma VPS ou de um serviço de hospedagem.
Se você roda o OpenClaw no seu próprio computador e usa um modelo grátis (de um plano gratuito na nuvem ou local com o Ollama), o custo total é zero. O detalhe é que o computador precisa ficar ligado para o agente responder: desligou, o agente desliga junto.
O resto deste artigo mostra qual modelo escolher para chegar nesse custo zero, e a partir de quando ele deixa de valer a pena.
Modelos grátis que funcionam hoje com o OpenClaw
| Modelo | Onde | Grátis? | Chamadas de ferramentas | Limites ou observações |
|---|---|---|---|---|
| Gemini 3.8 Flash | Google AI Studio | Sim, plano gratuito | Sim | O Google não publica limites fixos: você vê os do seu projeto no AI Studio |
| Qwen3.8-27B | Groq | Sim, plano gratuito | Sim | 30 requisições/min, 1.000/dia, 8.000 tokens/min, 200.000 tokens/dia |
| gpt-oss-120b | Groq | Sim, plano gratuito | Sim | Mesmos limites do Qwen3.8-27B no Groq |
| GLM-4.7-Flash | Z.ai | Sim | Sim | O GLM-5.3-Flash, mais novo, já é pago |
Modelos :free | OpenRouter | Sim | Sim, em 14 de 15 | 20 requisições/min; 50/dia, ou 1.000/dia se você já comprou pelo menos US$ 10 em créditos |
| Qwen3.8 27B | Ollama (local) | Sim, no seu computador | Sim | Download de 18 GB: conte com 24 GB ou mais |
| Qwen 3.5 9B | Ollama (local) | Sim, no seu computador | Sim | Cerca de 11 GB de VRAM segundo o Ollama: o mínimo confortável para 16 GB |
| Gemma 4 | Ollama (local) | Sim, no seu computador | Sim | Cerca de 16 GB de VRAM segundo o Ollama |
Conferido em 6 de outubro de 2026. Os planos gratuitos mudam com frequência: confira os limites no dia em que for configurar.
Os modelos mais baratos (quase de graça)
Se os planos gratuitos ficarem curtos, estes são os modelos pagos mais baratos que funcionam bem com agentes:
| Modelo | Preço por milhão de tokens (entrada / saída) | Por que vale a pena |
|---|---|---|
DeepSeek Flash (deepseek-flash) | US$ 0,15 / US$ 0,60 fora do horário de pico; US$ 0,30 / US$ 1,20 no pico | O modelo útil mais barato. Contexto de 1M e chamadas de ferramentas |
| GLM-5.3-Flash | US$ 0,15 / US$ 0,50 | Mesma faixa de preço do DeepSeek |
| Gemini 3.8 Flash (plano pago) | US$ 0,75 / US$ 3,75 até 31 de dezembro de 2026; US$ 1,50 / US$ 7,50 a partir de 1º de janeiro de 2027 | Mais limite que o plano gratuito, e seus dados não são usados para melhorar produtos |
Para ter uma ideia: um agente com 200 chamadas por dia, de uns 1.500 tokens de entrada e 500 de saída, custa cerca de US$ 3,15 por mês com o DeepSeek Flash fora do pico, sem contar o cache.
E o cache pesa bastante. Um agente reenvia quase o mesmo contexto a cada chamada, e o DeepSeek cobra a entrada em cache a US$ 0,003 por milhão fora do pico. No uso normal, a conta real costuma ficar abaixo dessa estimativa. Em todos esses modelos você usa a sua própria chave e paga direto ao provedor. Lembre que, pagando em dólar no cartão, entram o câmbio e o IOF.
Os três tipos de “grátis” (e por que isso importa)
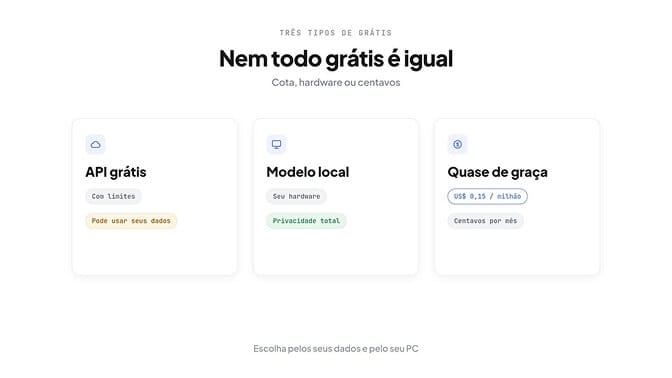
Tipo 1: planos gratuitos de API. Um provedor na nuvem dá uma cota sem cobrar. Em troca, você aceita limites, e em alguns casos seus dados podem ser usados para melhorar os modelos. Aqui entram Gemini, Groq, Z.ai e OpenRouter.
Tipo 2: modelos locais. Você roda o modelo no seu computador com o Ollama. Custo por token: zero. Privacidade total. Mas precisa de hardware: 16 GB no mínimo para algo usável, e a qualidade com ferramentas varia muito.
Tipo 3: quase de graça. Modelos pagos tão baratos que o uso pessoal custa centavos, como o DeepSeek Flash. Não é zero, mas para muita gente a diferença é irrelevante.
A maioria dos guias de “melhor modelo grátis” mistura os três tipos sem avisar. E as pegadinhas de cada um são completamente diferentes.
1. Gemini 3.8 Flash: o melhor plano grátis
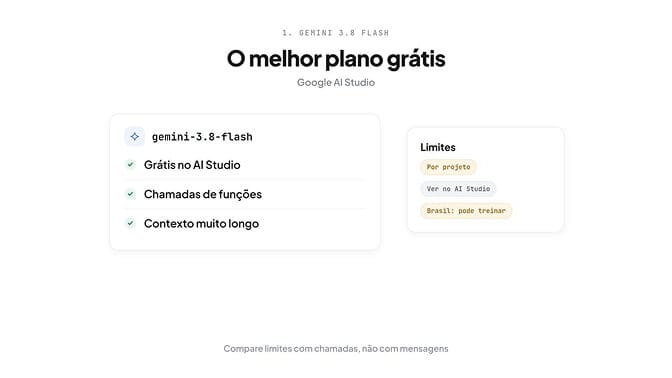
O Gemini 3.8 Flash (gemini-3.8-flash) é o modelo Flash mais recente do Google e está no plano gratuito: a página de preços marca entrada e saída como “free of charge” gratuito. Ele suporta chamadas de funções, que é o que um agente precisa. O antigo Gemini 3 Flash só existe como gemini-3-flash-preview, e o Google já chama ele de “legacy Flash model” modelo Flash legado: aponte o OpenClaw para o 3.8 Flash.
Um aviso que quase todo guia ignora: o Google não publica mais limites fixos para o plano gratuito. A página de limites diz que eles dependem de vários fatores e não são garantidos. O único número confiável é o que aparece no seu projeto no Google AI Studio.
Lembre também que cada mensagem para o agente gera várias chamadas de API (raciocinar, usar ferramentas, responder). Compare seus limites com chamadas, não com mensagens.
Onde funciona: tarefas simples de agente, arquivos, agenda, perguntas e respostas, navegação na web. Para um assistente pessoal que responde algumas mensagens por dia, o plano gratuito costuma bastar.
Onde fica devendo: raciocínio complexo de muitas etapas. E como o Google não garante a capacidade gratuita, não monte nada crítico para o seu negócio em cima dele.
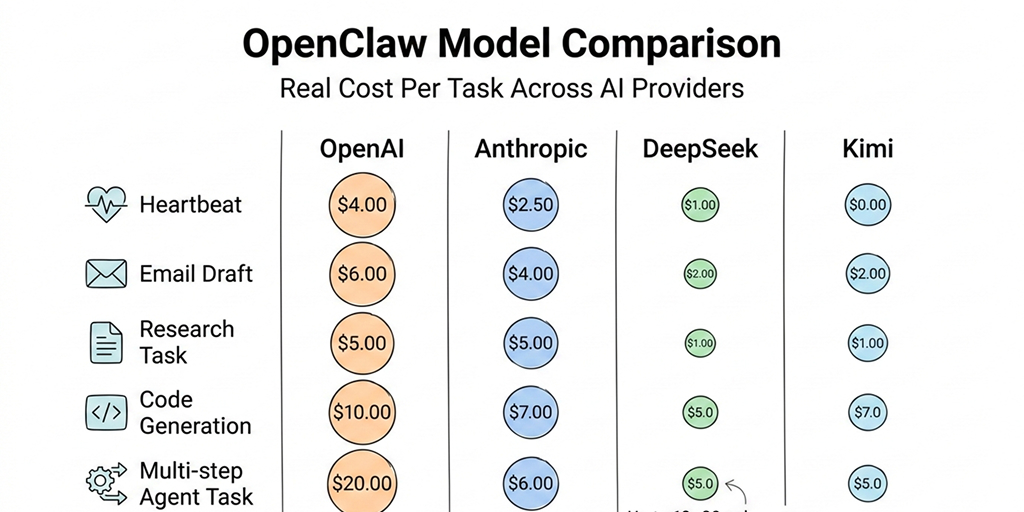
Para configurar no OpenClaw: pegue uma chave no Google AI Studio, salve como GEMINI_API_KEY e use o modelo google/gemini-3.8-flash. Para a comparação completa com modelos pagos, veja nossa comparação de modelos para o OpenClaw (em inglês).
2. Qwen3.8-27B no Groq
O segundo lugar fica com o Qwen3.8-27B no plano gratuito do Groq (qwen/qwen3.8-27b), o mesmo modelo que também é a melhor opção local mais abaixo.
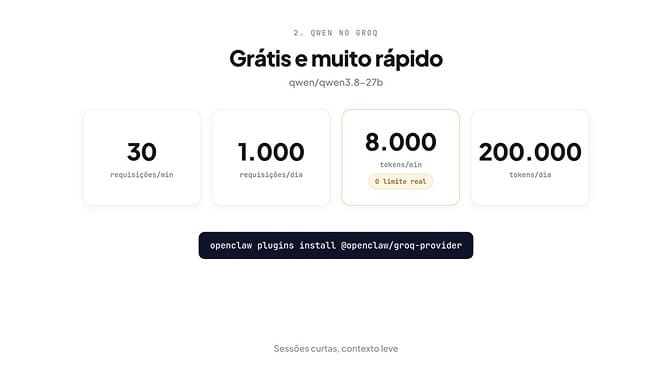
O Groq publica os limites gratuitos, o que é raro, e só pede um meio de pagamento se você subir para o plano de desenvolvedor. Para este modelo, são 30 requisições por minuto, 1.000 por dia, 8.000 tokens por minuto e 200.000 tokens por dia. Os mesmos limites valem para o openai/gpt-oss-120b, uma boa segunda chave se a cota diária acabar.
Onde funciona: sessões em que a velocidade importa, programação e tarefas com muitas ferramentas.
Onde fica devendo: o limite de 8.000 tokens por minuto é o que aperta de verdade. O OpenClaw envia em cada chamada o prompt de sistema, as definições de ferramentas e o histórico, então uma sessão longa pode bater no limite em uma ou duas rodadas. Mantenha o contexto enxuto, ou use o Groq para sessões curtas e o Gemini para as longas.
Para configurar no OpenClaw: o Groq é um plugin oficial instalado à parte:
openclaw plugins install @openclaw/groq-provider
export GROQ_API_KEY="sua_chave_do_groq"
Depois, use o modelo groq/qwen/qwen3.8-27b. Quando os planos gratuitos acabarem, nosso guia dos provedores mais baratos para o OpenClaw (em inglês) compara as opções pagas.
3. Melhor modelo local para o OpenClaw (Ollama)
Com o Ollama, o modelo roda no seu computador: custo zero por token, nenhum dado sai da sua máquina, sem limites nem cotas.
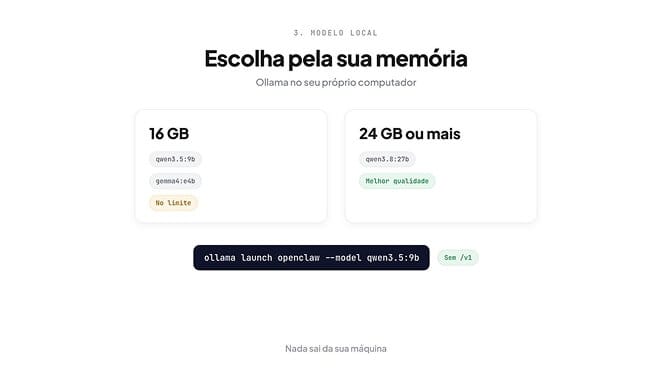
O tamanho importa mais do que parece, porque o download são só os pesos e a memória do contexto vem por cima. Segundo o guia do OpenClaw no Ollama, o qwen3.5 precisa de cerca de 11 GB de VRAM e o gemma4 de cerca de 16 GB.
| Modelo | Tag do Ollama | Para qual máquina | Melhor para |
|---|---|---|---|
| Qwen3.8 27B | qwen3.8:27b | 24 GB ou mais (download de 18 GB, contexto de 256K) | O melhor modelo local no geral |
| Qwen 3.5 9B | qwen3.5:9b | 16 GB | Máquinas modestas |
| Gemma 4 E4B | gemma4:e4b | 16 GB, no limite | Alternativa em 16 GB |
Todos têm a tag de ferramentas no Ollama. A instalação é um comando, e o Ollama configura o provedor do OpenClaw para você:
ollama launch openclaw --model qwen3.5:9b
Se for configurar na mão, use o provedor nativo do Ollama com baseUrl: "http://127.0.0.1:11434", sem /v1. A documentação do OpenClaw avisa: a URL compatível com a OpenAI quebra as chamadas de ferramentas. Modelos com menos de 7B, em geral, não chamam ferramentas de forma confiável. Se um modelo local não responder direito, veja nosso guia de problemas com modelos locais (em inglês). E se você está pensando em comprar hardware para IA local, leia antes nossas alternativas ao DGX Spark.
O OpenClaw funciona sem internet?
Sim, com ressalvas. Se o modelo é local (Ollama), o OpenClaw pode funcionar sem conexão: o gateway roda no seu computador e o painel de controle fica em http://127.0.0.1:18789. O que não funciona sem internet é tudo o que vive fora: os canais de mensagem (Telegram, Slack, Discord), a busca na web e qualquer modelo na nuvem.
4. DeepSeek Flash: melhor custo-benefício
O DeepSeek não é grátis, mas é o passo mais barato quando um plano gratuito fica curto.
Em 10 de setembro de 2026, a DeepSeek lançou o DeepSeek-V4.1-Flash e mudou o nome do modelo na API para deepseek-flash. O V4-Flash foi aposentado: o nome antigo deepseek-v4-flash ainda é aceito, mas quem responde é o V4.1-Flash.
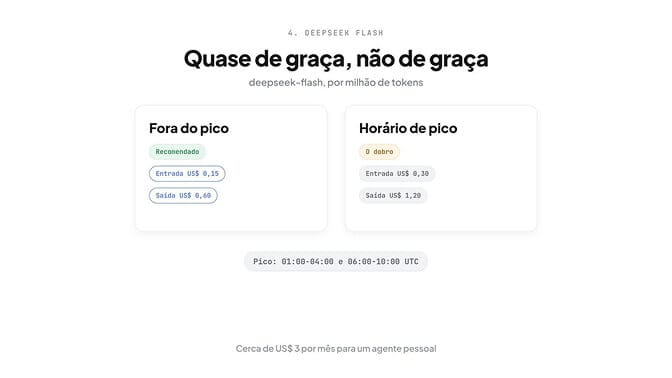
Os preços: US$ 0,15 / US$ 0,60 por milhão de tokens de entrada e saída fora do pico, e US$ 0,30 / US$ 1,20 no pico. O horário de pico é das 01:00 às 04:00 e das 06:00 às 10:00 UTC, de segunda a sexta, ou seja, das 22:00 à 01:00 e das 03:00 às 07:00 no horário de Brasília. O resto do tempo é tarifa reduzida. Tem contexto de 1M e chamadas de ferramentas.
Onde funciona: quase tudo. O custo-benefício é difícil de bater, e com contexto de 1M ele aguenta sessões longas sem perder o fio. Para classificar mensagens, resumir ou fazer triagem, sobra.
A pegadinha: você precisa de saldo carregado, então precisa de um cartão. E o pico custa o dobro, então agende o trabalho pesado fora dessas faixas.
5. Modelos grátis do OpenRouter
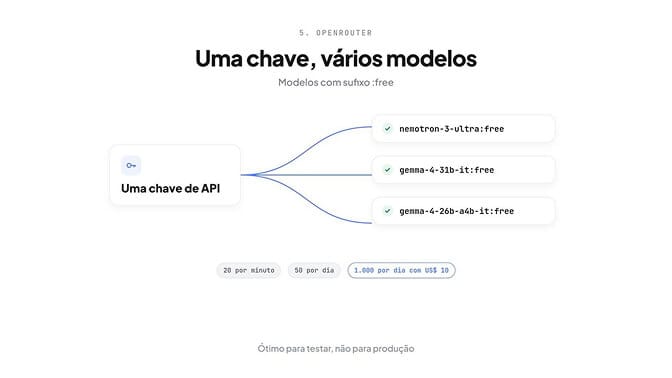
O OpenRouter reúne modelos de vários provedores numa chave só. Os modelos com o sufixo :free não custam nada.
Os limites estão publicados: 20 requisições por minuto, e 50 por dia se você comprou menos de US$ 10 em créditos no total, ou 1.000 por dia a partir de US$ 10. Cinquenta requisições são só um punhado de mensagens de agente, então esses US$ 10 são, na prática, o preço de tornar o :free usável com o OpenClaw.
Em 6 de outubro de 2026 havia 15 modelos :free, e 14 deles suportavam ferramentas. Os mais interessantes para agentes:
nvidia/nemotron-3-ultra-550b-a55b:free: o maior dos gratuitos (550B no total, 55B ativos), para etapas de raciocínio difíceis.google/gemma-4-31b-it:free: o melhor Gemma 4 denso, bom também com imagens.google/gemma-4-26b-a4b-it:free: Gemma 4 MoE, mais rápido.
Atenção: o qwen/qwen3.8-27b:free não aparece mais no catálogo gratuito. Se ele estava na sua configuração, troque.
Onde funciona: testar modelos novos sem criar conta em cada provedor.
Onde fica devendo: a disponibilidade muda sem aviso, e as filas no pico podem deixar o agente lento. Para um agente em produção, prefira um modelo pago no OpenRouter ou uma chave direta do provedor, que não some de um dia para o outro.
Modelos que não recomendamos
Qwen via OAuth. Era uma das opções grátis mais populares e não existe mais: a equipe do Qwen cortou a cota de 1.000 para 100 requisições por dia e fechou de vez o acesso gratuito por OAuth em 15 de abril de 2026. Se um guia antigo mandar você fazer login com o Qwen OAuth, pule. Hoje, os caminhos grátis para o Qwen são o Groq ou o Ollama.
GLM-5.3-Flash em loops de agente, sem testar antes. É um modelo muito capaz e barato (US$ 0,15 / US$ 0,50), mas no Hugging Face há relatos de usuários com loops de raciocínio e respostas repetidas em tarefas de agente. Se for usar, coloque um limite de raciocínio e teste com a sua própria carga de trabalho. Para algo que funcione sem surpresas, o qwen3.8:27b é a opção mais segura.
Qualquer modelo local com menos de 7B. Nesse tamanho, as chamadas de ferramentas falham ou nem existem: o agente descreve a tarefa em vez de executar. Se for local, comece no qwen3.5:9b. Nossa análise do Qwen com o Ollama (em inglês) mostra o que roda bem localmente e o que não roda.
Como trocar ou configurar o modelo no OpenClaw
A configuração do OpenClaw fica num arquivo JSON5 em ~/.openclaw/openclaw.json. O modelo é definido por três chaves:
| Chave | Para que serve |
|---|---|
agents.defaults.model.primary | O modelo principal do agente |
agents.defaults.model.fallbacks | Uma lista de modelos reserva, testados em ordem se o principal falhar |
agents.defaults.subagents.model | O modelo dos subagentes; vale usar um barato |
Este exemplo coloca o Gemini 3.8 Flash como principal, o Qwen no Groq como primeira reserva e um modelo local do Ollama como última, e usa um modelo pequeno do Groq para os subagentes:
{
  agents: {
    defaults: {
      model: {
        primary: "google/gemini-3.8-flash",
        fallbacks: ["groq/qwen/qwen3.8-27b", "ollama/qwen3.8:27b"],
      },
      subagents: { model: "groq/openai/gpt-oss-20b" },
    },
  },
}
Testamos em 6 de outubro de 2026 no OpenClaw 2026.9.8: o openclaw config validate considera a configuração válida. Para ver o que está configurado:
openclaw config get agents.defaults.model
openclaw models status
O openclaw models status mostra o modelo principal e as reservas. Um aviso: o openclaw config show não existe, mesmo que apareça em guias antigos.
Se preferir não mexer no arquivo, openclaw models set google/gemini-3.8-flash troca o modelo principal, e openclaw models fallbacks add <provedor/modelo> adiciona uma reserva. Para a configuração completa do Ollama (bloco do provedor, rota nativa, janela de contexto), veja nosso guia do OpenClaw com Ollama (em inglês).
E se toda essa configuração de provedores e chaves parecer trabalho demais, é justamente essa parte que resolvemos no BetterClaw (em inglês): você escolhe o modelo numa lista, com as suas próprias chaves, sem servidor para manter. Os planos começam em US$ 19 por mês.
Privacidade: o que cada provedor grátis faz com seus dados
O preço do “grátis” às vezes aparece na coluna da privacidade.
| Provedor | O que acontece com seus dados no plano gratuito |
|---|---|
| Google AI Studio (Gemini) | No Brasil, o Google usa o que você envia no plano gratuito para melhorar os produtos dele, e revisores humanos podem ler. Só no Espaço Econômico Europeu, na Suíça e no Reino Unido as regras do plano pago valem também para o gratuito (termos da Gemini API). |
| Groq | Por padrão, não guarda os dados das requisições de inferência, salvo registros temporários (até 30 dias) para resolver problemas ou investigar abusos. Dá para ativar o Zero Data Retention em Data Controls (política do Groq). |
OpenRouter :free | A requisição vai para o provedor que serve aquele modelo, então depende da política dele. Confira o provedor ou limite os provedores nas configurações de privacidade do OpenRouter. |
| DeepSeek (pago) | Os dados são processados na infraestrutura da DeepSeek na China. A preocupação costuma ser a residência dos dados. |
| Ollama (local) | Nada sai do seu computador. A opção mais privada. |
Isso pesa para quem está no Brasil: o plano gratuito do Gemini pode usar seus prompts para melhorar os produtos do Google, e o próprio Google pede que você não envie informações sensíveis, confidenciais ou pessoais para os serviços gratuitos. Se você lida com código proprietário, dados de clientes ou algo sujeito à LGPD, use o Ollama ou um plano pago nessas tarefas.
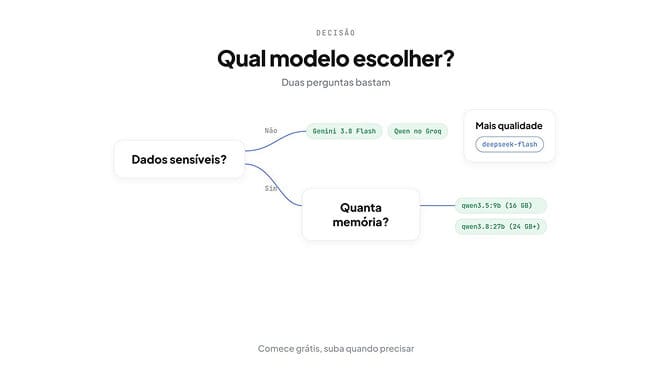
Qual modelo escolher?
| Seu caso | Privacidade? | Hardware? | Escolha |
|---|---|---|---|
| Assistente pessoal, pouco volume | Não | Não | Gemini 3.8 Flash (plano gratuito) |
| Respostas rápidas, sessões curtas | Não | Não | Qwen3.8-27B no Groq |
| Dados sensíveis | Sim | 24 GB ou mais | Ollama + qwen3.8:27b |
| Máquina de 16 GB, sem internet | Sim | 16 GB | Ollama + qwen3.5:9b |
| Mais qualidade, pouco orçamento | Não | Não | DeepSeek deepseek-flash (pago) |
| Testar vários modelos | Não | Não | OpenRouter :free |
Nossa recomendação: comece com o plano gratuito do Gemini 3.8 Flash, adicione o Qwen no Groq como segunda chave rápida, vá para o Ollama se a privacidade for obrigatória e você tiver a máquina, e quando os limites gratuitos atrapalharem, suba para o DeepSeek Flash.
E uma verdade incômoda: modelos grátis funcionam para uso pessoal, aprendizado e testes, mas quando o agente importa para o seu negócio, a diferença de qualidade, confiabilidade e privacidade para um modelo pago é real. Muita gente começa no grátis e em menos de um mês está no DeepSeek ou num modelo intermediário.
Perguntas frequentes
O OpenClaw é gratuito?
Sim. O OpenClaw é software open source e não custa nada. O que pode custar é o modelo de IA que você conecta e, se quiser o agente ligado 24 horas, o servidor. Com um modelo grátis (Gemini 3.8 Flash, Qwen no Groq ou um modelo local com o Ollama) e o seu próprio computador, o custo total é zero.
Qual o melhor modelo grátis para o OpenClaw?
O Gemini 3.8 Flash (gemini-3.8-flash) no plano gratuito do Google AI Studio: não precisa pagar e suporta chamadas de funções. O Google não publica limites fixos, então confira os do seu projeto no AI Studio. A segunda melhor opção é o Qwen3.8-27B no plano gratuito do Groq, com 1.000 requisições por dia.
Como trocar o modelo no OpenClaw?
Edite agents.defaults.model.primary em ~/.openclaw/openclaw.json, ou rode openclaw models set <provedor/modelo>, por exemplo openclaw models set google/gemini-3.8-flash. Você pode adicionar modelos reserva em agents.defaults.model.fallbacks. Para conferir o resultado, use openclaw models status.
Dá para usar a API do OpenClaw de graça?
O OpenClaw não tem uma API paga própria: ele usa a chave do provedor que você escolher. Dá para usar de graça com chaves dos planos gratuitos do Google AI Studio (Gemini 3.8 Flash), do Groq (Qwen3.8-27B) ou do OpenRouter (modelos :free), ou sem chave nenhuma com um modelo local no Ollama. Só fique de olho nos limites de cada plano gratuito.
O OpenClaw funciona com Ollama?
Sim. O comando ollama launch openclaw --model qwen3.5:9b instala e configura tudo. Se configurar na mão, use o provedor nativo do Ollama com baseUrl: "http://127.0.0.1:11434", sem /v1, porque a URL compatível com a OpenAI quebra as chamadas de ferramentas. Com 24 GB ou mais, o qwen3.8:27b é o melhor modelo local.
O OpenClaw é seguro?
Pode ser, se você mantiver ele atualizado e não expuser na internet sem proteção. Em janeiro de 2026 foi corrigida uma falha grave (CVE-2026-25253, CVSS 8,8) que permitia executar código com um único clique, então não use versões anteriores à 2026.1.29. Instale só skills de confiança e lembre que, num modelo grátis na nuvem, seus dados saem do seu computador.