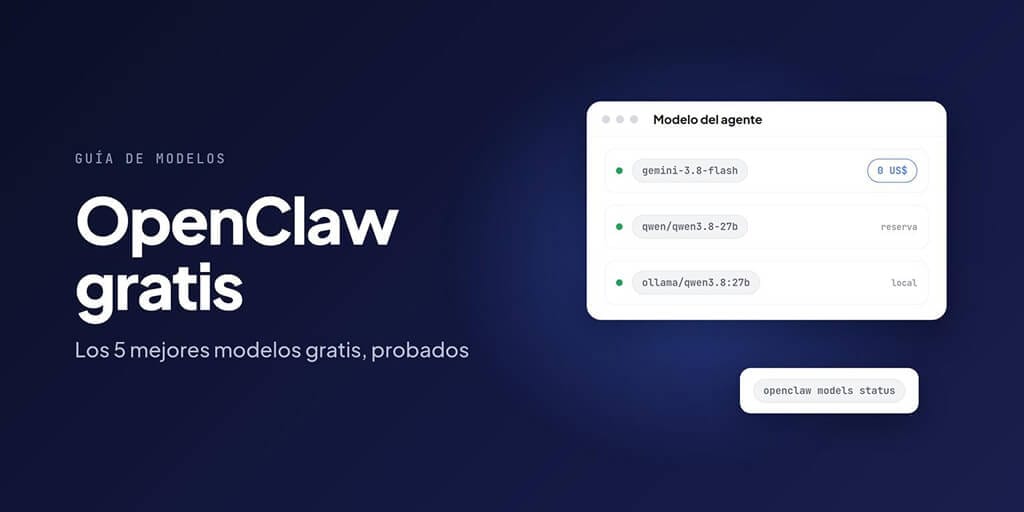
OpenClaw no te cobra nada. El modelo que lo hace pensar, a veces sí. Aquí tienes qué es gratis de verdad, qué modelo elegir según tu caso, cómo cambiarlo en la configuración y qué hace cada proveedor gratis con tus datos.
Instalas OpenClaw, lo conectas a Telegram, le pides algo… y te pide una clave de API. “¿No era gratis?” Lo es. Pero un agente necesita un modelo detrás, y ahí es donde aparece la letra pequeña.
La buena noticia: hay formas reales de usar OpenClaw sin pagar nada. La mala: “gratis” significa tres cosas distintas, y cada una tiene su trampa.
¿OpenClaw es gratis o de pago?
OpenClaw es gratis. Es software de código abierto: lo descargas, lo instalas y lo usas sin licencia ni suscripción. Lo que sí puede costar dinero es:
- El modelo de IA. OpenClaw no trae un modelo propio. Usa el que configures: uno en la nube (con clave de API) o uno local en tu propio equipo.
- El servidor. Si quieres que tu agente esté encendido 24/7 y no tienes un equipo siempre prendido, necesitarás un VPS o un servicio de alojamiento.
Si ejecutas OpenClaw en tu propio ordenador y usas un modelo gratis (de un plan gratuito en la nube o local con Ollama), el coste total es cero. La pega es que tu ordenador tiene que estar encendido para que el agente responda: si lo apagas, el agente se apaga con él.
El resto de este artículo te dice qué modelo elegir para conseguir ese coste cero, y en qué momento deja de compensar.
Modelos gratis que funcionan hoy con OpenClaw
| Modelo | Dónde | ¿Gratis? | Llamadas a herramientas | Límites o notas |
|---|---|---|---|---|
| Gemini 3.8 Flash | Google AI Studio | Sí, plan gratuito | Sí | Google no publica límites fijos: los ves en tu proyecto de AI Studio |
| Qwen3.8-27B | Groq | Sí, plan gratuito | Sí | 30 peticiones/min, 1.000/día, 8.000 tokens/min, 200.000 tokens/día |
| gpt-oss-120b | Groq | Sí, plan gratuito | Sí | Mismos límites que Qwen3.8-27B en Groq |
| GLM-4.7-Flash | Z.ai | Sí | Sí | El nuevo GLM-5.3-Flash ya es de pago |
Modelos :free | OpenRouter | Sí | Sí, en 14 de 15 | 20 peticiones/min; 50/día, o 1.000/día si compraste al menos 10 US$ de créditos |
| Qwen3.8 27B | Ollama (local) | Sí, en tu equipo | Sí | Descarga de 18 GB: cuenta con 24 GB o más |
| Qwen 3.5 9B | Ollama (local) | Sí, en tu equipo | Sí | Unos 11 GB de VRAM según Ollama: el mínimo cómodo para 16 GB |
| Gemma 4 | Ollama (local) | Sí, en tu equipo | Sí | Unos 16 GB de VRAM según Ollama |
Comprobado el 6 de octubre de 2026. Los planes gratuitos cambian a menudo: revisa los límites el día que configures.
Los modelos más baratos (casi gratis)
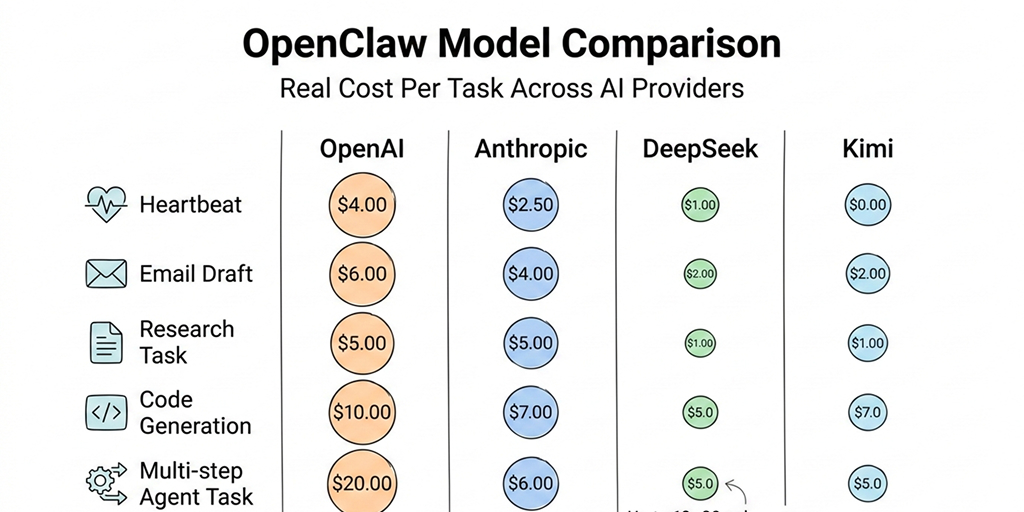
Si los planes gratuitos se te quedan cortos, estos son los modelos de pago más baratos que funcionan bien con agentes:
| Modelo | Precio por millón de tokens (entrada / salida) | Por qué vale la pena |
|---|---|---|
DeepSeek Flash (deepseek-flash) | 0,15 / 0,60 US$ fuera de hora punta; 0,30 / 1,20 US$ en hora punta | El modelo útil más barato. Contexto de 1M y llamadas a herramientas |
| GLM-5.3-Flash | 0,15 / 0,50 US$ | Mismo rango de precio que DeepSeek |
| Gemini 3.8 Flash (plan de pago) | 0,75 / 3,75 US$ hasta el 31 de diciembre de 2026; 1,50 / 7,50 US$ desde el 1 de enero de 2027 | Más límite que el plan gratuito y tus datos no se usan para mejorar productos |
Para hacerte una idea: un agente con 200 llamadas al día, de unos 1.500 tokens de entrada y 500 de salida, cuesta unos 3,15 US$ al mes con DeepSeek Flash fuera de hora punta, sin contar la caché.
Y la caché cuenta mucho. Un agente reenvía casi el mismo contexto en cada llamada, y DeepSeek cobra la entrada en caché a 0,003 US$ por millón fuera de hora punta. Con un uso normal, la factura real suele quedar por debajo de esa estimación. Con cualquiera de estos modelos usas tu propia clave y pagas directamente al proveedor.
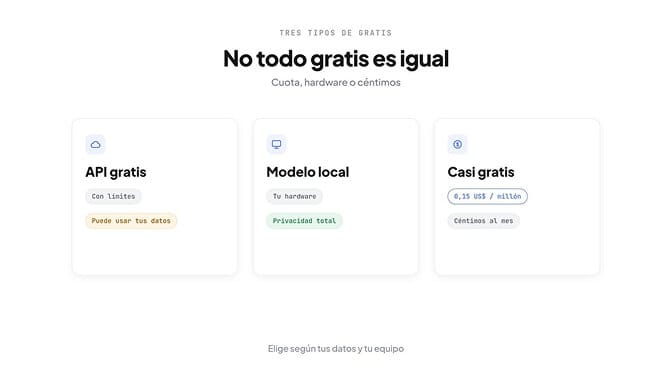
Los tres tipos de “gratis” (y por qué importa)
Tipo 1: planes gratuitos de API. Un proveedor en la nube te da una cuota sin pagar. A cambio aceptas límites, y en algunos casos tus datos pueden usarse para mejorar sus modelos. Aquí entran Gemini, Groq, Z.ai y OpenRouter.
Tipo 2: modelos locales. Ejecutas el modelo en tu propio equipo con Ollama. Coste por token: cero. Privacidad total. Pero necesitas hardware: 16 GB como mínimo para algo usable, y la calidad con herramientas varía mucho.
Tipo 3: casi gratis. Modelos de pago tan baratos que un uso personal cuesta céntimos, como DeepSeek Flash. No es cero, pero para mucha gente la diferencia es irrelevante.
La mayoría de guías de “el mejor modelo gratis” mezclan los tres tipos sin decírtelo. Y sus trampas son completamente distintas.
1. Gemini 3.8 Flash: el mejor plan gratis
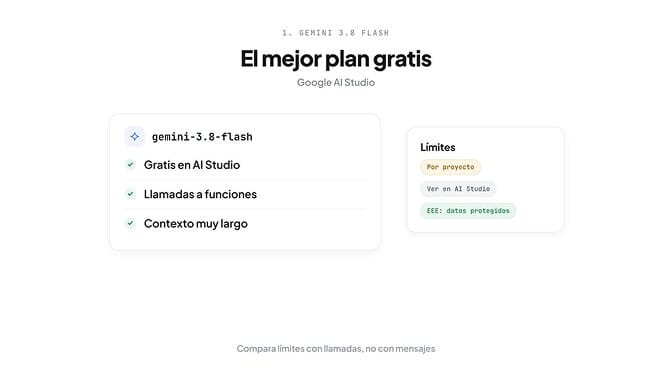
Gemini 3.8 Flash (gemini-3.8-flash) es el modelo Flash más reciente de Google y está en el plan gratuito: la página de precios lo marca como “free of charge” gratis tanto en entrada como en salida. Soporta llamadas a funciones, que es lo que necesita un agente. El antiguo Gemini 3 Flash solo existe como gemini-3-flash-preview, y Google lo llama ya su “legacy Flash model” modelo Flash heredado: apunta OpenClaw a 3.8 Flash.
Un aviso que casi todas las guías ignoran: Google ya no publica límites fijos para el plan gratuito. Su página de límites dice que dependen de varios factores y que no están garantizados. El único número fiable es el que ves en tu propio proyecto en Google AI Studio.
Recuerda también que cada mensaje a tu agente genera varias llamadas a la API (razonar, usar herramientas, responder). Compara tus límites con llamadas, no con mensajes.
Dónde funciona: tareas sencillas de agente, archivos, calendario, preguntas y respuestas, navegación web. Para un asistente personal que responde unos cuantos mensajes al día, el plan gratuito suele bastar.
Dónde se queda corto: razonamiento complejo de muchos pasos. Y como Google no garantiza la capacidad gratuita, no montes nada crítico para tu negocio encima.
Para configurarlo en OpenClaw: consigue una clave en Google AI Studio, guárdala como GEMINI_API_KEY y usa el modelo google/gemini-3.8-flash. Si quieres la comparativa completa con modelos de pago, la tienes en nuestra comparativa de modelos para OpenClaw (en inglés).
2. Qwen3.8-27B en Groq
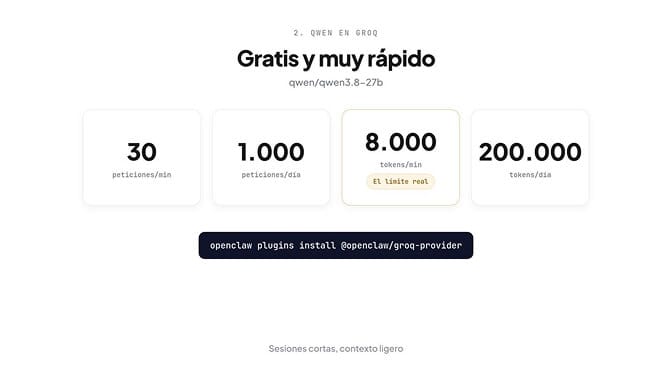
El segundo puesto es para Qwen3.8-27B en el plan gratuito de Groq (qwen/qwen3.8-27b), el mismo modelo que también es la mejor opción local más abajo.
Groq publica sus límites gratuitos, algo poco habitual, y solo te pide un método de pago si subes a su plan de desarrollador. Para este modelo son 30 peticiones por minuto, 1.000 al día, 8.000 tokens por minuto y 200.000 tokens al día. Los mismos límites valen para openai/gpt-oss-120b, que es una buena segunda clave si se te acaba la cuota diaria.
Dónde funciona: sesiones donde importa la velocidad, programación y tareas con muchas herramientas.
Dónde se queda corto: el límite de 8.000 tokens por minuto es el que de verdad aprieta. OpenClaw envía en cada llamada el prompt del sistema, las definiciones de herramientas y el historial, así que una sesión larga puede chocar con el límite en una o dos vueltas. Mantén el contexto corto, o usa Groq para sesiones cortas y Gemini para las largas.
Para configurarlo en OpenClaw: Groq es un plugin oficial que se instala aparte:
openclaw plugins install @openclaw/groq-provider
export GROQ_API_KEY="tu_clave_de_groq"
Después usa el modelo groq/qwen/qwen3.8-27b. Cuando se te acaben los planes gratuitos, nuestra guía de los proveedores más baratos para OpenClaw (en inglés) compara las opciones de pago.
3. Mejor modelo local para OpenClaw (Ollama)
Con Ollama, el modelo corre en tu equipo: cero coste por token, ningún dato sale de tu máquina, sin límites ni cuotas.
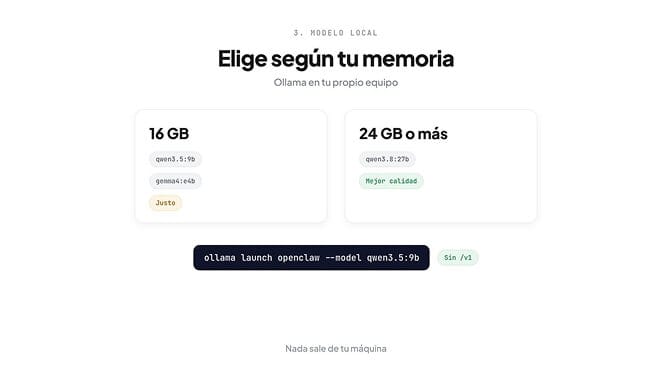
El tamaño importa más de lo que parece, porque la descarga solo son los pesos y la memoria del contexto va aparte. Según la guía de OpenClaw de Ollama, qwen3.5 necesita unos 11 GB de VRAM y gemma4 unos 16 GB.
| Modelo | Etiqueta de Ollama | Para qué equipo | Mejor para |
|---|---|---|---|
| Qwen3.8 27B | qwen3.8:27b | 24 GB o más (descarga de 18 GB, contexto de 256K) | El mejor modelo local en general |
| Qwen 3.5 9B | qwen3.5:9b | 16 GB | Equipos modestos |
| Gemma 4 E4B | gemma4:e4b | 16 GB, justo | Alternativa en 16 GB |
Todos están etiquetados para herramientas en Ollama. La instalación es un comando, y Ollama configura el proveedor de OpenClaw por ti:
ollama launch openclaw --model qwen3.5:9b
Si lo configuras a mano, usa el proveedor nativo de Ollama con baseUrl: "http://127.0.0.1:11434", sin /v1. La documentación de OpenClaw lo advierte: la URL compatible con OpenAI rompe las llamadas a herramientas. Los modelos de menos de 7B, en general, no llaman herramientas de forma fiable. Y si estás pensando en comprar hardware para IA local, antes lee nuestras alternativas a DGX Spark. Si un modelo local no responde bien, mira nuestra guía de problemas con modelos locales (en inglés).
¿OpenClaw funciona sin internet?
Sí, con matices. Si el modelo es local (Ollama), OpenClaw puede funcionar sin conexión: el gateway corre en tu equipo y tienes su panel de control en http://127.0.0.1:18789. Lo que no funciona sin internet es todo lo que vive fuera: los canales de mensajería (Telegram, Slack, Discord), la búsqueda web y cualquier modelo en la nube.
4. DeepSeek Flash: el mejor precio por calidad
DeepSeek no es gratis, pero es el paso más barato cuando un plan gratuito se te queda corto.
El 10 de septiembre de 2026 DeepSeek lanzó DeepSeek-V4.1-Flash y cambió el nombre del modelo en la API a deepseek-flash. V4-Flash está retirado: el nombre antiguo deepseek-v4-flash todavía se acepta, pero lo sirve V4.1-Flash.
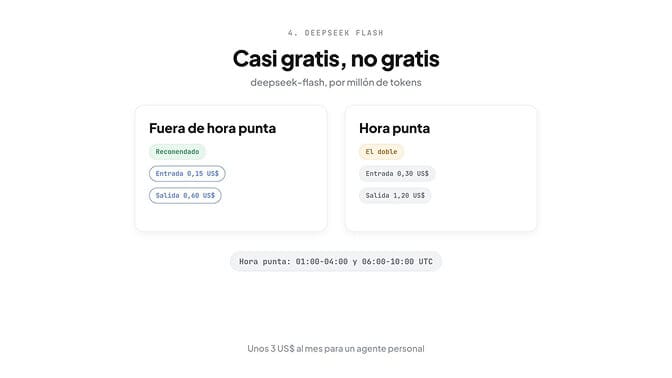
Los precios: 0,15 / 0,60 US$ por millón de tokens de entrada y salida fuera de hora punta, y 0,30 / 1,20 US$ en hora punta. La hora punta es de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes; el resto del tiempo es tarifa reducida. Tiene contexto de 1M y llamadas a herramientas.
Dónde funciona: casi todo. Su relación calidad-precio es difícil de batir, y con contexto de 1M aguanta sesiones largas sin perder el hilo. Para clasificar mensajes, resumir o hacer triaje, va sobrado.
La trampa: necesitas saldo cargado, así que hace falta una tarjeta. Y la hora punta cuesta el doble, así que programa el trabajo pesado fuera de esas franjas.
5. Modelos gratis de OpenRouter
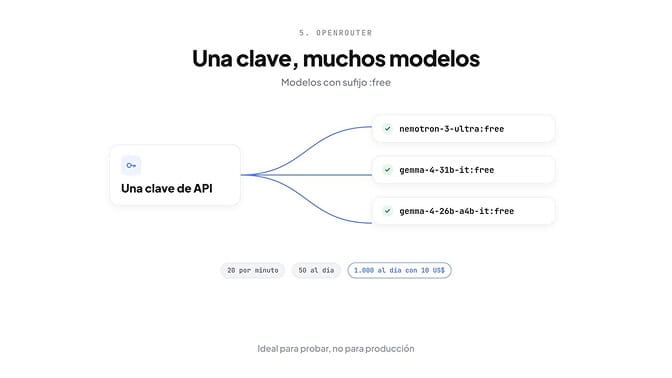
OpenRouter reúne modelos de muchos proveedores bajo una sola clave. Los modelos con el sufijo :free no cuestan nada.
Los límites están publicados: 20 peticiones por minuto, y 50 al día si has comprado menos de 10 US$ de créditos en total, o 1.000 al día a partir de 10 US$. Cincuenta peticiones son solo un puñado de mensajes de agente, así que esos 10 US$ son en la práctica el precio de hacer usable el plan :free con OpenClaw.
El 6 de octubre de 2026 había 15 modelos :free, y 14 de ellos soportaban herramientas. Los más interesantes para agentes:
nvidia/nemotron-3-ultra-550b-a55b:free: el más grande de los gratuitos (550B en total, 55B activos), para pasos de razonamiento difíciles.google/gemma-4-31b-it:free: el mejor Gemma 4 denso, bueno también con imágenes.google/gemma-4-26b-a4b-it:free: Gemma 4 MoE, más rápido.
Ojo: qwen/qwen3.8-27b:free ya no aparece en el catálogo gratuito. Si lo tenías configurado, cámbialo.
Dónde funciona: experimentar y probar modelos nuevos sin crear cuentas en cada proveedor.
Dónde se queda corto: la disponibilidad cambia sin aviso y las colas en hora punta pueden hacer lento al agente. Para un agente en producción, mejor un modelo de pago en OpenRouter o una clave directa del proveedor, que no desaparece de un día para otro.
Modelos que no recomendamos
Qwen por OAuth. Era una de las opciones gratis más populares y ya no existe: el equipo de Qwen recortó la cuota de 1.000 a 100 peticiones al día y cerró por completo el acceso gratuito por OAuth el 15 de abril de 2026. Si una guía antigua te dice que inicies sesión con Qwen OAuth, sáltatela. Hoy, las vías gratis para Qwen son Groq o Ollama.
GLM-5.3-Flash para bucles de agente, sin probarlo antes. Es un modelo muy capaz y barato (0,15 / 0,50 US$), pero en Hugging Face hay reportes de usuarios con bucles de razonamiento y respuestas repetidas en tareas agénticas. Si lo usas, pon un límite de razonamiento y pruébalo con tu propia carga de trabajo. Para algo que funcione sin sorpresas, qwen3.8:27b es la opción más segura.
Cualquier modelo local de menos de 7B. A ese tamaño, las llamadas a herramientas fallan o ni existen: el agente te describe la tarea en lugar de hacerla. Si vas a lo local, empieza en qwen3.5:9b. Nuestra reseña de Qwen con Ollama (en inglés) cuenta qué corre bien en local y qué no.
Cómo cambiar o configurar el modelo en OpenClaw
La configuración de OpenClaw vive en un archivo JSON5 en ~/.openclaw/openclaw.json. El modelo se define con tres claves:
| Clave | Para qué sirve |
|---|---|
agents.defaults.model.primary | El modelo principal del agente |
agents.defaults.model.fallbacks | Una lista de modelos de reserva, que se prueban en orden si el principal falla |
agents.defaults.subagents.model | El modelo de los subagentes; conviene uno barato |
Este ejemplo pone Gemini 3.8 Flash como principal, Qwen en Groq como primera reserva y un modelo local de Ollama como última, y usa un modelo pequeño de Groq para los subagentes:
{
  agents: {
    defaults: {
      model: {
        primary: "google/gemini-3.8-flash",
        fallbacks: ["groq/qwen/qwen3.8-27b", "ollama/qwen3.8:27b"],
      },
      subagents: { model: "groq/openai/gpt-oss-20b" },
    },
  },
}
Lo comprobamos el 6 de octubre de 2026 en OpenClaw 2026.9.8: openclaw config validate lo da por válido. Para ver qué tienes configurado:
openclaw config get agents.defaults.model
openclaw models status
openclaw models status te muestra el modelo principal y las reservas. Un aviso: openclaw config show no existe, aunque lo veas en guías antiguas.
Si prefieres no tocar el archivo, openclaw models set google/gemini-3.8-flash cambia el modelo principal, y openclaw models fallbacks add <proveedor/modelo> añade una reserva. Para la configuración completa de Ollama (bloque del proveedor, ruta nativa, ventana de contexto), mira nuestra guía de OpenClaw con Ollama (en inglés).
Y si toda esta configuración de proveedores y claves te parece demasiado trabajo, esa es justo la parte que resolvemos en BetterClaw (en inglés): eliges el modelo en un desplegable, con tus propias claves, sin servidor que mantener. Los planes empiezan en 19 US$ al mes.
Privacidad: qué hace cada proveedor gratis con tus datos
El precio de “gratis” a veces aparece en la columna de privacidad.
| Proveedor | Qué pasa con tus datos en el plan gratuito |
|---|---|
| Google AI Studio (Gemini) | Fuera de Europa, Google usa lo que envías en el plan gratuito para mejorar sus productos, y revisores humanos pueden leerlo. En el Espacio Económico Europeo, Suiza y Reino Unido, se aplican las condiciones de datos del plan de pago también al gratuito (términos de la Gemini API). |
| Groq | Por defecto no conserva los datos de las peticiones de inferencia, salvo registros temporales (hasta 30 días) para resolver problemas o detectar abusos. Puedes activar Zero Data Retention en Data Controls (política de Groq). |
OpenRouter :free | Tu petición va al proveedor que sirve ese modelo, así que depende de su política. Revisa el proveedor o limítalos en la configuración de privacidad de OpenRouter. |
| DeepSeek (de pago) | Los datos se procesan en la infraestructura de DeepSeek en China. Lo habitual es que preocupe la residencia de los datos. |
| Ollama (local) | Nada sale de tu equipo. La opción más privada. |
Esto importa mucho en español: si estás en España, el plan gratuito de Gemini no usa tus datos para mejorar los productos de Google; si estás en Latinoamérica, sí. Google también pide no enviar información sensible, confidencial o personal a sus servicios gratuitos. Si manejas código propietario, datos de clientes o algo sujeto a normativa, usa Ollama o un plan de pago para esas tareas.
¿Qué modelo elegir?
| Tu caso | ¿Privacidad? | ¿Hardware? | Elige |
|---|---|---|---|
| Asistente personal, poco volumen | No | No | Gemini 3.8 Flash (plan gratuito) |
| Respuestas rápidas, sesiones cortas | No | No | Qwen3.8-27B en Groq |
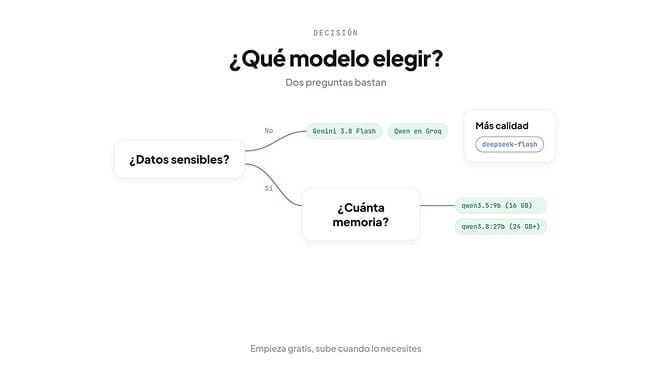
| Datos sensibles | Sí | 24 GB o más | Ollama + qwen3.8:27b |
| Equipo de 16 GB, sin internet | Sí | 16 GB | Ollama + qwen3.5:9b |
| Más calidad, poco presupuesto | No | No | DeepSeek deepseek-flash (de pago) |
| Probar muchos modelos | No | No | OpenRouter :free |
Nuestra recomendación: empieza con el plan gratuito de Gemini 3.8 Flash, añade Qwen en Groq como segunda clave rápida, pasa a Ollama si la privacidad es obligatoria y tienes el equipo, y cuando los límites gratuitos te frenen, sube a DeepSeek Flash.
Y una verdad incómoda: los modelos gratis funcionan para uso personal, aprender y experimentar, pero cuando un agente importa para tu negocio, la diferencia de calidad, fiabilidad y privacidad con un modelo de pago es real. Mucha gente empieza gratis y termina en DeepSeek o en un modelo de gama media en menos de un mes.
Preguntas frecuentes
¿OpenClaw es gratis?
Sí. OpenClaw es software de código abierto y no cuesta nada. Lo que puede costar es el modelo de IA que conectas y, si quieres el agente encendido 24/7, el servidor. Con un modelo gratis (Gemini 3.8 Flash, Qwen en Groq o un modelo local con Ollama) y tu propio equipo, el coste total es cero.
¿Cuál es el mejor modelo gratis para OpenClaw?
Gemini 3.8 Flash (gemini-3.8-flash) en el plan gratuito de Google AI Studio: no hay que pagar y soporta llamadas a funciones. Google no publica límites fijos, así que revisa los de tu proyecto en AI Studio. La segunda mejor opción es Qwen3.8-27B en el plan gratuito de Groq, con 1.000 peticiones al día.
¿Cuál es el mejor modelo local para OpenClaw?
qwen3.8:27b con Ollama si tienes 24 GB o más de memoria: es una descarga de 18 GB con contexto de 256K. En un equipo de 16 GB, qwen3.5:9b es la opción cómoda. Evita los modelos de menos de 7B, porque no llaman herramientas de forma fiable.
¿Cómo cambio el modelo en OpenClaw?
Edita agents.defaults.model.primary en ~/.openclaw/openclaw.json, o ejecuta openclaw models set <proveedor/modelo>, por ejemplo openclaw models set google/gemini-3.8-flash. Puedes añadir modelos de reserva en agents.defaults.model.fallbacks. Para comprobar el resultado, usa openclaw models status.
¿OpenClaw funciona con Gemini?
Sí. OpenClaw incluye el proveedor de Google: guarda tu clave de AI Studio como GEMINI_API_KEY (también acepta GOOGLE_API_KEY) y usa un modelo como google/gemini-3.8-flash. Con el plan gratuito de Gemini no pagas nada.
¿OpenClaw funciona sin internet?
Sí, si usas un modelo local con Ollama: el agente corre en tu equipo y su panel está en http://127.0.0.1:18789. Lo que necesita internet son los canales de mensajería como Telegram o Slack, la búsqueda web y los modelos en la nube.
¿OpenClaw es seguro?
Puede serlo si lo mantienes actualizado y no lo expones a internet sin protección. En enero de 2026 se corrigió una vulnerabilidad grave (CVE-2026-25253, CVSS 8,8) que permitía ejecutar código con un solo clic, así que no uses versiones anteriores a la 2026.1.29. Instala solo skills de confianza y, si usas un modelo en la nube gratis, recuerda que tus datos salen de tu equipo.