OpenClaw kostet nichts. Das Modell, das für OpenClaw denkt, manchmal schon. Hier erfährst du, was wirklich kostenlos ist, welches Modell zu deinem Fall passt, wie du das Modell in der Konfiguration wechselst, was die Gratis-Anbieter mit deinen Prompts machen und ob du OpenClaw auch kostenlos hosten kannst.
Du installierst OpenClaw, verbindest es mit Telegram, schreibst die erste Nachricht… und es will einen API-Schlüssel. „War das nicht kostenlos?“ Ist es. Aber ein Agent braucht ein Modell dahinter, und genau da steht das Kleingedruckte.
Die gute Nachricht: Du kannst OpenClaw wirklich kostenlos nutzen. Die schlechte: „kostenlos“ bedeutet drei verschiedene Dinge, und jedes hat seinen Haken.
Ist OpenClaw kostenlos?
Ja, OpenClaw ist kostenlos. Es ist Open-Source-Software: Du lädst es herunter, installierst es und nutzt es ohne Lizenz oder Abo. Kosten können an zwei Stellen entstehen:
- Beim KI-Modell. OpenClaw bringt kein eigenes Modell mit. Es nutzt das, was du einstellst: ein Cloud-Modell mit API-Schlüssel oder ein lokales Modell auf deinem Rechner.
- Beim Server. Soll dein Agent rund um die Uhr laufen und hast du keinen Rechner, der immer an ist, brauchst du einen VPS oder einen Hosting-Anbieter.
Läuft OpenClaw auf deinem eigenen Rechner mit einem Gratis-Modell (aus einem kostenlosen Cloud-Kontingent oder lokal mit Ollama), liegen die Gesamtkosten bei null. Der Haken: Dein Rechner muss an sein, damit der Agent antwortet. Klappst du den Laptop zu, schläft auch der Agent.
Der Rest dieses Artikels zeigt, mit welchem Modell du auf diese null kommst und ab wann sich das nicht mehr lohnt. Ob du OpenClaw auch kostenlos hosten kannst, klären wir weiter unten.
Kostenlose Modelle, die heute mit OpenClaw funktionieren
| Modell | Wo | Kostenlos? | Tool-Aufrufe | Limits oder Hinweise |
|---|---|---|---|---|
| Gemini 3.8 Flash | Google AI Studio | Ja, Gratis-Kontingent | Ja | Google nennt keine festen Limits: Du siehst sie in deinem Projekt in AI Studio |
| Qwen3.8-27B | Groq | Ja, Gratis-Plan | Ja | 30 Anfragen/Min., 1.000/Tag, 8.000 Tokens/Min., 200.000 Tokens/Tag |
| gpt-oss-120b | Groq | Ja, Gratis-Plan | Ja | Gleiche Limits wie Qwen3.8-27B auf Groq |
| GLM-4.7-Flash | Z.ai | Ja | Ja | Das neuere GLM-5.3-Flash ist kostenpflichtig |
:free-Modelle | OpenRouter | Ja | Ja, bei 14 von 15 | 20 Anfragen/Min.; 50/Tag, oder 1.000/Tag, wenn du insgesamt mindestens 10 $ Guthaben gekauft hast |
| Qwen3.8 27B | Ollama (lokal) | Ja, auf deiner Hardware | Ja | 18 GB Download: plane mit 24 GB oder mehr |
| Qwen 3.5 9B | Ollama (lokal) | Ja, auf deiner Hardware | Ja | Laut Ollama rund 11 GB VRAM: das bequeme Minimum für 16 GB |
| Gemma 4 | Ollama (lokal) | Ja, auf deiner Hardware | Ja | Laut Ollama rund 16 GB VRAM |
Stand: 6. Oktober 2026. Gratis-Kontingente ändern sich oft: Prüf die Limits an dem Tag, an dem du einrichtest.
Die günstigsten Modelle (fast kostenlos)
Reichen dir die Gratis-Kontingente nicht, sind das die günstigsten kostenpflichtigen Modelle, die gut mit Agenten funktionieren:
| Modell | Preis pro Million Tokens (Input / Output) | Warum es sich lohnt |
|---|---|---|
DeepSeek Flash (deepseek-flash) | 0,15 $ / 0,60 $ außerhalb der Spitzenzeit; 0,30 $ / 1,20 $ in der Spitzenzeit | Das günstigste brauchbare Modell. 1M Kontext und Tool-Aufrufe |
| GLM-5.3-Flash | 0,15 $ / 0,50 $ | Gleiche Preisklasse wie DeepSeek |
| Gemini 3.8 Flash (bezahlt) | 0,75 $ / 3,75 $ bis 31. Dezember 2026; 1,50 $ / 7,50 $ ab 1. Januar 2027 | Höhere Limits als das Gratis-Kontingent |
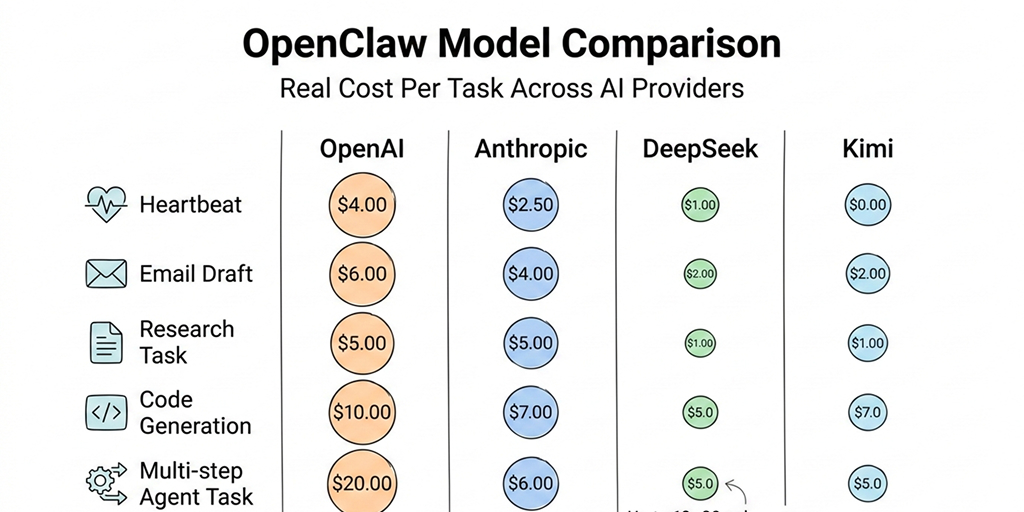
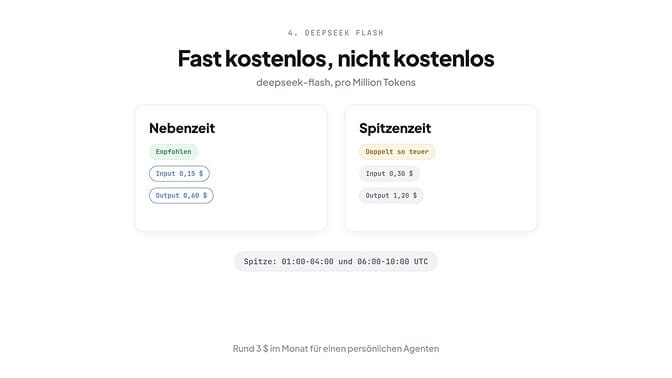
Zum Einordnen: Ein Agent mit 200 Aufrufen pro Tag, je rund 1.500 Input- und 500 Output-Tokens, kostet mit DeepSeek Flash außerhalb der Spitzenzeit etwa 3,15 US-Dollar im Monat, ohne Cache.
Und der Cache macht viel aus. Ein Agent schickt bei jedem Aufruf fast denselben Kontext, und DeepSeek berechnet gecachten Input außerhalb der Spitzenzeit mit 0,003 US-Dollar pro Million. Im normalen Betrieb liegt die echte Rechnung meist darunter. Bei allen diesen Modellen nutzt du deinen eigenen Schlüssel und zahlst direkt beim Anbieter.
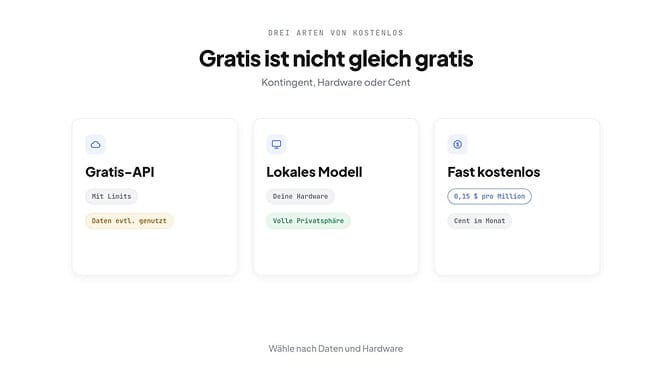
Drei Arten von „kostenlos“ (und warum das wichtig ist)
Typ 1: kostenlose API-Kontingente. Ein Cloud-Anbieter gibt dir ein Kontingent, ohne zu kassieren. Dafür akzeptierst du Limits, und je nach Anbieter und Land können deine Daten zur Verbesserung der Modelle genutzt werden. Dazu gehören Gemini, Groq, Z.ai und OpenRouter.
Typ 2: lokale Modelle. Du lässt das Modell mit Ollama auf deinem eigenen Rechner laufen. Kosten pro Token: null. Volle Privatsphäre. Aber du brauchst Hardware: mindestens 16 GB für etwas Brauchbares, und die Qualität bei Tool-Aufrufen schwankt stark.
Typ 3: fast kostenlos. Bezahlte Modelle, die so günstig sind, dass private Nutzung nur Cent kostet, wie DeepSeek Flash. Nicht null, aber für viele ist der Unterschied egal.
Die meisten „beste Gratis-Modelle“-Ratgeber werfen alle drei Typen in einen Topf, ohne es zu sagen. Dabei sind die Haken völlig verschieden.
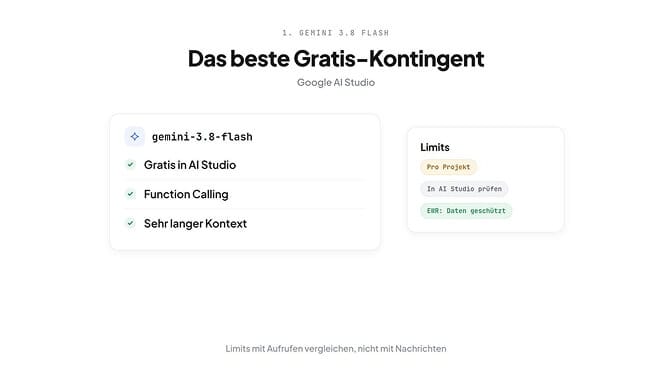
1. Gemini 3.8 Flash: das beste Gratis-Kontingent
Gemini 3.8 Flash (gemini-3.8-flash) ist Googles neuestes Flash-Modell und im kostenlosen Kontingent enthalten: Die Preisseite führt Input und Output als „free of charge“ kostenlos. Es unterstützt Function Calling, also genau das, was ein Agent braucht. Das alte Gemini 3 Flash gibt es nur noch als gemini-3-flash-preview, und Google nennt es inzwischen sein „legacy Flash model“ älteres Flash-Modell: Stell OpenClaw auf 3.8 Flash um.
Ein Hinweis, den fast alle Ratgeber übergehen: Google veröffentlicht keine festen Limits mehr für das Gratis-Kontingent. Laut der Limit-Seite hängen sie von verschiedenen Faktoren ab und sind nicht garantiert. Die einzige verlässliche Zahl ist die in deinem eigenen Projekt in Google AI Studio.
Denk auch daran: Jede Nachricht an deinen Agenten löst mehrere API-Aufrufe aus (nachdenken, Tools nutzen, antworten). Vergleich deine Limits mit Aufrufen, nicht mit Nachrichten.
Wo es funktioniert: einfache Agenten-Aufgaben, Dateien, Kalender, Fragen und Antworten, Surfen im Web. Für einen persönlichen Assistenten, der ein paar Nachrichten am Tag beantwortet, reicht das Gratis-Kontingent meist.
Wo es schwächelt: komplexes, mehrstufiges Denken. Und weil Google die Gratis-Kapazität nicht garantiert, solltest du nichts Geschäftskritisches darauf aufbauen.
Einrichtung in OpenClaw: Hol dir einen Schlüssel in Google AI Studio, speichere ihn als GEMINI_API_KEY und nutze das Modell google/gemini-3.8-flash. Den vollständigen Vergleich mit bezahlten Modellen findest du in unserem Modellvergleich für OpenClaw (auf Englisch).
2. Qwen3.8-27B auf Groq
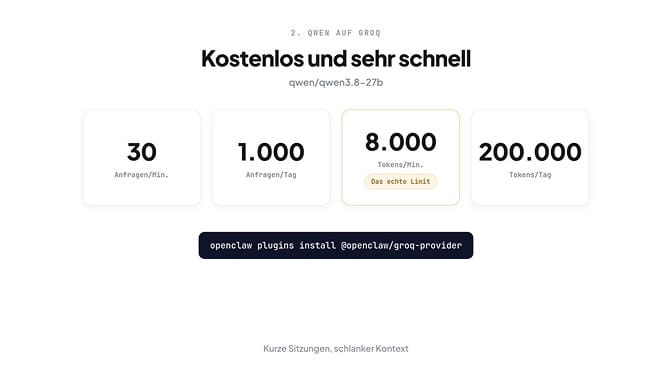
Platz zwei geht an Qwen3.8-27B im Gratis-Plan von Groq (qwen/qwen3.8-27b), dasselbe Modell, das weiter unten auch die beste lokale Wahl ist.
Groq veröffentlicht seine Gratis-Limits, was selten ist, und will eine Zahlungsmethode erst, wenn du auf den Developer-Plan wechselst. Für dieses Modell gelten 30 Anfragen pro Minute, 1.000 pro Tag, 8.000 Tokens pro Minute und 200.000 Tokens pro Tag. Dieselben Limits gelten für openai/gpt-oss-120b, ein guter zweiter Schlüssel, wenn das Tageskontingent aufgebraucht ist.
Wo es funktioniert: Sitzungen, in denen Tempo zählt, Programmieren und Aufgaben mit vielen Tools.
Wo es schwächelt: Das Limit von 8.000 Tokens pro Minute ist das, was wirklich drückt. OpenClaw schickt bei jedem Aufruf Systemprompt, Tool-Definitionen und Verlauf mit, deshalb kann eine lange Sitzung schon nach ein, zwei Runden ans Limit stoßen. Halte den Kontext schlank, oder nutz Groq für kurze Sitzungen und Gemini für lange.
Einrichtung in OpenClaw: Groq ist ein offizielles Plugin, das du separat installierst:
openclaw plugins install @openclaw/groq-provider
export GROQ_API_KEY="dein_groq_schluessel"
Danach nutzt du das Modell groq/qwen/qwen3.8-27b. Wenn die Gratis-Kontingente nicht mehr reichen, vergleicht unser Ratgeber zu den günstigsten Anbietern für OpenClaw (auf Englisch) die bezahlten Optionen.
3. Die besten lokalen Modelle für OpenClaw (Ollama)
Mit Ollama läuft das Modell auf deinem Rechner: null Kosten pro Token, keine Daten verlassen deinen Rechner, keine Limits, kein Kontingent. Für die DSGVO ist das die einfachste Lösung.
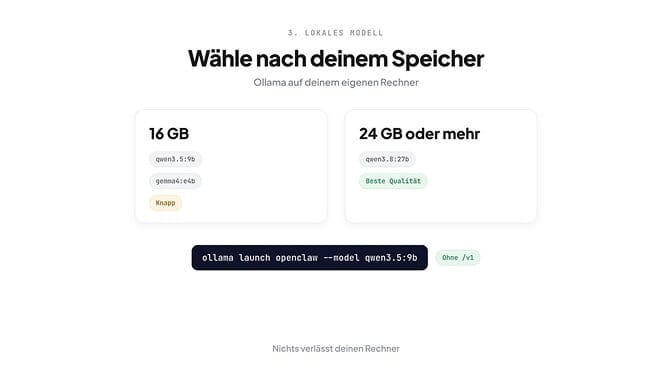
Die Größe zählt mehr, als man denkt, denn der Download sind nur die Gewichte, der Speicher für den Kontext kommt obendrauf. Laut Ollamas OpenClaw-Anleitung braucht qwen3.5 rund 11 GB VRAM und gemma4 rund 16 GB.
| Modell | Ollama-Tag | Für welchen Rechner | Am besten für |
|---|---|---|---|
| Qwen3.8 27B | qwen3.8:27b | 24 GB oder mehr (18 GB Download, 256K Kontext) | Das beste lokale Modell insgesamt |
| Qwen 3.5 9B | qwen3.5:9b | 16 GB | Bescheidene Rechner |
| Gemma 4 E4B | gemma4:e4b | 16 GB, knapp | Alternative bei 16 GB |
Alle tragen bei Ollama das Tools-Tag. Die Einrichtung ist ein Befehl, und Ollama konfiguriert den OpenClaw-Provider für dich:
ollama launch openclaw --model qwen3.5:9b
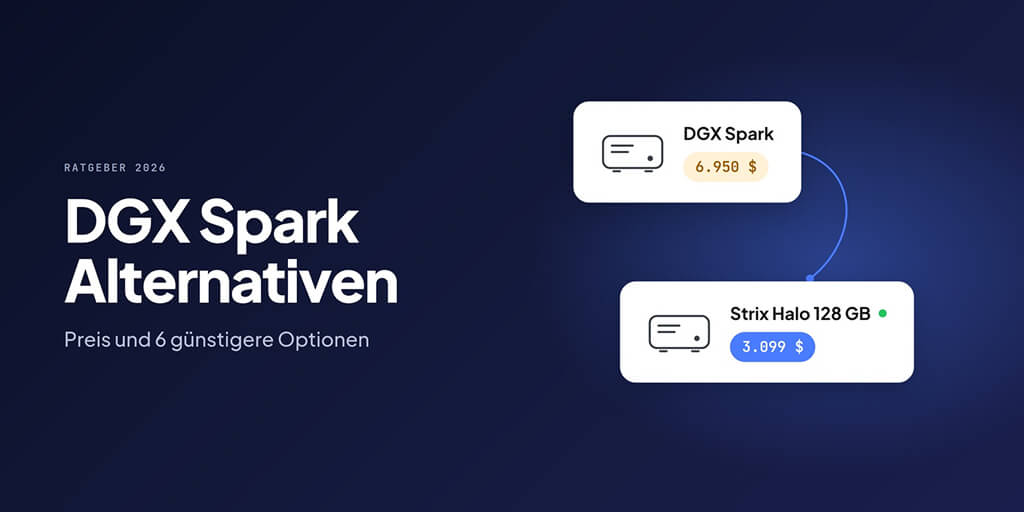
Richtest du es von Hand ein, nimm den nativen Ollama-Provider mit baseUrl: "http://127.0.0.1:11434", ohne /v1. Die OpenClaw-Dokumentation warnt ausdrücklich: Die OpenAI-kompatible URL macht Tool-Aufrufe kaputt. Modelle unter 7B rufen Tools in der Regel nicht zuverlässig auf. Antwortet ein lokales Modell nicht sauber, hilft unser Ratgeber zu Problemen mit lokalen Modellen (auf Englisch). Und falls du überlegst, Hardware für lokale KI zu kaufen, lies vorher unsere DGX-Spark-Alternativen.
Funktioniert OpenClaw ohne Internet?
Ja, mit Einschränkungen. Ist das Modell lokal (Ollama), kann OpenClaw offline laufen: Der Gateway läuft auf deinem Rechner, und die Control UI erreichst du unter http://127.0.0.1:18789. Ohne Internet geht alles nicht, was draußen lebt: die Messaging-Kanäle (Telegram, Slack, Discord), die Websuche und jedes Cloud-Modell.
4. DeepSeek Flash: bestes Preis-Leistungs-Verhältnis
DeepSeek ist nicht kostenlos, aber der günstigste Schritt nach oben, wenn ein Gratis-Kontingent nicht mehr reicht.
Am 10. September 2026 hat DeepSeek DeepSeek-V4.1-Flash veröffentlicht und das API-Modell in deepseek-flash umbenannt. V4-Flash ist eingestellt: Der alte Name deepseek-v4-flash wird noch angenommen, beantwortet wird er aber von V4.1-Flash.
Die Preise: 0,15 / 0,60 US-Dollar pro Million Input- und Output-Tokens außerhalb der Spitzenzeit und 0,30 / 1,20 US-Dollar in der Spitzenzeit. Spitzenzeit ist montags bis freitags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC, in deutscher Sommerzeit also von 03:00 bis 06:00 und von 08:00 bis 12:00 Uhr (in der Winterzeit eine Stunde früher). Der Rest ist Nebenzeit. 1M Kontext und Tool-Aufrufe sind dabei.
Wo es funktioniert: fast überall. Das Preis-Leistungs-Verhältnis ist schwer zu schlagen, und mit 1M Kontext hält es auch lange Sitzungen durch. Für Klassifizieren, Zusammenfassen oder Triage reicht es locker.
Der Haken: Du brauchst aufgeladenes Guthaben, also eine Karte. Die Spitzenzeit kostet das Doppelte, und sie fällt genau auf den deutschen Vormittag: Plane schwere Arbeit für den Nachmittag oder Abend. Und für die DSGVO ist DeepSeek heikel, dazu mehr unten.
5. Kostenlose Modelle bei OpenRouter
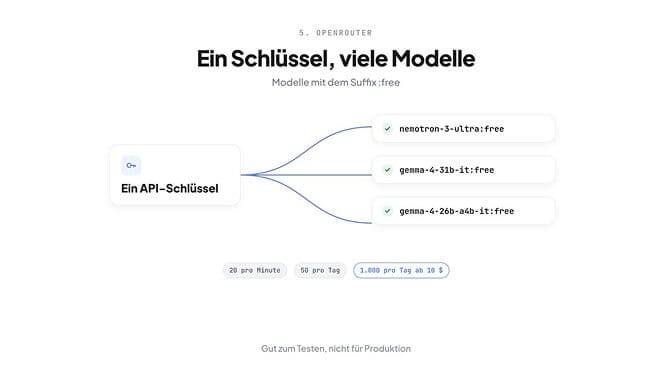
OpenRouter bündelt Modelle vieler Anbieter unter einem Schlüssel. Modelle mit dem Suffix :free kosten nichts.
Die Limits sind veröffentlicht: 20 Anfragen pro Minute, und 50 pro Tag, wenn du insgesamt weniger als 10 US-Dollar Guthaben gekauft hast, oder 1.000 pro Tag ab 10 US-Dollar. Fünfzig Anfragen sind nur eine Handvoll Agenten-Nachrichten, die 10 US-Dollar sind also praktisch der Preis dafür, dass :free mit OpenClaw brauchbar wird.
Am 6. Oktober 2026 gab es 15 :free-Modelle, 14 davon mit Tool-Unterstützung. Die interessantesten für Agenten:
nvidia/nemotron-3-ultra-550b-a55b:free: das größte der Gratis-Modelle (550B gesamt, 55B aktiv), für schwierige Denkschritte.google/gemma-4-31b-it:free: das stärkste dichte Gemma 4, auch gut mit Bildern.google/gemma-4-26b-a4b-it:free: Gemma 4 als MoE, schneller.
Achtung: qwen/qwen3.8-27b:free steht nicht mehr im Gratis-Katalog. Hast du es konfiguriert, tausch es aus.
Wo es funktioniert: neue Modelle ausprobieren, ohne bei jedem Anbieter ein Konto anzulegen.
Wo es schwächelt: Die Verfügbarkeit ändert sich ohne Ankündigung, und Warteschlangen zu Stoßzeiten können den Agenten ausbremsen. Für einen Agenten im Produktivbetrieb nimm lieber ein bezahltes Modell bei OpenRouter oder einen direkten Schlüssel beim Anbieter.
Modelle, die wir nicht empfehlen
Qwen über OAuth. Das war eine der beliebtesten Gratis-Optionen und gibt es nicht mehr: Das Qwen-Team hat das Kontingent von 1.000 auf 100 Anfragen pro Tag gekürzt und den kostenlosen OAuth-Zugang am 15. April 2026 ganz geschlossen. Sagt dir ein älterer Ratgeber, du sollst dich mit Qwen OAuth anmelden, überspring ihn. Kostenlos kommst du heute über Groq oder Ollama an Qwen.
GLM-5.3-Flash in Agenten-Schleifen, ohne vorher zu testen. Ein starkes und günstiges Modell (0,15 / 0,50 US-Dollar), aber auf Hugging Face berichten Nutzer von Denkschleifen und Wiederholungen bei Agenten-Aufgaben. Wenn du es nutzt, setz ein Denk-Budget und teste es mit deiner eigenen Last. Für etwas ohne Überraschungen ist qwen3.8:27b die sicherere Wahl.
Jedes lokale Modell unter 7B. In dieser Größe klappen Tool-Aufrufe nicht oder gar nicht: Der Agent beschreibt die Aufgabe, statt sie zu erledigen. Wenn lokal, dann ab qwen3.5:9b. Unser Qwen-und-Ollama-Test (auf Englisch) zeigt, was lokal gut läuft und was nicht.
So wechselst du das Modell in OpenClaw
Die Konfiguration von OpenClaw steht in einer JSON5-Datei unter ~/.openclaw/openclaw.json. Das Modell legst du mit drei Schlüsseln fest:
| Schlüssel | Wofür |
|---|---|
agents.defaults.model.primary | Das Hauptmodell des Agenten |
agents.defaults.model.fallbacks | Eine Liste von Ersatzmodellen, die der Reihe nach probiert werden, wenn das Hauptmodell ausfällt |
agents.defaults.subagents.model | Das Modell für Sub-Agenten; hier lohnt sich ein günstiges |
Dieses Beispiel setzt Gemini 3.8 Flash als Hauptmodell, Qwen auf Groq als ersten Fallback und ein lokales Ollama-Modell als letzten, und nimmt für Sub-Agenten ein kleines Groq-Modell:
{
  agents: {
    defaults: {
      model: {
        primary: "google/gemini-3.8-flash",
        fallbacks: ["groq/qwen/qwen3.8-27b", "ollama/qwen3.8:27b"],
      },
      subagents: { model: "groq/openai/gpt-oss-20b" },
    },
  },
}
Getestet am 6. Oktober 2026 mit OpenClaw 2026.9.8: openclaw config validate meldet die Konfiguration als gültig. So siehst du, was eingestellt ist:
openclaw config get agents.defaults.model
openclaw models status
openclaw models status zeigt dir Hauptmodell und Fallbacks. Achtung: openclaw config show gibt es nicht, auch wenn es in älteren Anleitungen steht.
Willst du die Datei nicht anfassen, wechselt openclaw models set google/gemini-3.8-flash das Hauptmodell, und openclaw models fallbacks add <anbieter/modell> fügt einen Fallback hinzu. Die komplette Ollama-Konfiguration (Provider-Block, nativer Pfad, Kontextfenster) findest du in unserer OpenClaw-Ollama-Anleitung (auf Englisch).
Und wenn dir dieses Hantieren mit Providern und Schlüsseln zu viel ist: Genau diesen Teil nimmt dir BetterClaw (auf Englisch) ab. Du wählst das Modell aus einer Liste, mit deinen eigenen Schlüsseln, ohne Server, um den du dich kümmern musst. Pläne ab 19 US-Dollar im Monat.
Datenschutz und DSGVO: was Gratis-Anbieter mit deinen Prompts machen
Der Preis von „kostenlos“ steht manchmal in der Datenschutz-Spalte. Die gute Nachricht für Leser in Deutschland, Österreich und der Schweiz zuerst:
Bei Gemini gelten für dich die Bedingungen des bezahlten Plans, auch im Gratis-Kontingent. Googles Nutzungsbedingungen für die Gemini API sagen ausdrücklich: Wer im Europäischen Wirtschaftsraum, in der Schweiz oder im Vereinigten Königreich ist, für den gelten die Regeln zur Datennutzung der bezahlten Dienste für alle Dienste, auch für Google AI Studio und das unbezahlte Kontingent. Außerhalb dieser Region nutzt Google Gratis-Prompts zur Verbesserung seiner Produkte, und menschliche Prüfer können sie lesen.
Zwei Einschränkungen: Google verlangt, dass du gegenüber Nutzern im EWR, in der Schweiz und im Vereinigten Königreich nur bezahlte Dienste einsetzt, wenn du ihnen eine API-Anwendung bereitstellst. Ein Agent, den Kunden oder Kollegen nutzen, gehört also ins bezahlte Kontingent. Und die Gemini-API-Dienste sind laut Google für berufliche Zwecke gedacht, nicht für Verbraucher.
| Anbieter | Was mit deinen Daten im Gratis-Plan passiert |
|---|---|
| Google AI Studio (Gemini) | Im EWR, in der Schweiz und im Vereinigten Königreich gelten die Datenregeln des bezahlten Plans auch im Gratis-Kontingent. Anderswo werden Gratis-Prompts zur Produktverbesserung genutzt. |
| Groq | Speichert Daten aus Inferenz-Anfragen standardmäßig nicht, abgesehen von temporären Logs (bis zu 30 Tage) zur Fehlersuche oder Missbrauchsabwehr. Zero Data Retention lässt sich unter Data Controls aktivieren (Groqs Datenrichtlinie). |
OpenRouter :free | Deine Anfrage geht an den Anbieter, der das Modell bereitstellt, die Datenverarbeitung hängt also von dessen Regeln ab. Prüf den Anbieter oder schränk die Anbieter in den Datenschutzeinstellungen von OpenRouter ein. |
| DeepSeek (bezahlt) | Verarbeitung auf DeepSeeks Infrastruktur in China. Für China gibt es keinen Angemessenheitsbeschluss der EU, für personenbezogene Daten ist das unter der DSGVO problematisch. |
| Ollama (lokal) | Nichts verlässt deinen Rechner. Die einfachste Lösung für die DSGVO. |
Arbeitest du mit Kundendaten, proprietärem Code oder personenbezogenen Daten, nimm Ollama oder einen bezahlten Plan mit passendem Auftragsverarbeitungsvertrag. Gratis-Kontingente sind für Unkritisches da.
Welches Modell passt zu dir?
| Dein Fall | Datenschutz? | Hardware? | Wahl |
|---|---|---|---|
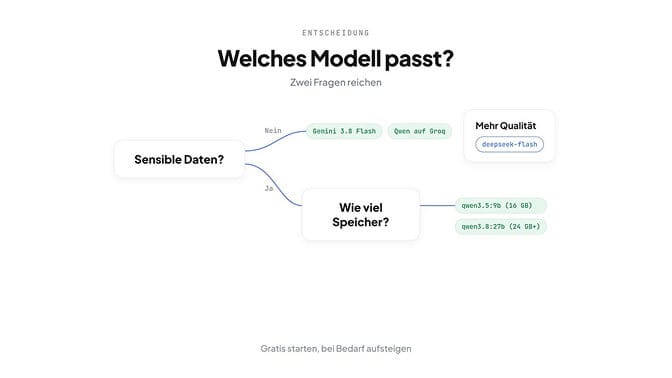
| Persönlicher Assistent, wenig Volumen | Normal | Nein | Gemini 3.8 Flash (Gratis-Kontingent) |
| Schnelle Antworten, kurze Sitzungen | Normal | Nein | Qwen3.8-27B auf Groq |
| Sensible oder personenbezogene Daten | Hoch | 24 GB oder mehr | Ollama + qwen3.8:27b |
| Rechner mit 16 GB, offline | Hoch | 16 GB | Ollama + qwen3.5:9b |
| Mehr Qualität, kleines Budget | Normal | Nein | DeepSeek deepseek-flash (bezahlt) |
| Viele Modelle ausprobieren | Normal | Nein | OpenRouter :free |
Unsere Empfehlung: Fang mit dem Gratis-Kontingent von Gemini 3.8 Flash an, nimm Qwen auf Groq als schnellen zweiten Schlüssel dazu, geh zu Ollama, wenn Datenschutz Pflicht ist und du die Hardware hast, und steig auf DeepSeek Flash um, wenn dich die Gratis-Limits ausbremsen.
Und eine unbequeme Wahrheit: Gratis-Modelle taugen für private Nutzung, zum Lernen und Ausprobieren. Sobald ein Agent für dein Geschäft wichtig wird, ist der Abstand bei Qualität, Zuverlässigkeit und Datenschutz zu einem bezahlten Modell real. Viele starten gratis und landen innerhalb eines Monats bei DeepSeek oder einem Mittelklasse-Modell.
OpenClaw kostenlos betreiben und hosten: geht das?
Betreiben ja, hosten nur mit Abstrichen. Auf deinem eigenen Rechner läuft OpenClaw mit einem Gratis-Modell komplett kostenlos, solange der Rechner an ist.
Für den Betrieb rund um die Uhr brauchst du einen Server. Die meistgenannte Gratis-Option ist das Always-Free-Angebot von Oracle Cloud mit Arm-Instanzen (Ampere A1). Oracle hat es zum 15. Juni 2026 allerdings stillschweigend halbiert: Aus 4 OCPUs und 24 GB RAM wurden 2 OCPUs und 12 GB, wie InfoQ im Juli berichtete. Das reicht für den OpenClaw-Gateway mit einem Cloud-Modell wie Gemini oder Groq, aber nicht für ein brauchbares lokales Modell: Ohne GPU und mit 12 GB ist Ollama für einen Agenten zu langsam.
Bezahlte VPS beginnen bei wenigen Euro im Monat, und dann musst du dich selbst um Updates, Sicherheit und Backups kümmern. Welche Anbieter OpenClaw für dich betreiben, was das kostet und wo die Server stehen, vergleicht unser Überblick über OpenClaw-Hosting-Anbieter (auf Englisch). Die Kosten von Selbsthosting und verwaltetem Hosting nebeneinander zeigt unser OpenClaw-Hosting-Kostenvergleich (auf Englisch).
BetterClaw ist kein OpenClaw-Host, sondern eine Alternative dazu, OpenClaw selbst zu betreiben: Du bekommst einen Agenten ohne Server, den du warten musst.
Häufige Fragen
Ist OpenClaw kostenlos?
Ja. OpenClaw ist Open-Source-Software und kostet nichts. Kosten können für das KI-Modell entstehen und, wenn der Agent rund um die Uhr laufen soll, für den Server. Mit einem Gratis-Modell (Gemini 3.8 Flash, Qwen auf Groq oder einem lokalen Modell mit Ollama) auf deinem eigenen Rechner liegen die Kosten bei null.
Welches ist das beste kostenlose Modell für OpenClaw?
Gemini 3.8 Flash (gemini-3.8-flash) im Gratis-Kontingent von Google AI Studio: kostenlos und mit Function Calling. Im EWR gelten dafür sogar die Datenregeln des bezahlten Plans. Google nennt keine festen Limits, also prüf sie in deinem Projekt in AI Studio. Platz zwei ist Qwen3.8-27B im Gratis-Plan von Groq, mit 1.000 Anfragen pro Tag.
Wie wechsle ich das Modell in OpenClaw?
Ändere agents.defaults.model.primary in ~/.openclaw/openclaw.json oder führe openclaw models set <anbieter/modell> aus, zum Beispiel openclaw models set google/gemini-3.8-flash. Ersatzmodelle trägst du unter agents.defaults.model.fallbacks ein. Ob alles stimmt, zeigt openclaw models status.
Kann ich mehrere Modelle gleichzeitig nutzen?
Ja, auf mehreren Wegen. Mit agents.defaults.model.fallbacks springt OpenClaw automatisch auf das nächste Modell, wenn das Hauptmodell ausfällt. Mit agents.defaults.subagents.model bekommen Sub-Agenten ein eigenes, günstigeres Modell. Und über agents.entries kannst du einzelnen Agenten ein eigenes Modell zuweisen, oder in einem Chat mit dem Befehl /model wechseln.
Welche lokalen Modelle laufen mit OpenClaw?
Mit Ollama laufen unter anderem qwen3.8:27b (ab 24 GB, das beste lokale Modell), qwen3.5:9b (bequem auf 16 GB) und gemma4:e4b (knapp auf 16 GB). Wichtig ist, dass das Modell Tools unterstützt und dass du den nativen Ollama-Provider ohne /v1 nutzt. Modelle unter 7B rufen Tools meist nicht zuverlässig auf.
Kann ich OpenClaw kostenlos hosten?
Auf deinem eigenen Rechner ja, solange er läuft. Für den Betrieb rund um die Uhr ist Oracle Cloud Always Free die bekannteste Gratis-Option, seit Juni 2026 aber nur noch mit 2 OCPUs und 12 GB RAM: genug für OpenClaw mit einem Cloud-Modell, zu wenig für ein lokales Modell. Für alles Ernsthafte brauchst du einen bezahlten VPS oder einen verwalteten Hosting-Anbieter.