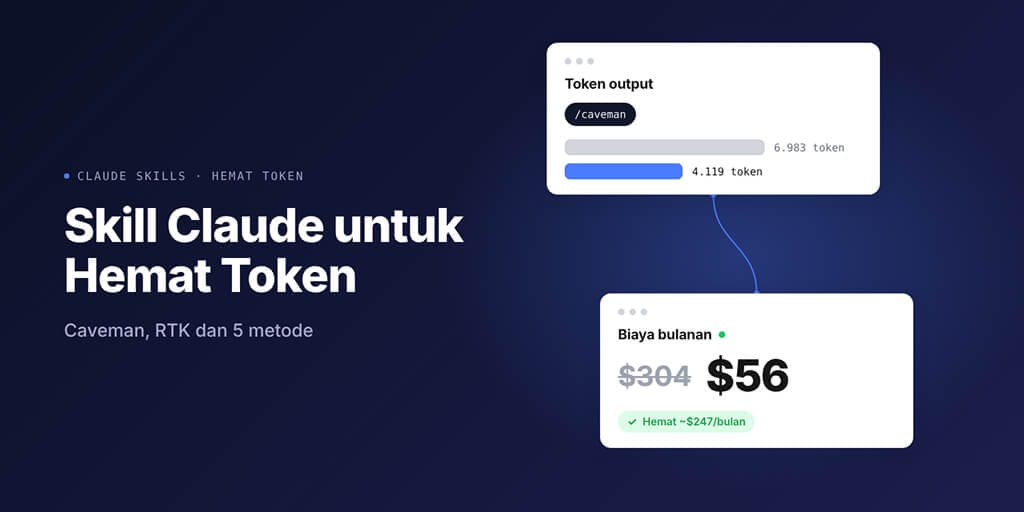
Sebagian besar skill justru menambah token. Skill-skill berikut memangkasnya: Caveman, RTK, caveman-compress dan claude-token-optimizer, ditambah lima metode di baliknya, lengkap dengan perintah instalasi, angka yang jujur, dan berapa yang sebenarnya dihemat oleh masing-masing.
Sebagian besar skill menambah token. Skill menambahkan konteks, instruksi, dan pemeriksaan kualitas, dan semuanya ditagih. Jadi pertanyaan yang berguna bukan "skill mana yang mengurangi token?", melainkan "skill mana yang membuang lebih banyak token daripada yang ditambahkannya?"
Suatu bulan, tagihan Claude Code saya mencapai $87. Tidak keterlaluan. Tetapi ketika saya rinci ke mana saja token itu pergi, hasilnya menyedihkan.
Sekitar 40% adalah basa-basi. "Tentu! Saya akan dengan senang hati membantu Anda melakukan refactor pada fungsi itu. Mari saya jelaskan perubahannya langkah demi langkah..." Pembukaan seperti itu memakan biaya dan tidak menambah apa pun. Kalikan dengan 200 interaksi, dan Anda membayar asisten sopan yang tidak berhenti menjelaskan hal-hal yang tidak Anda minta untuk dijelaskan.
30% lainnya adalah prompt ulang. Agen membangun hal yang salah karena instruksinya ambigu. Saya jelaskan perbaikannya. Agen membangun ulang. Dua kali bolak-balik, bukan satu, dua kali lipat token untuk output yang sama.
30% terakhir adalah pekerjaan yang memang berguna.
Panduan ini membahas skill dan tool yang memang dipasang para developer untuk mengatasi hal itu, berapa yang terukur dihemat oleh masing-masing, dan lima metode yang mendasarinya, sehingga Anda bisa memilih yang cocok alih-alih memasang semuanya.
Apakah skill benar mengurangi penggunaan token?
Ya, tetapi hanya sebagian. Skill yang memampatkan output, memampatkan file yang dibaca Claude, atau mengarahkan pekerjaan ke model yang lebih murah akan mengurangi token per panggilan. Skill yang menambahkan kemampuan (pencarian web, membaca file, pemanggilan tool) menaikkan penggunaan token, karena ia menambahkan instruksi, skema tool, dan hasil tool miliknya sendiri ke dalam konteks.
Bahkan skill penghemat token pun ada biayanya. Skill dimuat sesuai kebutuhan di Claude Code (masing-masing menghabiskan sekitar 30 hingga 100 token saat startup untuk nama dan deskripsinya, menurut rincian dari Firecrawl), tetapi begitu skill aktif, seluruh instruksinya berada di dalam konteks. README Caveman sendiri menyebut aturannya sekitar 1.160 token input, dan ulasan Skillselion menyebut sekitar 1.000 hingga 1.500 per giliran. Secara keseluruhan skill ini tetap menghemat token, karena token output di Claude berharga 5x token input, tetapi penghematannya lebih kecil daripada angka utamanya.
Jadi efek bersihnya bergantung pada skill mana yang Anda pasang. Skill di bawah ini dibuat untuk membuang token, bukan untuk menambah fitur.
Skill dan tool Claude terbaik untuk mengurangi penggunaan token (Oktober 2026)
| Skill atau tool | Yang dipangkas | Penghematan terukur | Bekerja dengan | Instalasi |
|---|---|---|---|---|
| Caveman | Token output: jawaban ringkas, kode tetap persis | 4.119 vs 6.983 token output pada 10 pertanyaan dev (/caveman), 2.693 dengan /ultracave | Claude Code, Codex, Gemini CLI, Cursor, Copilot, OpenCode dan 30+ agen | claude plugin marketplace add JuliusBrussee/caveman, lalu claude plugin install caveman@caveman |
| caveman-compress (bagian dari Caveman) | Token input: CLAUDE.md dan file memori lainnya | 6.198 menjadi 4.138 token pada lima file | Agen apa pun yang memuat file memori | Sudah termasuk dalam Caveman |
| RTK, Rust Token Killer | Token input: output shell, build dan tes | 60 hingga 90% pada perintah dev umum (hanya output bash) | Claude Code, Codex, Cursor, Copilot, Gemini CLI, Windsurf, Cline, OpenClaw, Hermes dan lainnya (18 tool) | brew install rtk, lalu rtk init -g |
| claude-token-optimizer | Token input di awal sesi | Sekitar 11.000 menjadi sekitar 800 token startup pada proyek pembuatnya | Claude Code | npx -y claude-token-optimizer measure |
| claude-code-router | Biaya per token: mengarahkan permintaan ke model pilihan Anda | Bergantung pada aturan routing Anda | Claude Code dan agen coding lainnya | Lihat repo |
| ccusage | Tidak memangkas langsung: mengukur penggunaan dan biaya | Menunjukkan ke mana token pergi | Claude Code dan CLI coding lainnya | npx ccusage@latest |
Jumlah bintang GitHub per 27 Oktober 2026: Caveman sekitar 115.000, RTK sekitar 85.000, claude-token-optimizer sekitar 630. Angka penghematan adalah pengukuran proyek masing-masing kecuali disebutkan lain.
Caveman: skill penghemat token untuk output
Caveman adalah skill penghemat token untuk Claude Code dengan bintang terbanyak, sekitar 115.000 bintang GitHub (v4.0.1, dirilis 13 Oktober 2026). Skill ini membuat agen menjawab dengan gaya ringkas dan apa adanya, sementara kode, perintah, dan teks error tetap persis. Aktifkan dengan /caveman, lebih agresif dengan /ultracave, dan matikan dengan /caveman off atau "stop caveman". Di Codex pemicunya adalah $caveman.
Instalasi di Claude Code:
claude plugin marketplace add JuliusBrussee/caveman
claude plugin install caveman@caveman
Untuk Codex, Gemini CLI, OpenCode dan agen lain yang didukung, installer proyek ini menangani semuanya dalam satu langkah:
npx @caveman-ai/cli@latest
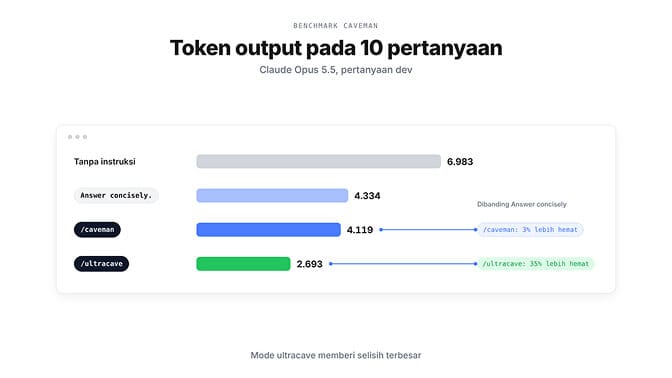
Angka yang jujur: pada sepuluh pertanyaan dev yang dijalankan di Claude Opus 5.5, output turun dari 6.983 token menjadi 4.119 dengan /caveman dan 2.693 dengan /ultracave. Instruksi sederhana "Answer concisely." (jawab dengan ringkas) mencapai 4.334 pada set yang sama, dan README-nya sendiri menyebut itu sebagai baseline yang sebenarnya: dibandingkan dengannya, /caveman memangkas 3% lebih banyak pada median dan /ultracave 35% lebih banyak. Jadi sebagian besar penghematan mode standar bisa didapat tanpa skill ini; /ultracave-lah yang membuatnya unggul.
Proyek ini juga melaporkan 33,2% lebih sedikit token input pada 54 sesi penuh Claude Code (pengujian Agustus 2026 pada versi yang lebih lama), berkat fitur tambahan yang memampatkan log, JSON, dan output tes sebelum model membacanya. JetBrains mengukur 8,5% lebih sedikit token output pada 86 tugas coding nyata tanpa penurunan kualitas yang terukur, dan Elastic 63,6% lebih sedikit token respons dalam delapan skenario MCP, jadi hasil Anda kemungkinan besar sangat bergantung pada seberapa cerewet agen Anda sejak awal.
Kekurangannya: output yang dimampatkan terasa dingin. Untuk kode dan pekerjaan teknis, itu tidak masalah. Untuk konten yang dibaca pelanggan atau apa pun yang membutuhkan nada yang tepat, matikan saja.
RTK (Rust Token Killer): penghemat token untuk output shell
RTK adalah satu binary Rust yang berada di antara agen Anda dan terminal. Saat agen menjalankan git status, cargo test atau npm install, RTK menyaring output hingga hanya bagian penting yang masuk ke konteks. Proyek ini mengklaim output 60 hingga 90% lebih kecil pada perintah dev umum, dan mendukung 18 tool AI coding, termasuk Claude Code, Codex, Cursor, GitHub Copilot dan Gemini CLI.
brew install rtk
rtk init -g       # Claude Code
rtk init -g --codex  # Codex
Ada dua catatan dari proyek itu sendiri. Penghematannya hanya berlaku untuk output bash (hook-nya aktif pada pemanggilan tool Bash), bukan seluruh tagihan Anda. Dan jumlah token diperkirakan dari jumlah byte, jadi percayai persentasenya lebih daripada angka absolutnya. Ada juga proyek lain bernama "rtk" di crates.io, jadi pastikan rtk gain berfungsi setelah instalasi.
RTK cocok dipasangkan dengan Caveman: Caveman mengecilkan apa yang ditulis agen, RTK mengecilkan apa yang dibacanya.
caveman-compress dan claude-token-optimizer: file lebih kecil di awal sesi
Claude Code memuat CLAUDE.md dan file memori Anda di awal setiap sesi, sebelum Anda mengetik apa pun. Firecrawl mengukur 20.000 hingga 30.000 token yang dimuat sebelum prompt pertama pada setup yang umum. Dua tool menangani hal ini secara langsung:
- caveman-compress menulis ulang file memori seperti CLAUDE.md ke dalam bentuk yang dimampatkan (file dikirim ke model yang Anda konfigurasikan untuk melakukannya). Pemeriksaan proyek ini pada lima file turun dari 6.198 menjadi 4.138 token, pemangkasan 23 hingga 49% per file.
- claude-token-optimizer menjaga CLAUDE.md yang pendek dan beberapa file referensi kecil tetap dimuat, lalu memindahkan dokumen lama, catatan sesi, dan daftar tugas yang sudah selesai ke file yang hanya dibaca Claude saat diperlukan. Pada proyek RedwoodJS milik pembuatnya, token startup turun dari sekitar 11.000 menjadi sekitar 800. Jalankan
npx -y claude-token-optimizer measureuntuk melihat angka Anda sendiri terlebih dahulu.
Inilah satu-satunya penghematan yang Anda dapatkan di setiap sesi, jadi biasanya ini tempat terbaik untuk memulai.
Apakah ada skill token optimizer?
Ya, beberapa proyek memakai nama itu. Yang paling praktis adalah claude-token-optimizer milik nadimtuhin (di atas), yang memangkas apa yang dimuat Claude di awal sesi. Yang lain lebih kecil dan bekerja dengan cara berbeda: claude-token-optimizer milik KINGSTAR-OMEGA adalah sepasang protokol prompt (satu membuat rencana di file dan mengajukan pertanyaan klarifikasi, satu lagi memaksa jawaban hanya dalam JSON), dan skill rescue-tokens milik valorisa adalah checklist untuk percakapan panjang, output yang bertele-tele, model yang salah, dan terlalu banyak server MCP.
Dalam praktiknya, "optimasi token" berasal dari kombinasi beberapa tool yang masing-masing menangani satu bagian tagihan: Caveman untuk output, RTK untuk output shell, optimizer awal sesi untuk file memori, dan pemangkasan MCP untuk skema tool.
Cara mengurangi penggunaan token pada agen AI Anda
Sebelum memilih skill, pahami ke mana token Anda pergi. Panggilan agen pada umumnya terdiri dari empat bagian, dan masing-masing memakan token:
- System prompt (instruksi agen Anda): biasanya 300 hingga 800 token, dikirim di setiap panggilan.
- Skema tool dan skill: kira-kira 100 hingga 200 token per tool, dikirim di setiap panggilan.
- Riwayat percakapan: bertambah di setiap giliran, dan sering kali menjadi biaya terbesar.
- Respons model: ditagih sebagai token output, yang harganya 5x tarif input di Claude.
Cara tercepat memangkas tagihan Anda:
Persingkat system prompt Anda. Setiap kata di dalamnya dikirim di setiap panggilan. Prompt 500 kata (sekitar 650 token) memakan biaya kira-kira $0.0013 per panggilan di Claude Sonnet 5.5, atau $0.26 per hari pada 200 panggilan. Kecil jika berdiri sendiri, tetapi biaya ini bertambah seiring setiap agen dan setiap panggilan. Pangkas menjadi 200 kata dan pos biaya itu turun 60%.
Batasi riwayat percakapan. Sebagian besar agen tidak membutuhkan seluruh riwayat di setiap panggilan. Sliding window berisi 3 hingga 5 giliran terakhir memangkas konteks sebesar 70 hingga 80% pada percakapan panjang. Memangkas riwayat 8.000 token menjadi 2.000 token menghemat $4.80 per hari pada 200 panggilan di Claude Opus 5.5.
Muat hanya tool yang Anda butuhkan. Setiap skema tool MCP menambahkan 100 hingga 300 token ke setiap panggilan. Agen dengan 10 tool MCP mengirim 1.000 hingga 3.000 token skema di setiap permintaan, bahkan jika sebagian besar tool itu tidak pernah dipakai. (Metode 4 di bawah membahas pemangkasan MCP secara mendalam.)
Gunakan model yang lebih murah untuk tugas sederhana. Klasifikasi, tagging, dan routing tidak membutuhkan model frontier. Claude Haiku 5.5 ($0.10/$0.50 per juta token untuk prompt hingga 100K token) 97,5% lebih murah daripada Claude Opus 5.5 ($4/$20).
Setelah itu, gunakan skill di atas dan metode di bawah untuk mengoptimalkan sisanya.
Cara mengurangi penggunaan token di Claude Code (opsi bawaan)
Claude Code memiliki beberapa kontrol token bawaan. Gunakan ini sebelum memasang apa pun (semuanya dari panduan biaya Anthropic):
/contextmenunjukkan apa yang sedang mengisi context window Anda saat ini. Mulailah dari sini./compactmerangkum percakapan sejauh ini;/clearmemulai dari awal saat Anda berganti tugas./cleartidak memakan biaya, sedangkan/compactsendiri adalah permintaan yang besar, jadi gunakan clear di antara tugas yang tidak berhubungan.- Jaga CLAUDE.md tetap pendek. Panduan Anthropic adalah di bawah 200 baris per file; Firecrawl memangkas satu file dari 3.847 token menjadi 312.
- Aturan deny
Readdipermissions.denymencegah Claude membaca folder build, lockfile, dan kode yang dihasilkan otomatis. File.claudeignoretidak berpengaruh; dokumentasi Anthropic menyarankan untuk memindahkan isinya ke aturan deny. - Aturan berbasis path di
.claude/rules/(dengan frontmatterpaths:) hanya dimuat saat Claude bekerja dengan file yang cocok. - MCP Tool Search (aktif secara default di Claude Code versi terkini) menunda tool MCP dan menemukannya sesuai kebutuhan, alih-alih memuat semua skema di awal.
- Plan mode (tekan Shift+Tab hingga status bar menampilkan plan mode) sebelum perubahan besar memangkas pekerjaan ke arah yang salah, yaitu jenis pekerjaan yang paling mahal.
Cara mengurangi penggunaan token di Codex
Tool yang sama bekerja di Codex CLI milik OpenAI. RTK dipasang untuk Codex dengan rtk init -g --codex, dan installer npx Caveman juga mencakup Codex. File AGENTS.md yang baik juga menghemat token: dalam studi terhadap 124 pull request di 10 repositori, yang dijalankan dengan dan tanpa file tersebut (Lulla et al., arXiv:2601.20404), AGENTS.md memangkas token output sebesar 16,6% dan median runtime sebesar 28,6%. Panduan praktik terbaik AGENTS.md kami membahas cara menulisnya.
Berapa yang sebenarnya dihemat dari pengurangan token (dalam dolar)
Berikut biaya agen pada umumnya sebelum dan sesudah optimasi, pada 200 panggilan per hari:
| Sebelum | Setelah optimasi | Penghematan | |
|---|---|---|---|
| System prompt | 500 kata (~650 token) | 200 kata (~260 token) | 60% |
| Skema tool | 10 tool (~2.000 token) | 3 tool (~600 token) | 70% |
| Riwayat | Penuh (~8.000 token) | 3 giliran terakhir (~2.000 token) | 75% |
| Panjang respons | ~400 token | ~150 token (dimampatkan) | 62% |
| Model | Opus 5.5 untuk semuanya | Sonnet 5.5 untuk 70% panggilan, Opus 5.5 untuk pekerjaan kompleks | 50% per panggilan yang dialihkan |
| Biaya per panggilan | ~$0.051 | ~$0.0094 | 81% |
| Biaya harian (200 panggilan) | ~$10.12 | ~$1.88 | hemat $8.24/hari |
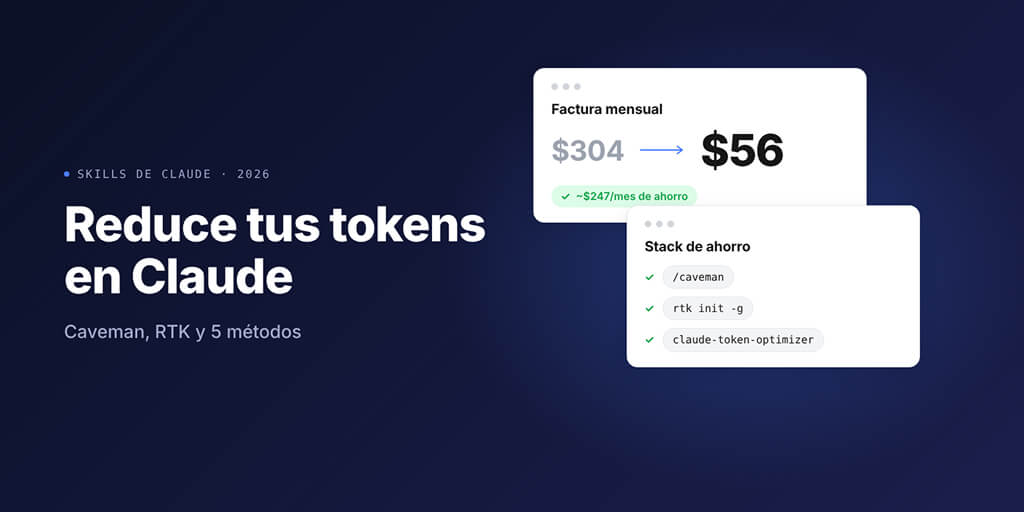
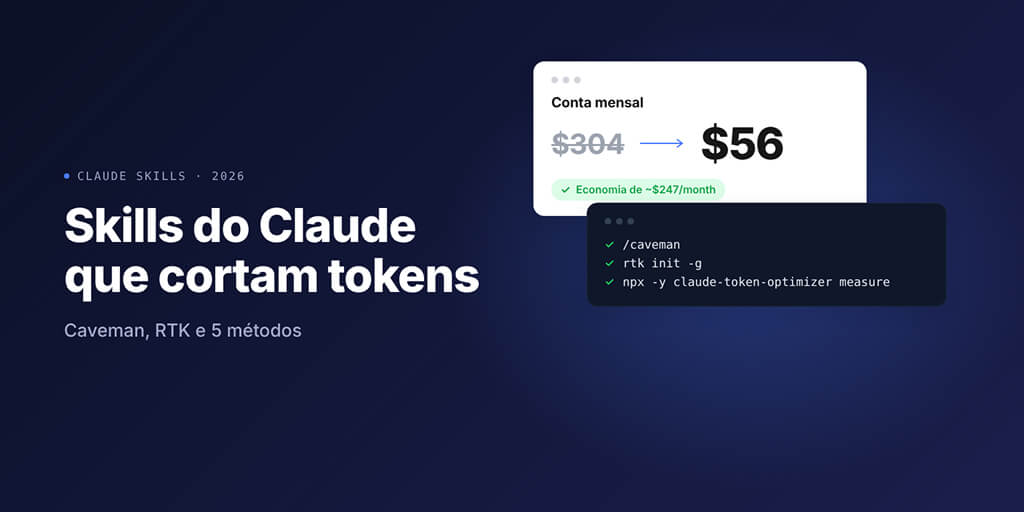
| Biaya bulanan (30 hari) | ~$304 | ~$56 | hemat ~$247/bulan |
Angka-angka ini menggunakan harga API Anthropic per Oktober 2026 (Claude Sonnet 5.5 seharga $2/$10 per juta token input/output, Claude Opus 5.5 seharga $4/$20) dan belum memperhitungkan prompt caching, yang akan menurunkan kedua kolom lebih jauh lagi. Bahkan tanpa routing model, pemangkasan konteks dan output saja sudah menurunkan tagihan yang hanya memakai Opus dari ~$304 menjadi ~$87 per bulan. Arahkan 70% panggilan paling sederhana ke Claude Haiku 5.5, bukan Sonnet, dan kolom "setelah" turun lebih jauh lagi. Pengguna BYOK di BetterClaw membayar langsung ke provider dengan tarif ini, tanpa markup sama sekali.
5 metode di balik setiap skill penghemat token
Setiap tool di atas bekerja melalui salah satu dari lima metode. Jika skill yang sedang Anda pertimbangkan tidak melakukan salah satunya, kemungkinan besar skill itu menambah token alih-alih menguranginya.
Metode 1: Kompresi output (pendekatan "Caveman")
Optimasi token yang paling banyak dibicarakan adalah memaksa agen berkomunikasi dengan bahasa yang ringkas dan langsung: tanpa frasa pengisi, pembuka basa-basi, kalimat transisi, atau penjelasan langkah demi langkah yang tidak Anda minta.
Tanpa kompresi: "Saya telah berhasil menyelesaikan refactoring modul autentikasi. Perubahannya mencakup pembaruan logika validasi token, penataan ulang rantai middleware, dan penambahan penanganan error yang menyeluruh. Berikut penjelasan rinci untuk setiap perubahan..." Itu 45 token yang murni membungkus konten sebenarnya.
Dengan kompresi: "Modul auth di-refactor. Validasi token diperbarui. Middleware ditata ulang. Penanganan error ditambahkan." Informasi yang sama. 12 token.
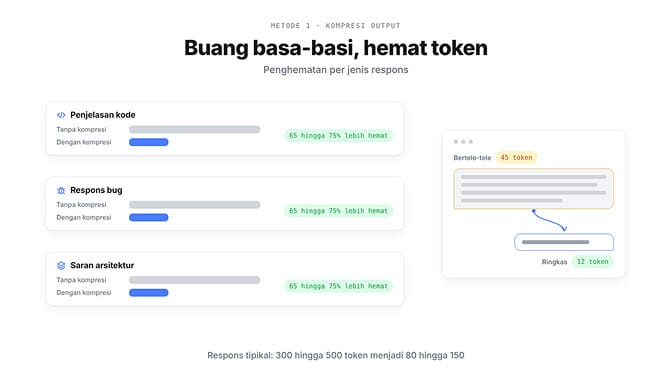
Angkanya: respons tipikal berkisar 300 hingga 500 token tanpa kompresi dan 80 hingga 150 token dengan kompresi agresif. Dalam 30 pertukaran pesan per sesi, itu berarti penghematan 9.000 hingga 12.000 token. Towards AI melakukan benchmark terhadap pendekatan ini dengan hasil pengurangan 75% per sesi; uji milik Caveman sendiri menunjukkan 41% lebih sedikit token output dibandingkan tanpa instruksi pada mode standarnya dan 61% pada /ultracave. Panduan membangun skill dari Anthropic memberikan contoh ilustratif untuk efek yang sama: tugas yang membutuhkan 15 pesan bolak-balik dan 12.000 token tanpa skill hanya membutuhkan 2 pertanyaan klarifikasi dan 6.000 token dengan skill.
Kekurangannya: output yang dimampatkan terasa dingin. Buat agar bisa dinyalakan dan dimatikan, jangan permanen.
Metode 2: Akurasi pada percobaan pertama (benar sejak awal)
Metode ini tidak terlihat seperti optimasi token, tetapi justru yang terbesar.
Skill yang menangkap bug sebelum Anda melakukan commit berarti lebih sedikit percakapan "perbaiki bug yang baru saja kamu buat". Skill yang mengenal framework testing proyek Anda menghasilkan tes yang lolos pada percobaan pertama. Skill arsitektur yang mengenal konvensi Anda mencegah agen menghasilkan kode dengan struktur yang salah, yang kemudian harus Anda minta untuk dikerjakan ulang.
Setiap prompt ulang memakan satu putaran penuh. Agen membaca ulang konteks, memproses koreksi, dan menghasilkan respons baru. Satu prompt ulang pada konteks 30.000 token memakan 30.000+ token untuk membaca ulang ditambah 500+ untuk menghasilkan respons. Cegah satu prompt ulang per sesi, dan Anda menghemat lebih banyak token daripada skill kompresi output mana pun.
MindStudio melakukan benchmark terhadap lima skill pemangkas token dan mendapatkan hasil yang sama setiap kali: lebih sedikit salah paham berarti lebih sedikit prompt ulang dan lebih sedikit token. Pendekatan terstruktur lima fase (rencanakan, lalu bangun, lalu verifikasi) memakai 14% lebih sedikit token dan biayanya 9% lebih rendah dibandingkan sesi tanpa struktur pada model yang sama.
Inilah alasan skill agen yang memuat konvensi proyek Anda sangat penting. Skill yang memberi tahu agen "gunakan functional component, jangan pernah class component" mencegah hasil dengan arsitektur yang salah, yang perbaikannya bisa memakan 50.000+ token.
Metode 3: Script kode alih-alih instruksi markdown
Yang satu ini berlawanan dengan intuisi. Sebagian besar skill ditulis dalam markdown: instruksi dalam bahasa alami yang dibaca dan diikuti oleh agen.
Namun MindStudio menerbitkan data yang menunjukkan bahwa script kode yang dapat dieksekusi mengurangi token hingga 90% dibandingkan instruksi markdown untuk tugas yang sama. Instruksi markdown pada dasarnya bertele-tele: "Saat pengguna meminta Anda memproses data, pertama periksa apakah file ada, lalu baca isinya, lalu validasi formatnya, lalu..." Itu satu paragraf yang dibaca dan ditafsirkan agen setiap kali dipanggil. Sebuah script melakukan hal yang sama dalam 10 baris. Agen tidak menafsirkannya; agen menjalankannya.
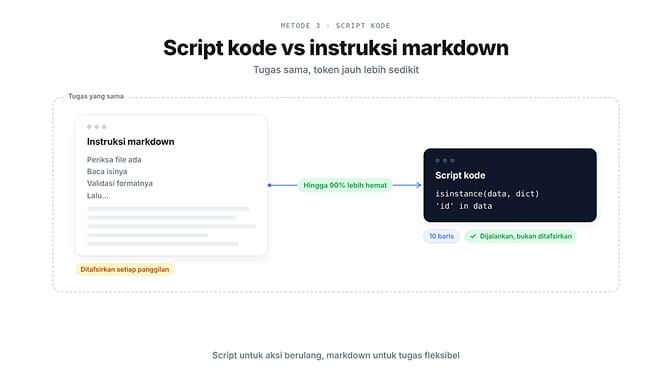
Script juga lebih andal. "Validasi formatnya" bisa berarti hal berbeda di setiap eksekusi. Script yang memeriksa isinstance(data, dict) dan 'id' in data melakukan tepat satu hal, setiap saat. Add-on "Blocks" milik Caveman (masih pre-release) dibangun di atas gagasan ini: script yang dapat dipakai ulang dan dijalankan agen alih-alih ditulis ulang. Pada eksekusi go test dengan 326 tes, output mentahnya 10.561 token, | tail -20 menurunkannya menjadi 397, dan block tersebut menurunkannya menjadi 76.
Untuk skill yang menjalankan aksi konsisten dan berulang (pemrosesan data, manajemen file, panggilan API, konversi format), tulislah sebagai script kode. Simpan instruksi markdown untuk skill yang membutuhkan penafsiran fleksibel.
Metode 4: Pemangkasan server MCP (penguras token yang tak terlihat)
Setiap server MCP yang terhubung ke agen Anda memuat definisi tool-nya ke dalam context window, di setiap pesan dan setiap giliran, entah Anda memakai tool tersebut dalam interaksi ini atau tidak.
MindStudio mengukur satu server MCP bisa mencapai 18.000 token per giliran hanya untuk overhead definisi tool. Hubungkan tiga server yang kaya fitur, dan Anda bisa menghabiskan 50.000+ token per percakapan untuk skema tool yang tidak pernah dipanggil agen. Damian Galarza menemukan bahwa definisi tool MCP dapat mengambil 24% atau lebih dari context window sebelum satu pesan pun dikirim. Untuk sebagian tool, panggilan API langsung alih-alih MCP menghindari overhead ini sepenuhnya.
Solusinya sederhana tetapi sering terlewat: lepaskan server MCP yang tidak sedang Anda pakai. Jika tugas hari ini tidak membutuhkan GitHub, putuskan koneksinya. Jika sesi ini Anda hanya butuh Slack, jangan ikut memuat Jira, HubSpot, dan Google Drive. (Untuk penjelasan lebih lanjut tentang posisi MCP dibandingkan skill, lihat panduan kami tentang Skills agen vs MCP.)
Anthropic menangani sebagian masalah ini pada Januari 2026 dengan MCP Tool Search. Di Claude Code versi terkini, fitur ini aktif secara default: tool MCP ditunda dan ditemukan sesuai kebutuhan, alih-alih semuanya dimuat di awal (ENABLE_TOOL_SEARCH=auto mengembalikan perilaku lama "hanya setelah melewati 10% konteks"). Namun tidak semua framework agen melakukan ini, dan Claude Code 2.1.296 (9 Oktober 2026) menggandakan batas default deskripsi tool MCP yang dikirim di awal dari 2.048 menjadi 4.096 karakter. Deskripsi yang boleh lebih panjang berarti lebih banyak token per tool di mana pun tool dimuat sejak awal, jadi pemangkasan menjadi lebih penting, bukan kurang.
Di BetterClaw, agen bekerja sebagai klien MCP dan Anda mencentang hanya tool yang dibutuhkan di setiap server MCP, yang merupakan pemangkasan yang sama tanpa perlu mengedit file konfigurasi. Skills dimuat dengan cara yang sama: hanya skill yang relevan dengan tugas saat ini yang memakai token konteks.
Metode 5: Injeksi konteks alih-alih mengirim ulang konteks
Kebiasaan paling boros dari semuanya adalah mengirim ulang konteks proyek yang sama di setiap percakapan.
Struktur proyek: 800 token. Dependensi: 600. Standar coding: 400. Keputusan arsitektur: 700. Dokumentasi API: 500. Keputusan sebelumnya: 400. Total: 3.400 token yang dikirim di awal setiap percakapan. Sepuluh percakapan sehari berarti 34.000 token untuk konteks yang berulang; dalam sebulan lebih dari 1.000.000 token yang tidak membawa informasi baru sama sekali.
Solusinya: simpan konteks dalam format yang persisten dan efisien, lalu injeksikan sesuai kebutuhan alih-alih mengirim ulang dalam bentuk mentah. Inilah yang dilakukan prompt caching di tingkat provider (di Claude Opus 5.5, input yang di-cache berharga $0.20 per juta token dibandingkan $4 tanpa cache; lihat panduan kami tentang prompt caching untuk agen). Anda juga bisa melakukannya di tingkat skill, dan itulah persisnya yang dilakukan caveman-compress dan claude-token-optimizer: alih-alih memuat README 2.000 token, simpan ringkasan 200 token berisi keputusan dan konvensi yang penting, lalu biarkan agen membuka file lengkapnya hanya saat diperlukan.
Bagaimana tool kompresi token memangkas biaya tanpa menurunkan kualitas output?
Tool ini membuang kata-kata yang tidak dibutuhkan model atau pembaca, dan membiarkan bagian yang membawa makna tetap persis. Caveman membiarkan kode, perintah, dan pesan error tidak tersentuh dan hanya membuang prosa di sekitarnya; RTK menyaring noise dari output perintah sebelum agen membacanya. JetBrains mengukur 8,5% lebih sedikit token output tanpa penurunan kualitas yang terukur saat memakai Caveman pada 86 tugas coding.
Kualitas menurun di dua tempat. Ringkasan konteks proyek yang terlalu dimampatkan bisa menghilangkan keputusan yang dibutuhkan agen, jadi mulailah dengan kompresi ringan dan periksa outputnya sebelum melangkah lebih jauh. Dan prosa yang ringkas tidak cocok untuk apa pun yang dibaca pelanggan. Mampatkan apa yang dibaca mesin; biarkan apa yang dibaca manusia.
Efek majemuk
Metode-metode ini tidak sekadar bertambah; efeknya berlipat. Kompresi output memangkas token per respons sebesar 65 hingga 75% pada tingkat terkuatnya. Akurasi pada percobaan pertama menghilangkan 30 hingga 50% putaran bolak-balik. Script kode memangkas overhead instruksi hingga 90%. Pemangkasan MCP mengembalikan 24%+ dari context window. Injeksi konteks menghilangkan 90%+ konteks yang berulang.
Terapkan kelimanya, dan sesi yang tadinya memakai 150.000 token mungkin hanya memakai 25.000 hingga 40.000. Pekerjaan yang sama, kualitas output yang sama, biaya 75 hingga 85% lebih rendah.
Paket awal yang praktis untuk Claude Code:
- Jalankan
/contextdannpx -y claude-token-optimizer measureuntuk melihat baseline Anda. - Pangkas CLAUDE.md hingga di bawah 200 baris, atau jalankan caveman-compress padanya.
- Pasang RTK dan jalankan
rtk init -g. - Pasang Caveman dan gunakan
/cavemanuntuk sesi coding, matikan untuk menulis. - Putuskan koneksi server MCP yang tidak Anda pakai hari ini.
- Ukur lagi dengan
npx ccusage@latestsetelah seminggu.
Gartner memproyeksikan 40% aplikasi enterprise akan menyematkan agen AI pada akhir 2026. Seiring adopsi meningkat, tim yang mengoptimalkan biaya token sekarang adalah tim yang mampu menjalankan lebih banyak agen, lebih sering, untuk masalah yang lebih sulit. Untuk sisi pemilihan model dari masalah yang sama, lihat panduan setup routing model kami dan panduan kami untuk memangkas biaya API agen hingga 80%.
Coba lihat BetterClaw jika Anda ingin optimasi token ditangani untuk Anda. Manajemen konteks yang mencegah pembengkakan sejak dari desainnya, skill yang hanya dimuat saat dibutuhkan, 500+ konektor dengan pemilihan MCP per tool di paket berbayar, dan 28+ provider model dengan key Anda sendiri tanpa markup. Buat akun BetterClaw, lalu Pro seharga $49/month memberi Anda 5 agen, dengan kill switch di setiap paket. Kami yang menangani biaya token. Anda yang menangani logika agen.
Pertanyaan yang Sering Diajukan
Apa skill Claude terbaik untuk mengurangi penggunaan token?
Caveman untuk output (4.119 token output, bukan 6.983, pada mode standar dan 2.693 pada /ultracave dalam uji sepuluh pertanyaannya sendiri), RTK untuk output shell dan tes (60 hingga 90% lebih kecil pada perintah dev umum), dan caveman-compress atau claude-token-optimizer untuk file yang dimuat Claude di awal sesi. Tambahkan pemangkasan MCP, dan Anda sudah menangani empat sumber pemborosan terbesar. Sebagian besar skill lain justru menambah token.
Apakah skill menghemat token?
Hanya skill yang dibuat untuk membuang token. Skill yang memampatkan output, memampatkan file, atau mengarahkan ke model yang lebih murah menghemat token; skill yang menambah kemampuan (pencarian, tool, akses file) menambah token. Bahkan skill penghemat pun ada biayanya: aturan Caveman menambahkan sekitar 1.000 hingga 1.500 token input per giliran selama aktif, dan menutupnya dengan memangkas token output, yang harganya 5x lipat di Claude.
Apa itu skill Caveman?
Skill open-source untuk Claude Code dan 30+ agen coding lainnya (JuliusBrussee/caveman, sekitar 115.000 bintang GitHub) yang membuat agen menjawab dengan bahasa ringkas dan apa adanya sambil menjaga kode tetap persis. Pasang di Claude Code dengan claude plugin marketplace add JuliusBrussee/caveman dan claude plugin install caveman@caveman, lalu gunakan /caveman, /ultracave atau /caveman off.
Apakah ada skill token optimizer untuk Claude Code?
Ya. claude-token-optimizer milik nadimtuhin memangkas apa yang dimuat Claude Code di awal sesi (sekitar 11.000 menjadi sekitar 800 token startup pada proyek pembuatnya); jalankan npx -y claude-token-optimizer measure untuk memeriksa milik Anda. Repo lain dengan nama serupa adalah protokol prompt dan checklist yang lebih kecil.
Apa itu RTK (Rust Token Killer)?
Satu binary Rust (rtk-ai/rtk, sekitar 85.000 bintang GitHub) yang menyaring output perintah sebelum agen Anda membacanya, memangkasnya sebesar 60 hingga 90% pada perintah dev umum. RTK bekerja dengan Claude Code, Codex, Cursor, Copilot, Gemini CLI dan 13 tool lainnya. Pasang dengan brew install rtk, lalu rtk init -g (tambahkan --codex untuk Codex).
Bagaimana cara mengurangi penggunaan token di Claude Code tanpa memasang apa pun?
Periksa /context, jaga CLAUDE.md di bawah 200 baris, tambahkan aturan deny Read untuk folder build dan lockfile, gunakan /clear di antara tugas dan /compact di dalam tugas yang panjang, biarkan MCP Tool Search tetap aktif, putuskan koneksi server MCP yang tidak Anda pakai, dan gunakan plan mode sebelum perubahan besar.
Seberapa besar skill penghemat token sebenarnya mengurangi biaya?
Masing-masing metode memberikan hasil yang terukur: kompresi output menghemat 65 hingga 75% per respons pada tingkat terkuatnya (Towards AI), script kode menghemat hingga 90% dibandingkan markdown (MindStudio), dan pemangkasan MCP dapat mengembalikan 24%+ dari context window (Damian Galarza). Jika digabungkan, efeknya berlipat menjadi pengurangan total 75 hingga 85% per sesi. Dalam contoh perhitungan kami, agen yang hanya memakai Opus dengan 200 panggilan per hari turun dari sekitar $304 menjadi sekitar $56 per bulan.
Apakah skill penghemat token dapat menurunkan kualitas output?
Kompresi output mengurangi penjelasan, yang tidak masalah untuk kode tetapi kurang baik untuk konten tulisan, jadi buat agar bisa dinyalakan dan dimatikan. Akurasi pada percobaan pertama dan script kode meningkatkan kualitas sekaligus mengurangi token. Pemangkasan MCP hanya memengaruhi token, selama Anda tetap mempertahankan server yang dibutuhkan. Kompresi konteks dapat menurunkan kualitas jika ringkasannya menghilangkan keputusan penting; mulailah dengan ringan dan periksa outputnya sebelum melangkah lebih jauh.
Apakah skill penghemat token bekerja di BetterClaw?
Ya. Dengan key model Anda sendiri (BYOK), setiap token yang Anda hemat langsung mengurangi tagihan provider Anda, tanpa markup. Manajemen konteks sudah tersedia bawaan: skill hanya dimuat saat tugas membutuhkannya, dan di paket berbayar Anda bisa mencentang tool mana saja yang diekspos setiap server MCP ke agen.