La mayoría de las skills aumentan el uso de tokens. Las siguientes los reducen: Caveman, RTK, caveman-compress y claude-token-optimizer, más los cinco métodos detrás de ellas, con comandos de instalación, cifras honestas y cuánto ahorra cada una realmente.
La mayoría de las skills aumentan los tokens. Las skills añaden contexto, instrucciones y verificaciones de calidad, y todo eso se cobra. Así que la pregunta útil no es "¿qué skills reducen tokens?", sino "¿qué skills eliminan más tokens de los que añaden?"
Un mes, mi factura de Claude Code llegó a $87. No era absurdo. Pero cuando fui a ver adónde iban los tokens, el resultado fue deprimente.
Alrededor del 40% era protocolo. "¡Claro! Con mucho gusto te ayudo a refactorizar esa función. Déjame explicarte los cambios paso a paso..." Ese tipo de apertura cuesta tokens y no aporta nada. Multiplicado por 200 interacciones, estás pagando a un asistente educado que no para de explicar cosas que no pediste que explicara.
Otro 30% eran re-prompts. El agente construyó algo incorrecto porque las instrucciones eran ambiguas. Expliqué la corrección. El agente reconstruyó. Dos idas y vueltas en lugar de una, el doble de tokens para el mismo resultado.
El último 30% era trabajo real.
Esta guía cubre las skills y herramientas que los desarrolladores realmente instalan para resolver eso, cuánto ahorra cada una en términos medibles y los cinco métodos detrás de ellas, para que puedas elegir lo que encaja en lugar de instalar todo.
¿Las skills realmente reducen el uso de tokens?
Sí, pero solo algunas. Las skills que comprimen la salida, comprimen los archivos que lee Claude o redirigen el trabajo a modelos más baratos reducen tokens por llamada. Las skills que añaden capacidades (búsqueda web, lectura de archivos, llamadas a herramientas) aumentan el uso de tokens, porque añaden sus propias instrucciones, esquemas de herramientas y resultados de herramientas al contexto.
Incluso las skills que ahorran tokens tienen un costo. Las skills se cargan bajo demanda en Claude Code (cada una usa aproximadamente 30–100 tokens en el inicio para nombre y descripción, según el análisis de Firecrawl), pero cuando una skill está activa, todas sus instrucciones están en el contexto. El propio README de Caveman cita alrededor de 1,160 tokens de entrada para sus reglas, y el análisis de Skillselion cita alrededor de 1,000–1,500 por turno. En general, la skill sigue ahorrando tokens porque los tokens de salida en Claude cuestan 5× los tokens de entrada, pero el ahorro es menor que el número principal.
Entonces el efecto neto depende de qué skills instales. Las de abajo fueron creadas para eliminar tokens, no para añadir funcionalidades.
Las mejores skills y herramientas de Claude para reducir el uso de tokens (octubre de 2026)
| Skill o herramienta | Qué recorta | Ahorro medido | Funciona con | Instalación |
|---|---|---|---|---|
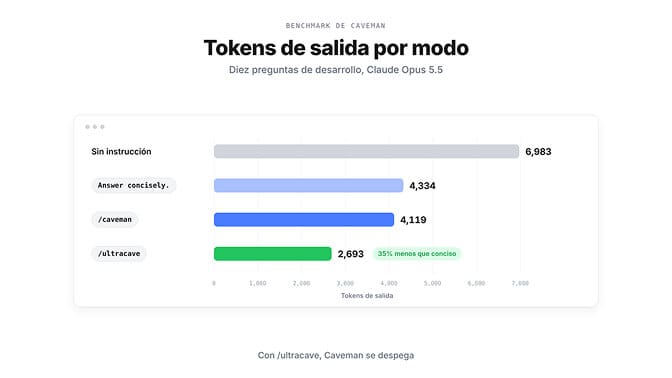
| Caveman | Tokens de salida: respuestas concisas, código intacto | 4,119 vs. 6,983 tokens de salida en 10 preguntas dev (/caveman), 2,693 con /ultracave | Claude Code, Codex, Gemini CLI, Cursor, Copilot, OpenCode y 30+ agentes | claude plugin marketplace add JuliusBrussee/caveman, luego claude plugin install caveman@caveman |
| caveman-compress (parte de Caveman) | Tokens de entrada: CLAUDE.md y otros archivos de memoria | 6,198 a 4,138 tokens en cinco archivos | Cualquier agente que cargue archivos de memoria | Incluido en Caveman |
| RTK, Rust Token Killer | Tokens de entrada: salidas de shell, build y tests | 60–90% en comandos dev comunes (solo salida bash) | Claude Code, Codex, Cursor, Copilot, Gemini CLI, Windsurf, Cline, OpenClaw, Hermes y otros (18 herramientas) | brew install rtk, luego rtk init -g |
| claude-token-optimizer | Tokens de entrada al inicio de sesión | ~11,000 a ~800 tokens de arranque en el proyecto del autor | Claude Code | npx -y claude-token-optimizer measure |
| claude-code-router | Costo por token: redirige peticiones al modelo que elijas | Depende de tus reglas de enrutamiento | Claude Code y otros agentes de codificación | Ver repositorio |
| ccusage | No recorta directamente: mide uso y costo | Muestra adónde van los tokens | Claude Code y otros CLIs de codificación | npx ccusage@latest |
Conteos de estrellas en GitHub el 27 de octubre de 2026: Caveman ~115,000, RTK ~85,000, claude-token-optimizer ~630. Las cifras de ahorro son mediciones de los propios proyectos salvo indicación contraria.
Caveman: skill para reducir tokens de salida
Caveman es la skill de reducción de tokens para Claude Code con más estrellas, con alrededor de 115,000 estrellas en GitHub (v4.0.1, lanzada el 13 de octubre de 2026). Hace que el agente responda con estilo conciso y directo, manteniendo el código, los comandos y el texto de error exactamente como están. Actívala con /caveman, modo más agresivo con /ultracave, desactívala con /caveman off o "stop caveman". En Codex el activador es $caveman.
Instalación en Claude Code:
claude plugin marketplace add JuliusBrussee/caveman
claude plugin install caveman@caveman
Para Codex, Gemini CLI, OpenCode y otros agentes compatibles, el instalador del proyecto lo gestiona todo en un paso:
npx @caveman-ai/cli@latest
Cifras honestas: en diez preguntas de desarrollo ejecutadas en Claude Opus 5.5, la salida bajó de 6,983 tokens a 4,119 con /caveman y 2,693 con /ultracave. La instrucción simple "Answer concisely." llegó a 4,334 en el mismo conjunto, y el propio README la cita como la línea base real: en comparación, /caveman recorta un 3% más en la mediana y /ultracave un 35% más. Así que la mayor parte del ahorro en modo estándar es alcanzable sin la skill; /ultracave es donde destaca.
El proyecto también reporta un 33,2% menos de tokens de entrada en 54 sesiones completas de Claude Code (pruebas de agosto de 2026 en una versión más antigua), gracias a características adicionales que comprimen logs, JSON y salidas de tests antes de que el modelo los lea. JetBrains midió un 8,5% menos de tokens de salida en 86 tareas de codificación reales sin caída medible de calidad, y Elastic un 63,6% menos de tokens de respuesta en ocho escenarios de MCP, por lo que tus resultados probablemente dependan mucho de cuán verboso sea tu agente para empezar.
La desventaja: la salida comprimida suena fría. Para código y trabajo técnico, está bien. Para contenido orientado al cliente o cualquier cosa que necesite el tono justo, desactívala.
RTK (Rust Token Killer): para reducir tokens de salida de shell
RTK es un único binario en Rust que se sitúa entre tu agente y el terminal. Cuando el agente ejecuta git status, cargo test o npm install, RTK filtra la salida para que solo las partes relevantes entren en el contexto. El proyecto afirma una salida entre un 60 y un 90% menor en comandos dev comunes, y soporta 18 herramientas de codificación con IA, incluyendo Claude Code, Codex, Cursor, GitHub Copilot y Gemini CLI.
brew install rtk
rtk init -g       # Claude Code
rtk init -g --codex  # Codex
Dos notas del propio proyecto: el ahorro solo aplica a la salida bash (el hook se activa en llamadas a la herramienta Bash), no a toda tu factura. Y los conteos de tokens se estiman por tamaño en bytes, así que confía más en los porcentajes que en los números absolutos. También existe otro proyecto llamado "rtk" en crates.io, así que asegúrate de que rtk gain funcione después de instalarlo.
RTK combina bien con Caveman: Caveman reduce lo que el agente escribe, RTK reduce lo que lee.
caveman-compress y claude-token-optimizer: archivos más pequeños al inicio de sesión
Claude Code carga tu CLAUDE.md y tus archivos de memoria al inicio de cada sesión, antes de que escribas nada. Firecrawl midió de 20,000 a 30,000 tokens cargados antes del primer prompt en una configuración típica. Dos herramientas abordan esto directamente:
- caveman-compress reescribe archivos de memoria como CLAUDE.md en forma comprimida (el archivo se envía al modelo que configures para hacerlo). La prueba del proyecto en cinco archivos bajó de 6,198 a 4,138 tokens, una reducción del 23 al 49% por archivo.
- claude-token-optimizer mantiene un CLAUDE.md corto y algunos archivos de referencia pequeños cargados, y mueve la documentación antigua, las notas de sesión y las listas de tareas completadas a archivos que Claude solo lee cuando es necesario. En el proyecto RedwoodJS del autor, los tokens de arranque bajaron de ~11,000 a ~800. Ejecuta
npx -y claude-token-optimizer measurepara ver tus propios números primero.
Este es el único ahorro que obtienes en cada sesión, así que suele ser el mejor punto de partida.
¿Existe alguna skill de optimización de tokens?
Sí, algunos proyectos usan ese nombre. El más práctico es el claude-token-optimizer de nadimtuhin (arriba), que recorta lo que Claude carga al inicio de la sesión. Otros son más pequeños y funcionan de forma diferente: el claude-token-optimizer de KINGSTAR-OMEGA es un par de protocolos de prompt (uno crea un plan en archivo y hace preguntas de aclaración, el otro fuerza respuestas solo en JSON), y la skill rescue-tokens de valorisa es una checklist para conversaciones largas, salidas verbosas, modelos incorrectos y demasiados servidores MCP.
En la práctica, la "optimización de tokens" viene de una combinación de herramientas que cada una gestiona una parte de la factura: Caveman para la salida, RTK para la salida de shell, el optimizador de inicio de sesión para los archivos de memoria y el recorte de MCP para los esquemas de herramientas.
Cómo reducir el uso de tokens en tu agente de IA
Antes de elegir una skill, entiende adónde van tus tokens. Una llamada típica de agente tiene cuatro partes, y cada una consume tokens:
- System prompt (las instrucciones de tu agente): normalmente 300–800 tokens, enviados en cada llamada.
- Esquemas de herramientas y skills: aproximadamente 100–200 tokens por herramienta, enviados en cada llamada.
- Historial de conversación: crece en cada turno y frecuentemente es el mayor costo.
- Respuesta del modelo: cobrada como tokens de salida, que cuestan 5× la tarifa de entrada en Claude.
Las formas más rápidas de recortar tu factura:
Acorta tu system prompt. Cada palabra en él se envía en cada llamada. Un prompt de 500 palabras (~650 tokens) cuesta aproximadamente $0.0013 por llamada en Claude Sonnet 5.5, o $0.26 al día en 200 llamadas. Pequeño de forma aislada, pero se acumula en cada agente y cada llamada. Recórtalo a 200 palabras y ese costo baja un 60%.
Limita el historial de conversación. La mayoría de los agentes no necesita todo el historial en cada llamada. Una ventana deslizante de los últimos 3–5 turnos recorta el contexto entre un 70 y un 80% en conversaciones largas. Recortar un historial de 8,000 tokens a 2,000 tokens ahorra $4.80 al día en 200 llamadas con Claude Opus 5.5.
Carga solo las herramientas que necesitas. Cada esquema de herramienta MCP añade 100–300 tokens a cada llamada. Un agente con 10 herramientas MCP envía 1,000–3,000 tokens de esquema en cada petición, incluso si la mayoría de esas herramientas nunca se usan. (El Método 4 a continuación aborda el recorte de MCP en profundidad.)
Usa modelos más baratos para tareas simples. La clasificación, el etiquetado y el enrutamiento no necesitan modelos de frontera. Claude Haiku 5.5 ($0.10/$0.50 por millón de tokens para prompts de hasta 100K tokens) es un 97,5% más barato que Claude Opus 5.5 ($4/$20).
Después de eso, usa las skills anteriores y los métodos a continuación para optimizar el resto.
Cómo reducir el uso de tokens en Claude Code (opciones nativas)
Claude Code tiene varios controles nativos de tokens. Úsalos antes de instalar cualquier cosa (todos del guía de precios de Anthropic):
/contextmuestra qué está llenando tu ventana de contexto en este momento. Empieza aquí./compactresume la conversación hasta ahora;/clearempieza de cero cuando cambias de tarea./clearno cuesta tokens;/compacten sí mismo es una petición grande, así que usa clear entre tareas no relacionadas.- Mantén el CLAUDE.md corto. La guía de Anthropic es menos de 200 líneas por archivo; Firecrawl redujo un archivo de 3,847 tokens a 312.
- Reglas de denegación de
Readenpermissions.denyimpiden que Claude lea carpetas de build, lockfiles y código generado automáticamente. Los archivos.claudeignoreno tienen efecto; la documentación de Anthropic recomienda mover el contenido a reglas de denegación. - Reglas basadas en ruta en
.claude/rules/(con frontmatterpaths:) solo se cargan cuando Claude está trabajando con archivos coincidentes. - MCP Tool Search (activo por defecto en versiones recientes de Claude Code) aplaza las herramientas MCP y las encuentra bajo demanda en lugar de cargar todos los esquemas por adelantado.
- Modo de planificación (presiona Shift+Tab hasta que la barra de estado muestre modo de planificación) antes de cambios grandes recorta el trabajo en la dirección equivocada: el tipo más caro.
Cómo reducir el uso de tokens en Codex
Las mismas herramientas funcionan en Codex CLI de OpenAI. RTK se instala para Codex con rtk init -g --codex, y el instalador npx de Caveman también cubre Codex. Un buen archivo AGENTS.md también ahorra tokens: en un estudio de 124 pull requests en 10 repositorios, ejecutados con y sin el archivo (Lulla et al., arXiv:2601.20404), AGENTS.md redujo los tokens de salida en un 16,6% y el tiempo de ejecución medio en un 28,6%. Nuestra guía de mejores prácticas de AGENTS.md explica cómo escribirlo.
Cuánto ahorra realmente reducir tokens (en dólares)
Aquí están los costos típicos de un agente antes y después de la optimización, en 200 llamadas al día:
| Antes | Tras la optimización | Ahorro | |
|---|---|---|---|
| System prompt | 500 palabras (~650 tokens) | 200 palabras (~260 tokens) | 60% |
| Esquemas de herramientas | 10 herramientas (~2,000 tokens) | 3 herramientas (~600 tokens) | 70% |
| Historial | Completo (~8,000 tokens) | Últimos 3 turnos (~2,000 tokens) | 75% |
| Longitud de respuesta | ~400 tokens | ~150 tokens (comprimido) | 62% |
| Modelo | Opus 5.5 para todo | Sonnet 5.5 para el 70% de llamadas, Opus 5.5 para trabajo complejo | 50% por llamada enrutada |
| Costo por llamada | ~$0.051 | ~$0.0094 | 81% |
| Costo diario (200 llamadas) | ~$10.12 | ~$1.88 | ahorro de $8.24/día |
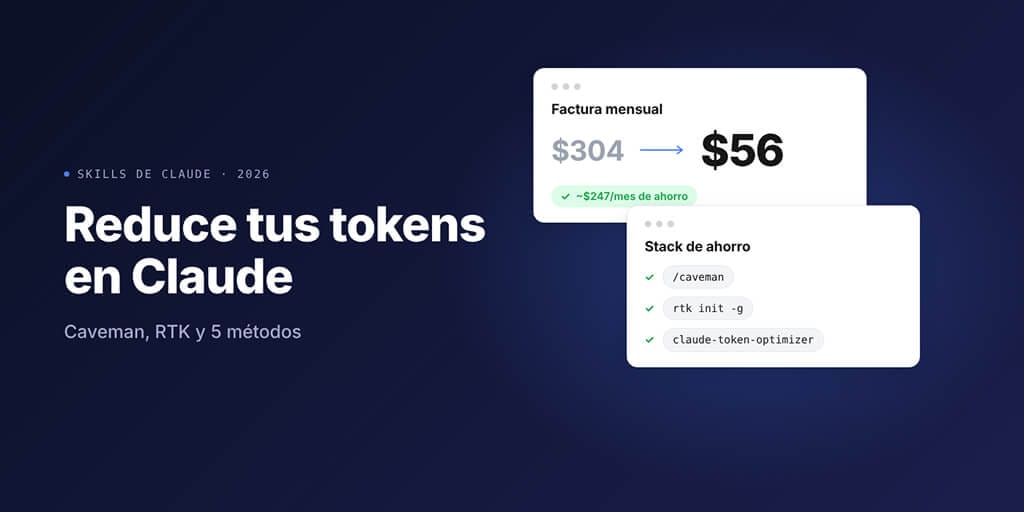
| Costo mensual (30 días) | ~$304 | ~$56 | ahorro de ~$247/mes |
Estas cifras usan los precios de la API de Anthropic de octubre de 2026 (Claude Sonnet 5.5 a $2/$10 por millón de tokens de entrada/salida, Claude Opus 5.5 a $4/$20) y no incluyen el caché de prompts, que reduciría ambas columnas aún más. Incluso sin enrutamiento de modelo, recortar el contexto y la salida solo ya reduce una factura de solo Opus de ~$304 a ~$87 al mes. Redirige el 70% de las llamadas más simples a Claude Haiku 5.5 en lugar de a Sonnet, y la columna "tras la optimización" baja aún más. Los usuarios BYOK en BetterClaw pagan directamente al proveedor a estas tarifas, sin ningún margen.
Los 5 métodos detrás de cada skill que ahorra tokens
Cada herramienta anterior funciona a través de uno de estos cinco métodos. Si una skill que estás considerando no hace ninguno de ellos, probablemente añade tokens en lugar de reducirlos.
Método 1: Compresión de salida (el enfoque "Caveman")
La optimización de tokens más comentada es forzar al agente a comunicarse con lenguaje conciso y directo: sin frases de relleno, aperturas ceremoniosas, frases de transición o explicaciones paso a paso que no pediste.
Sin compresión: "He completado con éxito la refactorización del módulo de autenticación. Los cambios incluyen actualizar la lógica de validación de tokens, reestructurar la cadena de middleware y añadir un manejo de errores completo. Aquí tienes una explicación detallada de cada cambio..." Son 45 tokens que simplemente envuelven el contenido real.
Con compresión: "Módulo de auth refactorizado. Validación de tokens actualizada. Middleware reestructurado. Manejo de errores añadido." La misma información. 12 tokens.
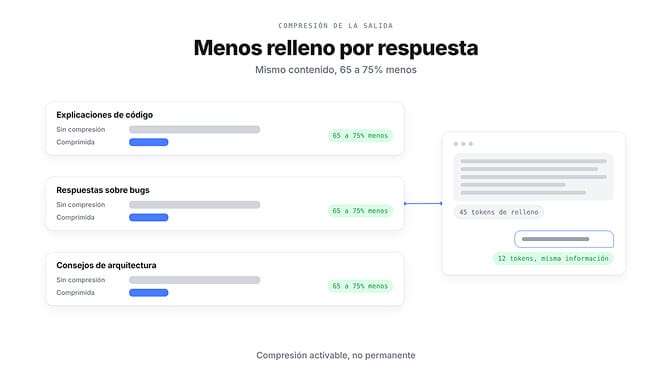
Las cifras: las respuestas típicas van de 300 a 500 tokens sin compresión y de 80 a 150 con compresión agresiva. En 30 intercambios de mensajes por sesión, eso supone un ahorro de 9,000 a 12,000 tokens. Towards AI hizo un benchmark de este enfoque con una reducción del 75% por sesión; los propios tests de Caveman muestran un 41% menos de tokens de salida en comparación con ninguna instrucción en su modo estándar y un 61% en /ultracave. La guía de creación de skills de Anthropic proporciona un ejemplo ilustrativo del mismo efecto: una tarea que requería 15 mensajes y 12,000 tokens sin skills solo necesitó 2 preguntas de aclaración y 6,000 tokens con skills.
La desventaja: la salida comprimida suena fría. Hazla activable y desactivable, no permanente.
Método 2: Acertar a la primera
Este no parece una optimización de tokens, pero es la mayor.
Las skills que capturan bugs antes de hacer commit significan menos conversaciones de "arregla el bug que acabas de crear". Las skills que conocen el framework de tests de tu proyecto producen tests que pasan a la primera. Las skills de arquitectura que conocen tus convenciones evitan que el agente genere código con estructura incorrecta que luego tienes que pedir que rehaga.
Cada re-prompt consume un turno completo. El agente vuelve a leer el contexto, procesa la corrección y genera una nueva respuesta. Un re-prompt en un contexto de 30,000 tokens cuesta 30,000+ tokens para releer más 500+ para generar la respuesta. Evita un re-prompt por sesión y ahorras más tokens que cualquier skill de compresión de salida.
MindStudio hizo un benchmark de cinco skills para recorte de tokens y obtuvo el mismo resultado en todos los casos: menos malentendidos significan menos re-prompts y menos tokens. El enfoque estructurado de cinco fases (planifica, luego construye, luego verifica) usó un 14% menos de tokens y costó un 9% menos que las sesiones no estructuradas en el mismo modelo.
Por eso las skills de agente que cargan las convenciones de tu proyecto hacen tanta diferencia. Una skill que le dice al agente "usa functional components, nunca class components" evita outputs con arquitectura incorrecta que pueden costar 50,000+ tokens corregir.
Método 3: Scripts de código en lugar de instrucciones en markdown
Este es contraintuitivo. La mayoría de las skills están escritas en markdown: instrucciones en lenguaje natural que el agente lee y sigue.
Pero MindStudio publicó datos que muestran que los scripts de código ejecutables reducen tokens hasta un 90% en comparación con las instrucciones en markdown para la misma tarea. Las instrucciones en markdown son inherentemente verbosas: "Cuando el usuario pida procesar datos, primero comprueba si el archivo existe, luego lee su contenido, luego valida el formato, luego..." Es un párrafo que el agente lee e interpreta cada vez que se le llama. Un script hace lo mismo en 10 líneas. El agente no lo interpreta; lo ejecuta.
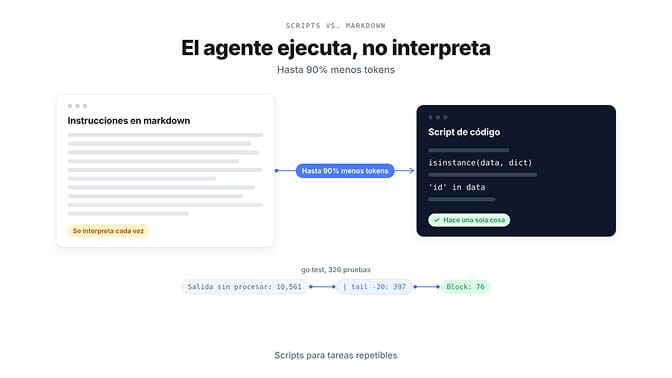
Los scripts también son más fiables. "Valida el formato" puede significar cosas diferentes en cada ejecución. Un script que comprueba isinstance(data, dict) y 'id' in data hace exactamente una cosa, siempre. El complemento "Blocks" de Caveman (aún en pre-lanzamiento) está construido sobre esta idea: scripts reutilizables que el agente ejecuta en lugar de reescribir. En una ejecución de go test con 326 tests, la salida bruta era de 10,561 tokens, | tail -20 la bajó a 397, y el bloque la bajó a 76.
Para skills que ejecutan acciones consistentes y repetibles (procesamiento de datos, gestión de archivos, llamadas a API, conversión de formato), escríbelas como scripts de código. Reserva las instrucciones en markdown para skills que necesitan interpretación flexible.
Método 4: Recorte de servidores MCP (el drenaje de tokens invisible)
Cada servidor MCP conectado a tu agente carga sus definiciones de herramientas en la ventana de contexto, en cada mensaje, en cada turno, tanto si usas esas herramientas en esa interacción como si no.
MindStudio midió que un único servidor MCP puede llegar a 18,000 tokens por turno solo en overhead de definición de herramientas. Conecta tres servidores con muchas funciones y puedes gastar 50,000+ tokens por conversación en esquemas de herramientas que el agente nunca llama. Damian Galarza descubrió que las definiciones de herramientas MCP pueden ocupar el 24% o más de la ventana de contexto antes de que se envíe un solo mensaje. Para algunas herramientas, las llamadas directas a la API en lugar de MCP evitan completamente este overhead.
La solución es sencilla pero a menudo pasada por alto: desconecta los servidores MCP que no estás usando ahora. Si la tarea de hoy no necesita GitHub, desconéctalo. Si esta sesión solo necesitas Slack, no cargues también Jira, HubSpot y Google Drive. (Para más detalles sobre dónde encaja MCP frente a las skills, consulta nuestra guía sobre Skills de agente vs MCP.)
Anthropic abordó parte de esto en enero de 2026 con MCP Tool Search. En versiones recientes de Claude Code, está activo por defecto: las herramientas MCP se aplazan y se encuentran bajo demanda en lugar de cargarse todas por adelantado (ENABLE_TOOL_SEARCH=auto revierte al comportamiento antiguo de "solo después de superar el 10% del contexto"). Pero no todos los frameworks de agentes hacen esto, y Claude Code 2.1.296 (9 de octubre de 2026) duplicó el límite predeterminado de las descripciones de herramientas MCP enviadas por adelantado de 2,048 a 4,096 caracteres. Descripciones más largas permitidas significan más tokens por herramienta donde sea que las herramientas se carguen por adelantado, por lo que el recorte se vuelve más importante, no menos.
En BetterClaw, los agentes funcionan como clientes MCP y tú marcas solo las herramientas necesarias en cada servidor MCP, el mismo recorte sin editar archivos de configuración. Las Skills se cargan de la misma manera: solo las skills relevantes para la tarea actual usan tokens de contexto.
Método 5: Inyección de contexto en lugar de reenvío de contexto
El hábito más costoso de todos es reenviar el mismo contexto de proyecto en cada conversación.
Estructura del proyecto: 800 tokens. Dependencias: 600. Estándares de código: 400. Decisiones de arquitectura: 700. Documentación de API: 500. Decisiones anteriores: 400. Total: 3,400 tokens enviados al inicio de cada conversación. Diez conversaciones al día significan 34,000 tokens para contexto repetido; en un mes, más de 1,000,000 de tokens que no aportan información nueva.
La solución: almacena el contexto en formato persistente y eficiente, luego inyéctalo según sea necesario en lugar de reenviar en formato bruto. Es lo que hace el caché de prompts a nivel de proveedor (en Claude Opus 5.5, las entradas en caché cuestan $0.20 por millón de tokens frente a $4 sin caché; consulta nuestra guía sobre caché de prompts para agentes). También puedes hacerlo a nivel de skill, y eso es exactamente lo que hacen caveman-compress y claude-token-optimizer: en lugar de cargar un README de 2,000 tokens, mantén un resumen de 200 tokens con las decisiones y convenciones que importan, y deja que el agente abra el archivo completo solo cuando sea necesario.
¿Cómo recortan costos las herramientas de compresión de tokens sin reducir la calidad de la salida?
Descartan palabras que ni el modelo ni el lector necesitan y dejan las partes que llevan significado exactamente como están. Caveman deja el código, los comandos y los mensajes de error intactos y solo descarta la prosa alrededor; RTK filtra el ruido de las salidas de comandos antes de que el agente las lea. JetBrains midió un 8,5% menos de tokens de salida sin caída medible de calidad al usar Caveman en 86 tareas de codificación.
La calidad baja en dos lugares. Los resúmenes de contexto de proyecto excesivamente comprimidos pueden omitir decisiones que el agente necesita, así que empieza con compresión ligera y verifica los outputs antes de ir más lejos. Y la prosa concisa no sirve para nada que los clientes vayan a leer. Comprime lo que leen las máquinas; deja como está lo que leen los humanos.
El efecto compuesto
Estos métodos no se suman; se multiplican. La compresión de salida recorta los tokens por respuesta entre un 65 y un 75% en su nivel máximo. Acertar a la primera elimina entre un 30 y un 50% de las idas y vueltas. Los scripts de código recortan el overhead de instrucciones hasta un 90%. El recorte de MCP recupera el 24%+ de la ventana de contexto. La inyección de contexto elimina el 90%+ del contexto repetido.
Aplica los cinco, y una sesión que usaría 150,000 tokens puede usar solo 25,000–40,000. El mismo trabajo, la misma calidad de salida, un costo entre un 75 y un 85% menor.
Un kit de inicio práctico para Claude Code:
- Ejecuta
/contextynpx -y claude-token-optimizer measurepara ver tu línea base. - Recorta el CLAUDE.md a menos de 200 líneas o ejecuta caveman-compress en él.
- Instala RTK y ejecuta
rtk init -g. - Instala Caveman y usa
/cavemanpara sesiones de codificación, desactívalo para escribir. - Desconecta los servidores MCP que no usas hoy.
- Mide de nuevo con
npx ccusage@latestdespués de una semana.
Gartner proyecta que el 40% de las aplicaciones empresariales incorporará agentes de IA para finales de 2026. A medida que crece la adopción, los equipos que optimizan los costos de tokens ahora son los que pueden ejecutar más agentes, con más frecuencia, en problemas más difíciles. Para el lado de selección de modelo del mismo problema, consulta nuestra guía de configuración de enrutamiento de modelos y nuestra guía para recortar los costos de API de agentes en un 80%.
Entra a BetterClaw si quieres que la optimización de tokens se gestione para ti. Gestión de contexto que previene la inflación por diseño, skills cargadas solo cuando se necesitan, 500+ conectores con selección de MCP por herramienta en planes de pago y 28+ proveedores de modelos con tu propia clave sin margen. Crea una cuenta en BetterClaw, y Pro cuesta $49/mes para 5 agentes, con un interruptor de apagado (kill switch) en todos los planes. Nosotros gestionamos los costos de tokens. Tú gestionas la lógica del agente.
Preguntas frecuentes
¿Cuáles son las mejores skills de Claude para reducir el uso de tokens?
Caveman para la salida (4,119 tokens de salida en lugar de 6,983 en modo estándar y 2,693 en /ultracave en los propios tests de diez preguntas), RTK para la salida de shell y tests (60–90% menor en comandos dev comunes) y caveman-compress o claude-token-optimizer para los archivos que Claude carga al inicio de la sesión. Añade el recorte de MCP y habrás abordado las cuatro mayores fuentes de desperdicio. La mayoría de las demás skills añaden tokens.
¿Las skills ahorran tokens?
Solo las creadas para eliminar tokens. Las skills que comprimen la salida, comprimen archivos o redirigen a modelos más baratos ahorran tokens; las skills que añaden capacidades (búsqueda, herramientas, acceso a archivos) añaden tokens. Incluso las skills que ahorran tienen un costo: las reglas de Caveman añaden aproximadamente 1,000–1,500 tokens de entrada por turno mientras están activas, y lo compensan recortando tokens de salida, que cuestan 5× en Claude.
¿Qué es la skill Caveman?
Una skill de código abierto para Claude Code y 30+ agentes de codificación más (JuliusBrussee/caveman, ~115,000 estrellas en GitHub) que hace que el agente responda con lenguaje conciso y directo manteniendo el código exactamente como está. Instálala en Claude Code con claude plugin marketplace add JuliusBrussee/caveman y claude plugin install caveman@caveman, luego usa /caveman, /ultracave o /caveman off.
¿Existe alguna skill de optimización de tokens para Claude Code?
Sí. El claude-token-optimizer de nadimtuhin recorta lo que Claude Code carga al inicio de la sesión (~11,000 a ~800 tokens de arranque en el proyecto del autor); ejecuta npx -y claude-token-optimizer measure para comprobar el tuyo. Otros repositorios con nombres similares son protocolos de prompt y checklists más pequeños.
¿Qué es RTK (Rust Token Killer)?
Un único binario en Rust (rtk-ai/rtk, ~85,000 estrellas en GitHub) que filtra las salidas de comandos antes de que tu agente las lea, recortándolas entre un 60 y un 90% en comandos dev comunes. RTK funciona con Claude Code, Codex, Cursor, Copilot, Gemini CLI y otras 13 herramientas. Instálalo con brew install rtk, luego rtk init -g (añade --codex para Codex).
¿Cómo reducir el uso de tokens en Claude Code sin instalar nada?
Comprueba /context, mantén el CLAUDE.md por debajo de 200 líneas, añade reglas de denegación de Read para carpetas de build y lockfiles, usa /clear entre tareas y /compact dentro de tareas largas, mantén activo el MCP Tool Search, desconecta los servidores MCP que no usas y usa el modo de planificación antes de cambios grandes.
¿Cuánto recortan realmente los costos las skills de reducción de tokens?
Cada método ofrece resultados medibles: la compresión de salida ahorra entre un 65 y un 75% por respuesta en su nivel máximo (Towards AI), los scripts de código ahorran hasta un 90% en comparación con markdown (MindStudio) y el recorte de MCP puede recuperar el 24%+ de la ventana de contexto (Damian Galarza). Combinados, se multiplican en una reducción total de entre un 75 y un 85% por sesión. En nuestro ejemplo de cálculo, un agente de solo Opus con 200 llamadas al día baja de ~$304 a ~$56 al mes.
¿Las skills de reducción de tokens pueden bajar la calidad de la salida?
La compresión de salida reduce las explicaciones, lo cual está bien para código pero menos para contenido escrito, así que hazla activable y desactivable. Acertar a la primera y los scripts de código mejoran la calidad mientras reducen tokens. El recorte de MCP solo afecta a los tokens, siempre que mantengas los servidores que necesitas. La compresión de contexto puede bajar la calidad si el resumen omite decisiones importantes; empieza con compresión ligera y verifica los outputs antes de ir más lejos.
¿Las skills de reducción de tokens funcionan en BetterClaw?
Sí. Con tu propia clave de modelo (BYOK), cada token que ahorras va directamente a tu cuenta del proveedor, sin margen. La gestión de contexto ya está integrada: las skills solo se cargan cuando la tarea las necesita, y en planes de pago puedes marcar qué herramientas expone cada servidor MCP al agente.