A maioria das skills aumenta o uso de tokens. As skills abaixo reduzem: Caveman, RTK, caveman-compress e claude-token-optimizer, além dos cinco métodos por trás delas, com comandos de instalação, números honestos e quanto cada uma realmente economiza.
A maioria das skills aumenta os tokens. Skills adicionam contexto, instruções e verificações de qualidade — e tudo isso é cobrado. Então a pergunta útil não é "quais skills reduzem tokens?", mas "quais skills descartam mais tokens do que adicionam?"
Em determinado mês, minha conta do Claude Code chegou a $87. Não era absurdo. Mas quando fui ver para onde os tokens estavam indo, o resultado foi deprimente.
Cerca de 40% era protocolo. "Claro! Ficaria feliz em ajudá-lo a refatorar essa função. Deixa eu explicar as mudanças passo a passo..." Esse tipo de abertura custa tokens e não acrescenta nada. Multiplicado por 200 interações, você está pagando por um assistente educado que não para de explicar coisas que você não pediu que fossem explicadas.
Outros 30% eram reprompts. O agente construiu a coisa errada porque as instruções eram ambíguas. Eu expliquei a correção. O agente reconstruiu. Duas idas e voltas em vez de uma, o dobro de tokens para o mesmo resultado.
Os últimos 30% eram trabalho de verdade.
Este guia cobre as skills e ferramentas que os desenvolvedores realmente instalam para resolver isso, quanto cada uma economiza em termos mensuráveis e os cinco métodos por trás delas — para que você possa escolher o que se encaixa ao invés de instalar tudo.
As skills realmente reduzem o uso de tokens?
Sim, mas só algumas. Skills que comprimem saída, comprimem arquivos que o Claude lê ou direcionam o trabalho para modelos mais baratos reduzem tokens por chamada. Skills que adicionam capacidades (busca na web, leitura de arquivos, chamada de ferramentas) aumentam o uso de tokens, porque adicionam instruções próprias, esquemas de ferramentas e resultados de ferramentas ao contexto.
Até as skills que economizam tokens têm um custo. Skills são carregadas sob demanda no Claude Code (cada uma usa cerca de 30 a 100 tokens na inicialização para nome e descrição, de acordo com análise do Firecrawl), mas quando uma skill está ativa, todas as suas instruções estão no contexto. O README do próprio Caveman cita cerca de 1.160 tokens de entrada para suas regras, e a análise do Skillselion cita cerca de 1.000 a 1.500 por turno. No geral, a skill ainda economiza tokens porque tokens de saída no Claude custam 5× os tokens de entrada — mas a economia é menor do que o número principal sugere.
Então o efeito líquido depende de quais skills você instala. As abaixo foram criadas para descartar tokens, não para adicionar funcionalidades.
Melhores skills e ferramentas do Claude para reduzir uso de tokens (outubro de 2026)
| Skill ou ferramenta | O que corta | Economia medida | Funciona com | Instalação |
|---|---|---|---|---|
| Caveman | Tokens de saída: respostas concisas, código inalterado | 4.119 vs. 6.983 tokens de saída em 10 perguntas dev (/caveman), 2.693 com /ultracave | Claude Code, Codex, Gemini CLI, Cursor, Copilot, OpenCode e 30+ agentes | claude plugin marketplace add JuliusBrussee/caveman, depois claude plugin install caveman@caveman |
| caveman-compress (parte do Caveman) | Tokens de entrada: CLAUDE.md e outros arquivos de memória | 6.198 para 4.138 tokens em cinco arquivos | Qualquer agente que carregue arquivos de memória | Incluído no Caveman |
| RTK, Rust Token Killer | Tokens de entrada: saídas de shell, build e testes | 60 a 90% em comandos dev comuns (somente saída bash) | Claude Code, Codex, Cursor, Copilot, Gemini CLI, Windsurf, Cline, OpenClaw, Hermes e outros (18 ferramentas) | brew install rtk, depois rtk init -g |
| claude-token-optimizer | Tokens de entrada no início da sessão | ~11.000 para ~800 tokens de inicialização no projeto do autor | Claude Code | npx -y claude-token-optimizer measure |
| claude-code-router | Custo por token: direciona requisições para o modelo de sua escolha | Depende das suas regras de roteamento | Claude Code e outros agentes de codificação | Ver repositório |
| ccusage | Não corta diretamente: mede uso e custo | Mostra para onde vão os tokens | Claude Code e outros CLIs de codificação | npx ccusage@latest |
Contagens de estrelas do GitHub em 27 de outubro de 2026: Caveman ~115.000, RTK ~85.000, claude-token-optimizer ~630. Os números de economia são medições dos próprios projetos, salvo indicação em contrário.
Caveman: skill para reduzir tokens de saída
Caveman é a skill de redução de tokens para Claude Code com mais estrelas, com cerca de 115.000 estrelas no GitHub (v4.0.1, lançada em 13 de outubro de 2026). Ela faz o agente responder com estilo conciso e direto, mantendo código, comandos e texto de erros exatamente como estão. Ative com /caveman, modo mais agressivo com /ultracave, desative com /caveman off ou "stop caveman". No Codex, o ativador é $caveman.
Instalação no Claude Code:
claude plugin marketplace add JuliusBrussee/caveman
claude plugin install caveman@caveman
Para Codex, Gemini CLI, OpenCode e outros agentes compatíveis, o instalador do projeto cuida de tudo em um passo:
npx @caveman-ai/cli@latest
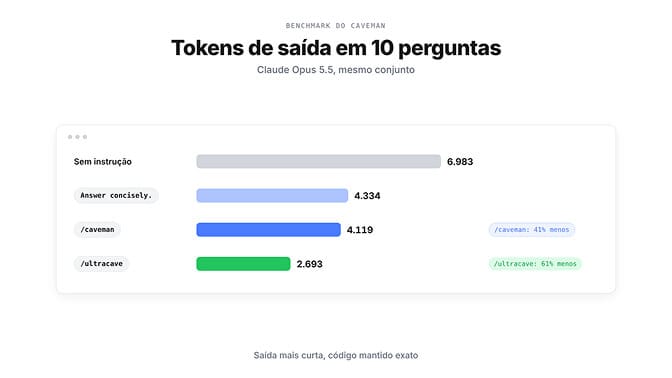
Números honestos: em dez perguntas de desenvolvimento executadas no Claude Opus 5.5, a saída caiu de 6.983 tokens para 4.119 com /caveman e 2.693 com /ultracave. A instrução simples "Answer concisely." atingiu 4.334 no mesmo conjunto, e o próprio README a cita como baseline real: em comparação, /caveman corta 3% a mais na mediana e /ultracave, 35% a mais. Portanto, a maior parte da economia no modo padrão é possível sem a skill; /ultracave é onde ela se destaca.
O projeto também reporta 33,2% menos tokens de entrada em 54 sessões completas do Claude Code (testes de agosto de 2026 em uma versão mais antiga), graças a recursos adicionais que comprimem logs, JSON e saídas de testes antes que o modelo as leia. A JetBrains mediu 8,5% menos tokens de saída em 86 tarefas de codificação reais sem queda mensurável de qualidade, e a Elastic, 63,6% menos tokens de resposta em oito cenários de MCP — portanto, seus resultados provavelmente dependem muito de quão verboso o seu agente costuma ser.
A desvantagem: saída comprimida soa fria. Para código e trabalho técnico, tudo bem. Para conteúdo voltado ao cliente ou qualquer coisa que precise de tom preciso, desligue.
RTK (Rust Token Killer): para reduzir tokens de saída de shell
RTK é um único binário em Rust que fica entre seu agente e o terminal. Quando o agente executa git status, cargo test ou npm install, o RTK filtra a saída para que apenas as partes relevantes entrem no contexto. O projeto alega saída 60 a 90% menor em comandos dev comuns e suporta 18 ferramentas de codificação com IA, incluindo Claude Code, Codex, Cursor, GitHub Copilot e Gemini CLI.
brew install rtk
rtk init -g       # Claude Code
rtk init -g --codex  # Codex
Duas observações do próprio projeto: a economia se aplica apenas a saídas bash (o hook ativa em chamadas de ferramenta Bash), não a toda a sua conta. E as contagens de tokens são estimadas pelo tamanho em bytes, então confie mais nas porcentagens do que nos números absolutos. Também existe outro projeto chamado "rtk" no crates.io, então certifique-se de que rtk gain funciona após a instalação.
RTK combina bem com Caveman: Caveman reduz o que o agente escreve, RTK reduz o que ele lê.
caveman-compress e claude-token-optimizer: arquivos menores no início da sessão
O Claude Code carrega seu CLAUDE.md e seus arquivos de memória no início de cada sessão, antes mesmo de você digitar algo. O Firecrawl mediu de 20.000 a 30.000 tokens carregados antes do primeiro prompt em uma configuração típica. Duas ferramentas lidam diretamente com isso:
- caveman-compress reescreve arquivos de memória como o CLAUDE.md em forma comprimida (o arquivo é enviado para o modelo que você configurar para fazer isso). A verificação do projeto em cinco arquivos caiu de 6.198 para 4.138 tokens, uma redução de 23 a 49% por arquivo.
- claude-token-optimizer mantém um CLAUDE.md curto e alguns arquivos de referência pequenos carregados, e move documentação antiga, notas de sessão e listas de tarefas concluídas para arquivos que o Claude só lê quando necessário. No projeto RedwoodJS do autor, os tokens de inicialização caíram de ~11.000 para ~800. Execute
npx -y claude-token-optimizer measurepara ver seus próprios números primeiro.
Esta é a única economia que você obtém em toda sessão, por isso costuma ser o melhor lugar para começar.
Existe alguma skill de otimização de tokens?
Sim, alguns projetos usam esse nome. O mais prático é o claude-token-optimizer do nadimtuhin (acima), que corta o que o Claude carrega no início da sessão. Outros são menores e funcionam de forma diferente: o claude-token-optimizer do KINGSTAR-OMEGA é um par de protocolos de prompt (um cria um plano em arquivo e faz perguntas de esclarecimento, o outro força respostas apenas em JSON), e a skill rescue-tokens do valorisa é uma checklist para conversas longas, saídas verbosas, modelos errados e servidores MCP em excesso.
Na prática, "otimização de tokens" vem de uma combinação de ferramentas, cada uma lidando com uma parte da conta: Caveman para saída, RTK para saída de shell, otimizador de início de sessão para arquivos de memória e corte de MCP para esquemas de ferramentas.
Como reduzir o uso de tokens em seu agente de IA
Antes de escolher uma skill, entenda para onde vão seus tokens. Uma chamada típica de agente tem quatro partes, e cada uma consome tokens:
- Prompt de sistema (as instruções do seu agente): normalmente 300 a 800 tokens, enviados em cada chamada.
- Esquemas de ferramentas e skills: cerca de 100 a 200 tokens por ferramenta, enviados em cada chamada.
- Histórico de conversa: cresce a cada turno e frequentemente é o maior custo.
- Resposta do modelo: cobrada como tokens de saída, que custam 5× a taxa de entrada no Claude.
As formas mais rápidas de cortar sua conta:
Encurte seu prompt de sistema. Cada palavra nele é enviada em cada chamada. Um prompt de 500 palavras (~650 tokens) custa cerca de $0,0013 por chamada no Claude Sonnet 5.5, ou $0,26 por dia em 200 chamadas. Pequeno isoladamente, mas se acumula em cada agente e cada chamada. Corte para 200 palavras e esse custo cai 60%.
Limite o histórico de conversa. A maioria dos agentes não precisa de todo o histórico em cada chamada. Uma janela deslizante de 3 a 5 turnos recentes corta o contexto em 70 a 80% em conversas longas. Cortar um histórico de 8.000 tokens para 2.000 tokens economiza $4,80 por dia em 200 chamadas no Claude Opus 5.5.
Carregue apenas as ferramentas de que precisa. Cada esquema de ferramenta MCP adiciona 100 a 300 tokens a cada chamada. Um agente com 10 ferramentas MCP envia 1.000 a 3.000 tokens de esquema em cada requisição, mesmo que a maioria dessas ferramentas nunca seja usada. (O Método 4 abaixo aborda o corte de MCP em profundidade.)
Use modelos mais baratos para tarefas simples. Classificação, tagging e roteamento não precisam de modelos de fronteira. O Claude Haiku 5.5 ($0,10/$0,50 por milhão de tokens para prompts de até 100K tokens) é 97,5% mais barato que o Claude Opus 5.5 ($4/$20).
Depois disso, use as skills acima e os métodos abaixo para otimizar o restante.
Como reduzir o uso de tokens no Claude Code (opções nativas)
O Claude Code tem vários controles nativos de tokens. Use-os antes de instalar qualquer coisa (todos do guia de preços da Anthropic):
/contextmostra o que está preenchendo sua janela de contexto no momento. Comece aqui./compactresume a conversa até agora;/clearrecomeça do zero quando você muda de tarefa./clearnão custa tokens;/compactem si é uma requisição grande, então use clear entre tarefas não relacionadas.- Mantenha o CLAUDE.md curto. A orientação da Anthropic é abaixo de 200 linhas por arquivo; o Firecrawl cortou um arquivo de 3.847 tokens para 312.
- Regras de negação de
Readempermissions.denyimpedem o Claude de ler pastas de build, lockfiles e código gerado automaticamente. Arquivos.claudeignorenão têm efeito; a documentação da Anthropic recomenda mover o conteúdo para regras de negação. - Regras baseadas em caminho em
.claude/rules/(com frontmatterpaths:) são carregadas apenas quando o Claude está trabalhando com arquivos correspondentes. - MCP Tool Search (ativo por padrão em versões recentes do Claude Code) adia ferramentas MCP e as encontra sob demanda, em vez de carregar todos os esquemas antecipadamente.
- Modo de planejamento (pressione Shift+Tab até a barra de status mostrar modo de planejamento) antes de grandes mudanças corta trabalho na direção errada — o tipo mais caro.
Como reduzir o uso de tokens no Codex
As mesmas ferramentas funcionam no Codex CLI da OpenAI. RTK é instalado para Codex com rtk init -g --codex, e o instalador npx do Caveman também cobre o Codex. Um bom arquivo AGENTS.md também economiza tokens: em um estudo de 124 pull requests em 10 repositórios, executados com e sem o arquivo (Lulla et al., arXiv:2601.20404), AGENTS.md reduziu os tokens de saída em 16,6% e o tempo de execução médio em 28,6%. Nosso guia de melhores práticas do AGENTS.md explica como escrevê-lo.
Quanto a redução de tokens realmente economiza (em dólares)
Aqui estão os custos típicos de um agente antes e depois da otimização, em 200 chamadas por dia:
| Antes | Após otimização | Economia | |
|---|---|---|---|
| Prompt de sistema | 500 palavras (~650 tokens) | 200 palavras (~260 tokens) | 60% |
| Esquemas de ferramentas | 10 ferramentas (~2.000 tokens) | 3 ferramentas (~600 tokens) | 70% |
| Histórico | Completo (~8.000 tokens) | Últimos 3 turnos (~2.000 tokens) | 75% |
| Comprimento da resposta | ~400 tokens | ~150 tokens (comprimido) | 62% |
| Modelo | Opus 5.5 para tudo | Sonnet 5.5 para 70% das chamadas, Opus 5.5 para trabalho complexo | 50% por chamada roteada |
| Custo por chamada | ~$0,051 | ~$0,0094 | 81% |
| Custo diário (200 chamadas) | ~$10,12 | ~$1,88 | economia de $8,24/dia |
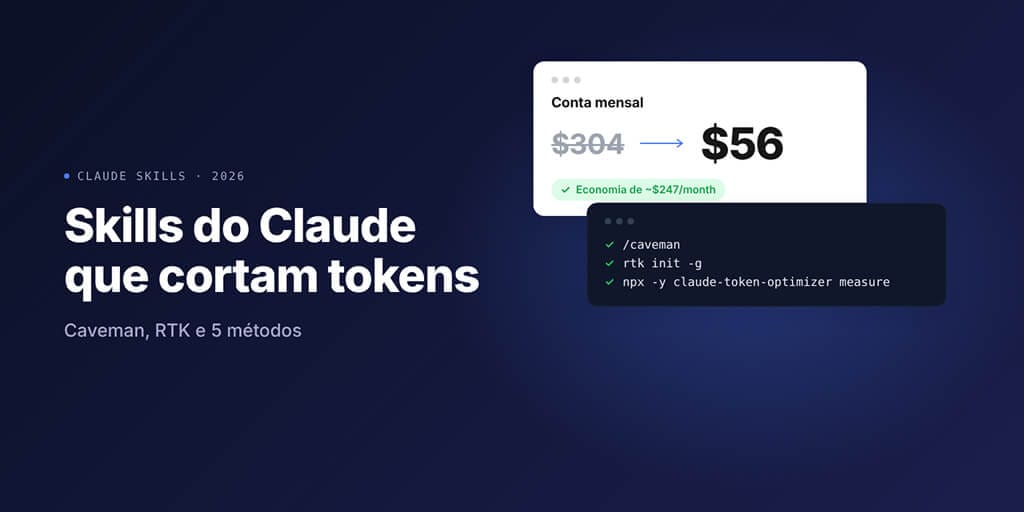
| Custo mensal (30 dias) | ~$304 | ~$56 | economia de ~$247/mês |
Esses números usam os preços de API da Anthropic de outubro de 2026 (Claude Sonnet 5.5 a $2/$10 por milhão de tokens de entrada/saída, Claude Opus 5.5 a $4/$20) e não incluem o cache de prompt, que reduziria ambas as colunas ainda mais. Mesmo sem roteamento de modelo, cortar contexto e saída sozinho já reduz uma conta somente Opus de ~$304 para ~$87 por mês. Direcione 70% das chamadas mais simples para o Claude Haiku 5.5 em vez do Sonnet, e a coluna "após" cai ainda mais. Usuários BYOK no BetterClaw pagam diretamente ao provedor nessas tarifas, sem markup algum.
Os 5 métodos por trás de cada skill que economiza tokens
Cada ferramenta acima funciona por um desses cinco métodos. Se uma skill que você está considerando não faz nenhum deles, provavelmente adiciona tokens em vez de reduzir.
Método 1: Compressão de saída (a abordagem "Caveman")
A otimização de tokens mais discutida é forçar o agente a se comunicar com linguagem concisa e direta: sem frases de preenchimento, aberturas cerimoniosas, frases de transição ou explicações passo a passo que você não pediu.
Sem compressão: "Concluí com êxito a refatoração do módulo de autenticação. As mudanças incluem a atualização da lógica de validação de token, a reestruturação da cadeia de middleware e a adição de tratamento de erros abrangente. Aqui está uma explicação detalhada de cada alteração..." São 45 tokens apenas embrulhando o conteúdo real.
Com compressão: "Módulo de auth refatorado. Validação de token atualizada. Middleware reestruturado. Tratamento de erros adicionado." Mesma informação. 12 tokens.
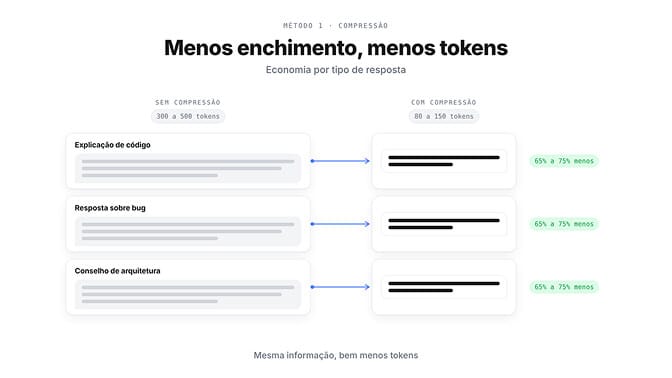
Os números: respostas típicas têm de 300 a 500 tokens sem compressão e 80 a 150 com compressão agressiva. Em 30 trocas de mensagens por sessão, isso representa uma economia de 9.000 a 12.000 tokens. Towards AI realizou benchmark dessa abordagem com redução de 75% por sessão; os próprios testes do Caveman mostram 41% menos tokens de saída em comparação com nenhuma instrução no modo padrão e 61% no /ultracave. O guia de criação de skills da Anthropic fornece um exemplo ilustrativo do mesmo efeito: uma tarefa que precisava de 15 mensagens e 12.000 tokens sem skills precisou apenas de 2 perguntas de esclarecimento e 6.000 tokens com skills.
A desvantagem: saída comprimida soa fria. Torne-a ativável e desativável — não permanente.
Método 2: Acertar na primeira tentativa (acerto de primeira)
Este não parece otimização de tokens — mas é o maior deles.
Skills que capturam bugs antes de você fazer commit significam menos conversas "corrija o bug que você acabou de criar". Skills que conhecem o framework de testes do seu projeto produzem testes que passam de primeira. Skills de arquitetura que conhecem suas convenções evitam que o agente gere código com estrutura errada, que você depois precisa pedir para retrabalhar.
Cada reprompt consome um turno completo. O agente relê o contexto, processa a correção e gera uma nova resposta. Um reprompt em um contexto de 30.000 tokens custa 30.000+ tokens para reler mais 500+ para gerar a resposta. Evite um reprompt por sessão e você economiza mais tokens do que qualquer skill de compressão de saída.
MindStudio fez benchmark de cinco skills para corte de tokens e obteve o mesmo resultado em todos os casos: menos mal-entendidos significa menos reprompts e menos tokens. A abordagem estruturada de cinco fases (planeje, depois construa, depois verifique) usou 14% menos tokens e custou 9% menos do que sessões não estruturadas no mesmo modelo.
É por isso que skills de agente que carregam as convenções do seu projeto fazem tanta diferença. Uma skill que diz ao agente "use functional components, nunca class components" evita outputs com arquitetura errada, que podem custar 50.000+ tokens para corrigir.
Método 3: Scripts de código em vez de instruções em markdown
Este é contraintuitivo. A maioria das skills é escrita em markdown: instruções em linguagem natural que o agente lê e segue.
Mas o MindStudio publicou dados mostrando que scripts de código executáveis reduzem tokens em até 90% em comparação com instruções em markdown para a mesma tarefa. Instruções em markdown são inerentemente verbosas: "Quando o usuário pedir para processar dados, primeiro verifique se o arquivo existe, depois leia seu conteúdo, depois valide o formato, depois..." Isso é um parágrafo que o agente lê e interpreta a cada vez que é chamado. Um script faz a mesma coisa em 10 linhas. O agente não interpreta — executa.
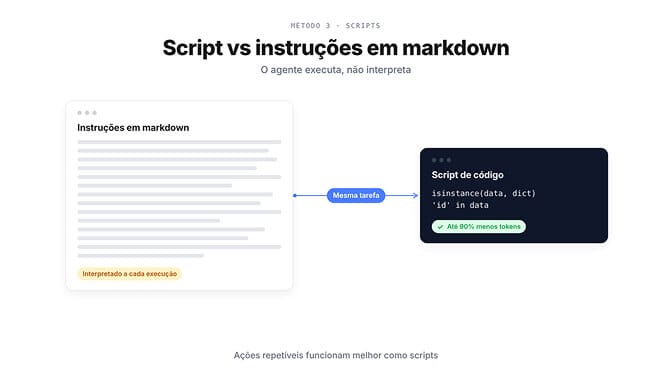
Scripts também são mais confiáveis. "Valide o formato" pode significar coisas diferentes a cada execução. Um script que verifica isinstance(data, dict) e 'id' in data faz exatamente uma coisa, sempre. O add-on "Blocks" do Caveman (ainda em pré-lançamento) é construído sobre essa ideia: scripts reutilizáveis que o agente executa em vez de reescrever. Em uma execução de go test com 326 testes, a saída bruta era de 10.561 tokens, | tail -20 reduziu para 397, e o bloco reduziu para 76.
Para skills que executam ações consistentes e repetíveis (processamento de dados, gerenciamento de arquivos, chamadas de API, conversão de formato), escreva-as como scripts de código. Reserve instruções em markdown para skills que precisam de interpretação flexível.
Método 4: Corte de servidores MCP (o dreno de tokens invisível)
Cada servidor MCP conectado ao seu agente carrega suas definições de ferramentas na janela de contexto — em cada mensagem, a cada turno — quer você use essas ferramentas nessa interação ou não.
O MindStudio mediu que um único servidor MCP pode chegar a 18.000 tokens por turno apenas em overhead de definição de ferramentas. Conecte três servidores com muitas funcionalidades e você pode gastar 50.000+ tokens por conversa em esquemas de ferramentas que o agente nunca chama. Damian Galarza descobriu que as definições de ferramentas MCP podem ocupar 24% ou mais da janela de contexto antes mesmo de uma mensagem ser enviada. Para algumas ferramentas, chamadas diretas à API em vez de MCP evitam completamente esse overhead.
A solução é simples, mas frequentemente esquecida: desconecte os servidores MCP que você não está usando agora. Se a tarefa de hoje não precisa do GitHub, desconecte-o. Se esta sessão você precisa apenas do Slack, não carregue também Jira, HubSpot e Google Drive. (Para mais detalhes sobre onde o MCP se encaixa em relação às skills, veja nosso guia sobre Skills de agente vs MCP.)
A Anthropic resolveu parte disso em janeiro de 2026 com o MCP Tool Search. Em versões recentes do Claude Code, ele está ativo por padrão: ferramentas MCP são adiadas e encontradas sob demanda em vez de todas carregadas antecipadamente (ENABLE_TOOL_SEARCH=auto reverte para o comportamento antigo "apenas após ultrapassar 10% do contexto"). Mas nem todo framework de agente faz isso, e o Claude Code 2.1.296 (9 de outubro de 2026) dobrou o limite padrão de descrições de ferramentas MCP enviadas antecipadamente de 2.048 para 4.096 caracteres. Descrições mais longas permitidas significam mais tokens por ferramenta onde quer que ferramentas sejam carregadas antecipadamente, tornando o corte mais importante, não menos.
No BetterClaw, os agentes funcionam como clientes MCP e você marca apenas as ferramentas necessárias em cada servidor MCP — o mesmo corte sem precisar editar arquivos de configuração. As Skills são carregadas da mesma forma: apenas as skills relevantes para a tarefa atual usam tokens de contexto.
Método 5: Injeção de contexto em vez de reenvio de contexto
O hábito mais dispendioso de todos é reenviar o mesmo contexto de projeto em cada conversa.
Estrutura do projeto: 800 tokens. Dependências: 600. Padrões de código: 400. Decisões de arquitetura: 700. Documentação de API: 500. Decisões anteriores: 400. Total: 3.400 tokens enviados no início de cada conversa. Dez conversas por dia significa 34.000 tokens para contexto repetido; em um mês, mais de 1.000.000 tokens que não trazem informação nova.
A solução: armazene contexto em formato persistente e eficiente, depois injete conforme necessário em vez de reenviar em formato bruto. É o que o cache de prompt faz no nível do provedor (no Claude Opus 5.5, entradas em cache custam $0,20 por milhão de tokens versus $4 sem cache; veja nosso guia sobre cache de prompt para agentes). Você também pode fazer isso no nível da skill — e é exatamente o que caveman-compress e claude-token-optimizer fazem: em vez de carregar um README de 2.000 tokens, mantenha um resumo de 200 tokens com as decisões e convenções que importam, e deixe o agente abrir o arquivo completo apenas quando necessário.
Como as ferramentas de compressão de tokens cortam custos sem reduzir a qualidade da saída?
Elas descartam palavras de que o modelo ou o leitor não precisa e deixam as partes que carregam significado exatamente como estão. O Caveman deixa código, comandos e mensagens de erro intocados e apenas descarta a prosa ao redor; o RTK filtra o ruído de saídas de comandos antes que o agente as leia. A JetBrains mediu 8,5% menos tokens de saída sem queda mensurável de qualidade ao usar o Caveman em 86 tarefas de codificação.
A qualidade cai em dois lugares. Resumos de contexto de projeto excessivamente comprimidos podem omitir decisões de que o agente precisa, então comece com compressão leve e verifique os outputs antes de ir mais longe. E prosa concisa não serve para nada que clientes irão ler. Comprima o que as máquinas leem; deixe como está o que humanos leem.
O efeito composto
Esses métodos não se somam — se multiplicam. Compressão de saída corta tokens por resposta em 65 a 75% no nível máximo. Acerto de primeira elimina 30 a 50% das idas e voltas. Scripts de código cortam o overhead de instruções em até 90%. Corte de MCP recupera 24%+ da janela de contexto. Injeção de contexto elimina 90%+ do contexto repetido.
Aplique todos os cinco, e uma sessão que usaria 150.000 tokens pode usar apenas 25.000 a 40.000. Mesmo trabalho, mesma qualidade de saída, 75 a 85% menos custo.
Um kit inicial prático para Claude Code:
- Execute
/contextenpx -y claude-token-optimizer measurepara ver sua baseline. - Corte o CLAUDE.md para menos de 200 linhas ou execute caveman-compress nele.
- Instale o RTK e execute
rtk init -g. - Instale o Caveman e use
/cavemanpara sessões de codificação, desligue para escrita. - Desconecte servidores MCP que você não usa hoje.
- Meça novamente com
npx ccusage@latestapós uma semana.
A Gartner projeta que 40% dos aplicativos empresariais incorporarão agentes de IA até o final de 2026. À medida que a adoção cresce, as equipes que otimizam custos de tokens agora são as que podem executar mais agentes, com mais frequência, em problemas mais difíceis. Para o lado de seleção de modelo do mesmo problema, veja nosso guia de configuração de roteamento de modelos e nosso guia para cortar custos de API de agentes em 80%.
Acesse o BetterClaw se você quiser que a otimização de tokens seja gerenciada para você. Gerenciamento de contexto que previne inchaço por design, skills carregadas apenas quando necessárias, 500+ conectores com seleção de MCP por ferramenta em planos pagos e 28+ provedores de modelos com sua própria chave sem markup. Crie uma conta no BetterClaw, e o Pro custa $49/mês para 5 agentes, com kill switch em todos os planos. Nós cuidamos dos custos de token. Você cuida da lógica do agente.
Perguntas frequentes
Quais são as melhores skills do Claude para reduzir o uso de tokens?
Caveman para saída (4.119 tokens de saída em vez de 6.983 no modo padrão e 2.693 no /ultracave nos próprios testes de dez perguntas), RTK para saída de shell e testes (60 a 90% menor em comandos dev comuns) e caveman-compress ou claude-token-optimizer para arquivos que o Claude carrega no início da sessão. Adicione corte de MCP e você terá tratado as quatro maiores fontes de desperdício. A maioria das outras skills adiciona tokens.
Skills economizam tokens?
Apenas as que foram criadas para descartar tokens. Skills que comprimem saída, comprimem arquivos ou direcionam para modelos mais baratos economizam tokens; skills que adicionam capacidades (busca, ferramentas, acesso a arquivos) adicionam tokens. Até as skills que economizam têm um custo: as regras do Caveman adicionam cerca de 1.000 a 1.500 tokens de entrada por turno enquanto ativas, e fecharão isso cortando tokens de saída, que custam 5× no Claude.
O que é a skill Caveman?
Uma skill de código aberto para Claude Code e 30+ outros agentes de codificação (JuliusBrussee/caveman, ~115.000 estrelas no GitHub) que faz o agente responder com linguagem concisa e direta mantendo o código exatamente como está. Instale no Claude Code com claude plugin marketplace add JuliusBrussee/caveman e claude plugin install caveman@caveman, depois use /caveman, /ultracave ou /caveman off.
Existe alguma skill de otimização de tokens para Claude Code?
Sim. O claude-token-optimizer do nadimtuhin corta o que o Claude Code carrega no início da sessão (~11.000 para ~800 tokens de inicialização no projeto do autor); execute npx -y claude-token-optimizer measure para verificar o seu. Outros repositórios com nomes semelhantes são protocolos de prompt menores e checklists.
O que é RTK (Rust Token Killer)?
Um único binário em Rust (rtk-ai/rtk, ~85.000 estrelas no GitHub) que filtra saídas de comandos antes que seu agente as leia, cortando-as em 60 a 90% em comandos dev comuns. RTK funciona com Claude Code, Codex, Cursor, Copilot, Gemini CLI e outras 13 ferramentas. Instale com brew install rtk, depois rtk init -g (adicione --codex para Codex).
Como reduzir o uso de tokens no Claude Code sem instalar nada?
Verifique /context, mantenha o CLAUDE.md com menos de 200 linhas, adicione regras de negação de Read para pastas de build e lockfiles, use /clear entre tarefas e /compact dentro de tarefas longas, mantenha o MCP Tool Search ativo, desconecte servidores MCP que você não usa e use modo de planejamento antes de grandes mudanças.
Quanto as skills de redução de tokens realmente cortam os custos?
Cada método apresenta resultados mensuráveis: compressão de saída economiza 65 a 75% por resposta no nível máximo (Towards AI), scripts de código economizam até 90% em comparação com markdown (MindStudio) e corte de MCP pode recuperar 24%+ da janela de contexto (Damian Galarza). Combinados, eles se multiplicam para uma redução total de 75 a 85% por sessão. Em nosso cálculo de exemplo, um agente somente Opus com 200 chamadas por dia cai de ~$304 para ~$56 por mês.
As skills de redução de tokens podem diminuir a qualidade da saída?
Compressão de saída reduz explicações — o que é bom para código, mas menos para conteúdo escrito — então torne-a ativável e desativável. Acerto de primeira e scripts de código melhoram a qualidade enquanto reduzem tokens. Corte de MCP afeta apenas tokens, desde que você mantenha os servidores de que precisa. Compressão de contexto pode diminuir a qualidade se o resumo omitir decisões importantes; comece com leveza e verifique os outputs antes de ir mais longe.
As skills de redução de tokens funcionam no BetterClaw?
Sim. Com sua própria chave de modelo (BYOK), cada token que você economiza vai direto para sua conta do provedor — sem markup. O gerenciamento de contexto já está integrado: skills são carregadas apenas quando a tarefa precisa delas, e em planos pagos você pode marcar quais ferramentas cada servidor MCP expõe ao agente.