Die meisten Skills erhöhen den Token-Verbrauch. Die folgenden senken ihn: Caveman, RTK, caveman-compress und claude-token-optimizer sowie die fünf Methoden dahinter – mit Installationsbefehlen, ehrlichen Zahlen und dem tatsächlichen Einsparpotenzial jeder einzelnen.
Die meisten Skills erhöhen den Token-Verbrauch. Skills fügen Kontext, Anweisungen und Qualitätsprüfungen hinzu – und alles davon wird abgerechnet. Die nützliche Frage lautet also nicht „Welche Skills reduzieren Tokens?", sondern „Welche Skills verwerfen mehr Tokens, als sie hinzufügen?"
In einem Monat erreichte meine Claude Code-Rechnung $87. Nicht unverschämt. Aber als ich nachsah, wohin die Tokens gingen, war das Ergebnis ernüchternd.
Rund 40 % war Protokoll. „Natürlich! Ich helfe dir gerne beim Refactoring dieser Funktion. Lass mich die Änderungen Schritt für Schritt erklären..." Diese Art von Eröffnung kostet Tokens und bringt nichts. Multipliziert mit 200 Interaktionen zahlt man für einen höflichen Assistenten, der nicht aufhört, Dinge zu erklären, um deren Erklärung man nicht gebeten hat.
Weitere 30 % waren Re-Prompts. Der Agent baute etwas Falsches, weil die Anweisungen mehrdeutig waren. Ich erklärte die Korrektur. Der Agent baute neu. Zwei Hin-und-Hers statt eines, doppelt so viele Tokens für dasselbe Ergebnis.
Die letzten 30 % waren echte Arbeit.
Dieser Leitfaden behandelt die Skills und Tools, die Entwickler tatsächlich installieren, um das zu beheben, wie viel jedes davon messbar einspart und die fünf Methoden dahinter – damit du auswählen kannst, was passt, statt alles zu installieren.
Reduzieren Skills wirklich den Token-Verbrauch?
Ja, aber nur manche. Skills, die Output komprimieren, Dateien komprimieren, die Claude liest, oder Arbeit an günstigere Modelle weiterleiten, reduzieren Tokens pro Aufruf. Skills, die Fähigkeiten hinzufügen (Websuche, Datei-Lesen, Tool-Aufrufe), erhöhen den Token-Verbrauch, weil sie eigene Anweisungen, Tool-Schemata und Tool-Ergebnisse zum Kontext hinzufügen.
Selbst tokensparende Skills haben einen Preis. Skills werden in Claude Code bei Bedarf geladen (jede beansprucht etwa 30–100 Tokens beim Start für Name und Beschreibung, laut Firecrawl-Aufschlüsselung), aber sobald eine Skill aktiv ist, befinden sich alle ihre Anweisungen im Kontext. Das Caveman-README selbst nennt etwa 1.160 Input-Tokens für seine Regeln, und die Skillselion-Analyse nennt etwa 1.000–1.500 pro Runde. Insgesamt spart die Skill immer noch Tokens, weil Output-Tokens in Claude 5× so viel kosten wie Input-Tokens – aber die Einsparung ist kleiner als die Hauptzahl vermuten lässt.
Der Nettoeffekt hängt also davon ab, welche Skills du installierst. Die folgenden wurden zum Verwerfen von Tokens entwickelt, nicht zum Hinzufügen von Funktionen.
Die besten Claude Skills und Tools zur Reduzierung des Token-Verbrauchs (Oktober 2026)
| Skill oder Tool | Was es reduziert | Gemessene Einsparung | Funktioniert mit | Installation |
|---|---|---|---|---|
| Caveman | Output-Tokens: prägnante Antworten, Code unverändert | 4.119 vs. 6.983 Output-Tokens bei 10 Dev-Fragen (/caveman), 2.693 mit /ultracave | Claude Code, Codex, Gemini CLI, Cursor, Copilot, OpenCode und 30+ Agenten | claude plugin marketplace add JuliusBrussee/caveman, dann claude plugin install caveman@caveman |
| caveman-compress (Teil von Caveman) | Input-Tokens: CLAUDE.md und andere Speicherdateien | 6.198 auf 4.138 Tokens bei fünf Dateien | Jeder Agent, der Speicherdateien lädt | In Caveman enthalten |
| RTK, Rust Token Killer | Input-Tokens: Shell-, Build- und Test-Output | 60–90 % bei gängigen Dev-Befehlen (nur Bash-Output) | Claude Code, Codex, Cursor, Copilot, Gemini CLI, Windsurf, Cline, OpenClaw, Hermes und weitere (18 Tools) | brew install rtk, dann rtk init -g |
| claude-token-optimizer | Input-Tokens zu Sitzungsbeginn | ~11.000 auf ~800 Startup-Tokens im Projekt des Autors | Claude Code | npx -y claude-token-optimizer measure |
| claude-code-router | Kosten pro Token: leitet Anfragen an das Modell deiner Wahl weiter | Abhängig von deinen Routing-Regeln | Claude Code und andere Coding-Agenten | Siehe Repo |
| ccusage | Kürzt nicht direkt: misst Verbrauch und Kosten | Zeigt, wohin Tokens gehen | Claude Code und andere Coding-CLIs | npx ccusage@latest |
GitHub-Sternzahlen per 27. Oktober 2026: Caveman ~115.000, RTK ~85.000, claude-token-optimizer ~630. Einspar-Zahlen sind Messungen der jeweiligen Projekte, sofern nicht anders angegeben.
Caveman: Skill zur Reduzierung von Output-Tokens
Caveman ist die meistgestirnte Token-Reduktions-Skill für Claude Code mit rund 115.000 GitHub-Sternen (v4.0.1, veröffentlicht am 13. Oktober 2026). Sie lässt den Agenten prägnant und direkt antworten, während Code, Befehle und Fehlertexte exakt erhalten bleiben. Aktivierung mit /caveman, aggressiverer Modus mit /ultracave, Deaktivierung mit /caveman off oder „stop caveman". In Codex lautet der Auslöser $caveman.
Installation in Claude Code:
claude plugin marketplace add JuliusBrussee/caveman
claude plugin install caveman@caveman
Für Codex, Gemini CLI, OpenCode und andere unterstützte Agenten erledigt der Installer des Projekts alles in einem Schritt:
npx @caveman-ai/cli@latest
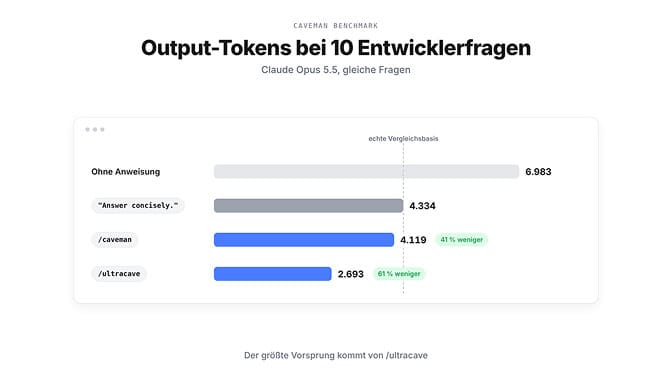
Ehrliche Zahlen: Bei zehn Dev-Fragen, ausgeführt auf Claude Opus 5.5, sank der Output von 6.983 Tokens auf 4.119 mit /caveman und 2.693 mit /ultracave. Die einfache Anweisung „Answer concisely." erreichte 4.334 bei derselben Menge, und das README selbst nennt das die eigentliche Basislinie: Verglichen damit kürzt /caveman im Median 3 % mehr und /ultracave 35 % mehr. Der Großteil der Einsparung im Standardmodus ist also ohne die Skill erreichbar; /ultracave ist der echte Unterschied.
Das Projekt berichtet außerdem von 33,2 % weniger Input-Tokens über 54 vollständige Claude Code-Sitzungen (Tests vom August 2026 mit einer älteren Version), dank zusätzlicher Funktionen, die Logs, JSON und Test-Output komprimieren, bevor das Modell sie liest. JetBrains maß 8,5 % weniger Output-Tokens bei 86 realen Coding-Aufgaben ohne messbare Qualitätseinbußen, und Elastic 63,6 % weniger Antwort-Tokens in acht MCP-Szenarien – deine Ergebnisse hängen also wahrscheinlich stark davon ab, wie gesprächig dein Agent von vornherein ist.
Der Nachteil: Komprimierter Output klingt kalt. Bei Code und technischer Arbeit macht das nichts. Bei kundenorientierten Inhalten oder allem, was den richtigen Ton braucht, schalte es aus.
RTK (Rust Token Killer): zur Reduzierung von Shell-Output-Tokens
RTK ist ein einzelnes Rust-Binary, das zwischen deinem Agenten und dem Terminal sitzt. Wenn der Agent git status, cargo test oder npm install ausführt, filtert RTK den Output, sodass nur die relevanten Teile in den Kontext gelangen. Das Projekt behauptet 60–90 % kleineren Output bei gängigen Dev-Befehlen und unterstützt 18 KI-Coding-Tools, darunter Claude Code, Codex, Cursor, GitHub Copilot und Gemini CLI.
brew install rtk
rtk init -g       # Claude Code
rtk init -g --codex  # Codex
Zwei Hinweise aus dem Projekt selbst: Die Einsparung gilt nur für Bash-Output (der Hook greift bei Bash-Tool-Aufrufen), nicht für deine gesamte Rechnung. Und Token-Zählungen werden aus der Byte-Größe geschätzt – vertraue also mehr den Prozentsätzen als den absoluten Zahlen. Es gibt auch ein anderes Projekt namens „rtk" auf crates.io, also stelle sicher, dass rtk gain nach der Installation funktioniert.
RTK ergänzt Caveman gut: Caveman verkleinert, was der Agent schreibt; RTK verkleinert, was er liest.
caveman-compress und claude-token-optimizer: kleinere Dateien zu Sitzungsbeginn
Claude Code lädt deine CLAUDE.md und Speicherdateien zu Beginn jeder Sitzung, bevor du irgendetwas tippst. Firecrawl maß 20.000–30.000 Tokens, die vor dem ersten Prompt bei einem typischen Setup geladen werden. Zwei Tools adressieren das direkt:
- caveman-compress schreibt Speicherdateien wie CLAUDE.md in komprimierter Form neu (die Datei wird an das Modell geschickt, das du dafür konfigurierst). Die Überprüfung des Projekts bei fünf Dateien sank von 6.198 auf 4.138 Tokens, eine Reduzierung von 23–49 % pro Datei.
- claude-token-optimizer hält eine kurze CLAUDE.md und einige kleine Referenzdateien geladen und verschiebt alte Dokumentation, Sitzungsnotizen und erledigte Aufgabenlisten in Dateien, die Claude nur bei Bedarf liest. Im RedwoodJS-Projekt des Autors sanken die Startup-Tokens von ~11.000 auf ~800. Führe
npx -y claude-token-optimizer measureaus, um zunächst deine eigenen Zahlen zu sehen.
Das ist die einzige Einsparung, die du in jeder Sitzung erzielst – daher ist es normalerweise der beste Ausgangspunkt.
Gibt es eine Token-Optimizer-Skill?
Ja, einige Projekte verwenden diesen Namen. Das praktischste ist der claude-token-optimizer von nadimtuhin (oben), der kürzt, was Claude zu Sitzungsbeginn lädt. Andere sind kleiner und funktionieren anders: Der claude-token-optimizer von KINGSTAR-OMEGA ist ein Paar Prompt-Protokolle (eines erstellt einen Plan in einer Datei und stellt Klärungsfragen, das andere erzwingt Antworten nur als JSON), und die rescue-tokens-Skill von valorisa ist eine Checkliste für lange Gespräche, ausführliche Ausgaben, falsche Modelle und zu viele MCP-Server.
In der Praxis stammt die „Token-Optimierung" aus einer Kombination von Tools, die jeweils einen Teil der Rechnung behandeln: Caveman für den Output, RTK für den Shell-Output, der Sitzungsstart-Optimizer für Speicherdateien und MCP-Kürzung für Tool-Schemata.
So reduzierst du den Token-Verbrauch bei deinem KI-Agenten
Bevor du eine Skill auswählst, verstehe, wohin deine Tokens gehen. Ein typischer Agenten-Aufruf besteht aus vier Teilen, und jeder verbraucht Tokens:
- System-Prompt (die Anweisungen deines Agenten): normalerweise 300–800 Tokens, bei jedem Aufruf gesendet.
- Tool- und Skill-Schemata: ungefähr 100–200 Tokens pro Tool, bei jedem Aufruf gesendet.
- Gesprächsverlauf: wächst in jeder Runde und ist oft der größte Kostenpunkt.
- Modellantwort: wird als Output-Tokens abgerechnet, die in Claude 5× den Input-Tarif kosten.
Die schnellsten Wege, deine Rechnung zu kürzen:
Kürze deinen System-Prompt. Jedes Wort darin wird bei jedem Aufruf gesendet. Ein Prompt mit 500 Wörtern (~650 Tokens) kostet bei Claude Sonnet 5.5 etwa $0,0013 pro Aufruf oder $0,26 pro Tag bei 200 Aufrufen. Klein für sich genommen, summiert sich aber über jeden Agenten und jeden Aufruf. Kürze auf 200 Wörter und dieser Kostenpunkt sinkt um 60 %.
Begrenze den Gesprächsverlauf. Die meisten Agenten brauchen nicht den gesamten Verlauf bei jedem Aufruf. Ein Sliding Window der letzten 3–5 Runden kürzt den Kontext bei langen Gesprächen um 70–80 %. Einen Verlauf von 8.000 Tokens auf 2.000 Tokens zu kürzen spart bei Claude Opus 5.5 $4,80 pro Tag bei 200 Aufrufen.
Lade nur die Tools, die du brauchst. Jedes MCP-Tool-Schema fügt jedem Aufruf 100–300 Tokens hinzu. Ein Agent mit 10 MCP-Tools sendet bei jeder Anfrage 1.000–3.000 Token-Schemata, auch wenn die meisten dieser Tools nie genutzt werden. (Methode 4 unten behandelt MCP-Kürzung ausführlich.)
Verwende günstigere Modelle für einfache Aufgaben. Klassifizierung, Tagging und Routing brauchen keine Frontier-Modelle. Claude Haiku 5.5 ($0,10/$0,50 pro Million Tokens bei Prompts bis 100K Tokens) ist 97,5 % günstiger als Claude Opus 5.5 ($4/$20).
Nutze danach die obigen Skills und die folgenden Methoden, um den Rest zu optimieren.
So reduzierst du den Token-Verbrauch in Claude Code (integrierte Optionen)
Claude Code hat mehrere integrierte Token-Steuerungen. Nutze diese, bevor du irgendetwas installierst (alle aus dem Anthropic-Preisleitfaden):
/contextzeigt, was gerade dein Kontextfenster füllt. Fang hier an./compactfasst das bisherige Gespräch zusammen;/clearfängt von vorne an, wenn du die Aufgabe wechselst./clearkostet keine Tokens;/compactselbst ist eine große Anfrage, also verwende clear zwischen unzusammenhängenden Aufgaben.- Halte CLAUDE.md kurz. Der Anthropic-Leitfaden empfiehlt unter 200 Zeilen pro Datei; Firecrawl kürzte eine Datei von 3.847 Tokens auf 312.
Read-Ablehnungsregeln inpermissions.denyverhindern, dass Claude Build-Ordner, Lockfiles und automatisch generierten Code liest..claudeignore-Dateien haben keine Wirkung; die Anthropic-Dokumentation empfiehlt, den Inhalt in Ablehnungsregeln zu verschieben.- Pfadbasierte Regeln in
.claude/rules/(mitpaths:-Frontmatter) werden nur geladen, wenn Claude mit übereinstimmenden Dateien arbeitet. - MCP Tool Search (standardmäßig in aktuellen Claude Code-Versionen aktiv) verzögert MCP-Tools und findet sie bei Bedarf, anstatt alle Schemata vorab zu laden.
- Planungsmodus (drücke Shift+Tab, bis die Statusleiste den Planungsmodus anzeigt) vor großen Änderungen kürzt die Arbeit in die falsche Richtung – die teuerste Art.
So reduzierst du den Token-Verbrauch in Codex
Dieselben Tools funktionieren in OpenAIs Codex CLI. RTK wird für Codex mit rtk init -g --codex installiert, und der npx-Installer von Caveman deckt Codex ebenfalls ab. Eine gute AGENTS.md-Datei spart ebenfalls Tokens: In einer Studie mit 124 Pull Requests in 10 Repositories, die mit und ohne die Datei ausgeführt wurden (Lulla et al., arXiv:2601.20404), reduzierte AGENTS.md Output-Tokens um 16,6 % und die mittlere Laufzeit um 28,6 %. Unser AGENTS.md Best-Practices-Leitfaden erklärt, wie man sie schreibt.
Wie viel Token-Reduzierung wirklich einspart (in Dollar)
Hier sind die typischen Agenten-Kosten vor und nach der Optimierung bei 200 Aufrufen pro Tag:
| Vorher | Nach Optimierung | Einsparung | |
|---|---|---|---|
| System-Prompt | 500 Wörter (~650 Tokens) | 200 Wörter (~260 Tokens) | 60 % |
| Tool-Schemata | 10 Tools (~2.000 Tokens) | 3 Tools (~600 Tokens) | 70 % |
| Verlauf | Vollständig (~8.000 Tokens) | Letzte 3 Runden (~2.000 Tokens) | 75 % |
| Antwortlänge | ~400 Tokens | ~150 Tokens (komprimiert) | 62 % |
| Modell | Opus 5.5 für alles | Sonnet 5.5 für 70 % der Aufrufe, Opus 5.5 für komplexe Arbeit | 50 % pro weitergeRoutetem Aufruf |
| Kosten pro Aufruf | ~$0,051 | ~$0,0094 | 81 % |
| Tageskosten (200 Aufrufe) | ~$10,12 | ~$1,88 | $8,24/Tag gespart |
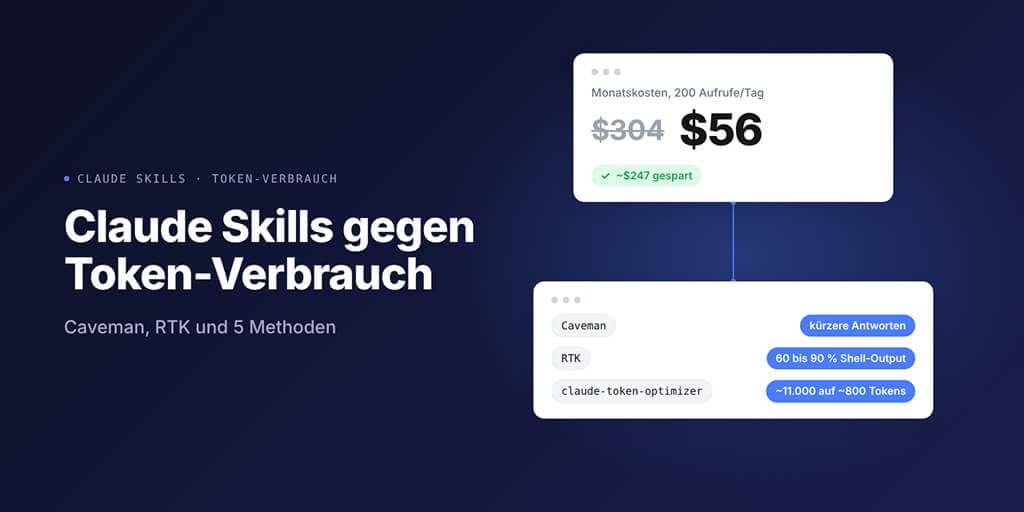
| Monatskosten (30 Tage) | ~$304 | ~$56 | ~$247/Monat gespart |
Diese Zahlen verwenden die Anthropic API-Preise vom Oktober 2026 (Claude Sonnet 5.5 für $2/$10 pro Million Input-/Output-Tokens, Claude Opus 5.5 für $4/$20) und berücksichtigen kein Prompt-Caching, das beide Spalten noch weiter senken würde. Selbst ohne Modell-Routing senkt das alleinige Kürzen von Kontext und Output eine reine Opus-Rechnung von ~$304 auf ~$87 pro Monat. Leite 70 % der einfachsten Aufrufe zu Claude Haiku 5.5 statt Sonnet weiter, und die „Nach"-Spalte sinkt noch weiter. BYOK-Nutzer bei BetterClaw zahlen zu diesen Tarifen direkt an den Anbieter – ohne jeglichen Aufschlag.
Die 5 Methoden hinter jeder tokensparenden Skill
Jedes der obigen Tools funktioniert durch eine dieser fünf Methoden. Wenn eine Skill, die du in Betracht ziehst, keine davon umsetzt, fügt sie wahrscheinlich Tokens hinzu, anstatt sie zu reduzieren.
Methode 1: Output-Komprimierung (der „Caveman"-Ansatz)
Die meistdiskutierte Token-Optimierung ist, den Agenten zu prägnanter, direkter Sprache zu zwingen: ohne Füllphrasen, zeremonielle Eröffnungen, Übergangssätze oder schrittweise Erklärungen, um die du nicht gebeten hast.
Ohne Komprimierung: „Ich habe das Refactoring des Authentifizierungsmoduls erfolgreich abgeschlossen. Die Änderungen umfassen die Aktualisierung der Token-Validierungslogik, die Neustrukturierung der Middleware-Kette und das Hinzufügen einer umfassenden Fehlerbehandlung. Hier ist eine detaillierte Erläuterung jeder Änderung..." Das sind 45 Tokens, die nur den eigentlichen Inhalt verpacken.
Mit Komprimierung: „Auth-Modul refactored. Token-Validierung aktualisiert. Middleware neu strukturiert. Fehlerbehandlung hinzugefügt." Dieselben Informationen. 12 Tokens.
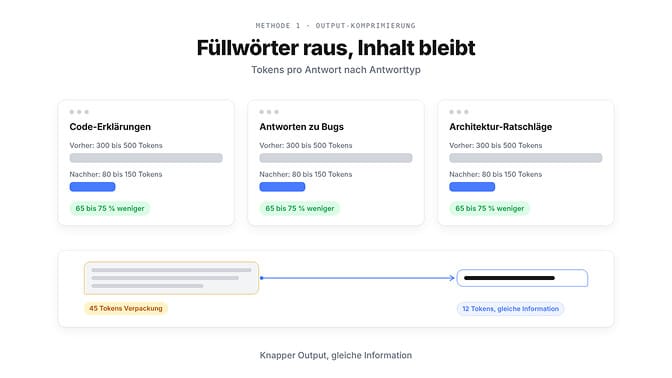
Die Zahlen: Typische Antworten liegen bei 300–500 Tokens ohne Komprimierung und 80–150 mit aggressiver Komprimierung. Bei 30 Nachrichtenaustauschen pro Sitzung sind das 9.000–12.000 Tokens Einsparung. Towards AI benchmarked diesen Ansatz mit 75 % Reduktion pro Sitzung; Cavedmans eigene Tests zeigen 41 % weniger Output-Tokens verglichen mit keiner Anweisung im Standardmodus und 61 % mit /ultracave. Der Skill-Erstellungsleitfaden von Anthropic liefert ein illustratives Beispiel für denselben Effekt: Eine Aufgabe, die ohne Skill 15 Nachrichten und 12.000 Tokens benötigte, brauchte mit Skill nur 2 Klärungsfragen und 6.000 Tokens.
Der Nachteil: Komprimierter Output klingt kalt. Mach es ein- und ausschaltbar – nicht permanent.
Methode 2: Beim ersten Versuch richtig liegen
Das sieht nicht nach Token-Optimierung aus – ist aber die größte.
Skills, die Bugs vor dem Commit abfangen, bedeuten weniger Gespräche vom Typ „Behebe den Bug, den du gerade erstellt hast". Skills, die das Test-Framework deines Projekts kennen, produzieren Tests, die beim ersten Versuch bestehen. Architektur-Skills, die deine Konventionen kennen, verhindern, dass der Agent Code mit falscher Struktur generiert, der dann überarbeitet werden muss.
Jeder Re-Prompt verbraucht eine vollständige Runde. Der Agent liest den Kontext erneut, verarbeitet die Korrektur und generiert eine neue Antwort. Ein Re-Prompt bei einem Kontext von 30.000 Tokens kostet 30.000+ Tokens für das erneute Lesen plus 500+ für das Generieren der Antwort. Vermeide einen Re-Prompt pro Sitzung, und du sparst mehr Tokens als jede Output-Komprimierungs-Skill.
MindStudio hat fünf Token-Reduktions-Skills benchmarked und jedes Mal dasselbe Ergebnis erzielt: Weniger Missverständnisse bedeuten weniger Re-Prompts und weniger Tokens. Der strukturierte Fünf-Phasen-Ansatz (planen, dann bauen, dann überprüfen) verwendete 14 % weniger Tokens und kostete 9 % weniger als unstrukturierte Sitzungen auf demselben Modell.
Deshalb machen Agenten-Skills, die die Konventionen deines Projekts laden, so einen Unterschied. Eine Skill, die dem Agenten sagt „Verwende Functional Components, niemals Class Components", verhindert Outputs mit falscher Architektur, deren Korrektur 50.000+ Tokens kosten kann.
Methode 3: Code-Skripte statt Markdown-Anweisungen
Das ist kontraintuitiv. Die meisten Skills sind in Markdown geschrieben: Anweisungen in natürlicher Sprache, die der Agent liest und befolgt.
Aber MindStudio veröffentlichte Daten, die zeigen, dass ausführbare Code-Skripte für dieselbe Aufgabe Tokens um bis zu 90 % reduzieren im Vergleich zu Markdown-Anweisungen. Markdown-Anweisungen sind von Natur aus ausführlich: „Wenn der Nutzer bittet, Daten zu verarbeiten, prüfe zuerst, ob die Datei existiert, lese dann ihren Inhalt, validiere dann das Format, dann..." Das ist ein Absatz, den der Agent jedes Mal liest und interpretiert, wenn er aufgerufen wird. Ein Skript macht dasselbe in 10 Zeilen. Der Agent interpretiert es nicht; er führt es aus.
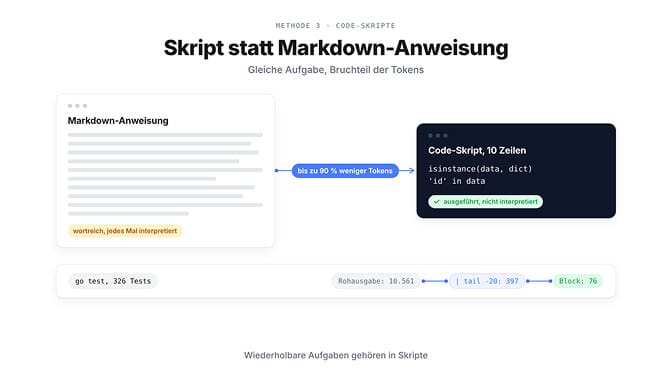
Skripte sind auch zuverlässiger. „Validiere das Format" kann bei jeder Ausführung etwas anderes bedeuten. Ein Skript, das isinstance(data, dict) und 'id' in data prüft, tut exakt eine Sache – immer. Das „Blocks"-Add-on von Caveman (noch in der Vorabversion) basiert auf dieser Idee: wiederverwendbare Skripte, die der Agent ausführt, statt sie neu zu schreiben. Bei einer go test-Ausführung mit 326 Tests betrug der rohe Output 10.561 Tokens, | tail -20 reduzierte ihn auf 397, und der Block auf 76.
Für Skills, die konsistente, wiederholbare Aktionen ausführen (Datenverarbeitung, Dateiverwaltung, API-Aufrufe, Formatkonvertierung), schreibe sie als Code-Skripte. Behalte Markdown-Anweisungen für Skills vor, die flexible Interpretation benötigen.
Methode 4: MCP-Server-Kürzung (der unsichtbare Token-Abfluss)
Jeder mit deinem Agenten verbundene MCP-Server lädt seine Tool-Definitionen in das Kontextfenster – bei jeder Nachricht, in jeder Runde –, ob du diese Tools in dieser Interaktion verwendest oder nicht.
MindStudio maß, dass ein einzelner MCP-Server allein durch Tool-Definitions-Overhead bis zu 18.000 Tokens pro Runde erreichen kann. Verbinde drei funktionsreiche Server, und du könntest 50.000+ Tokens pro Gespräch für Tool-Schemata ausgeben, die der Agent nie aufruft. Damian Galarza fand heraus, dass MCP-Tool-Definitionen 24 % oder mehr des Kontextfensters beanspruchen können, bevor eine einzige Nachricht gesendet wird. Für manche Tools vermeiden direkte API-Aufrufe statt MCP diesen Overhead vollständig.
Die Lösung ist einfach, wird aber oft übersehen: Trenne MCP-Server, die du gerade nicht verwendest. Wenn die heutige Aufgabe GitHub nicht braucht, trenne es. Wenn du in dieser Sitzung nur Slack brauchst, lade nicht auch Jira, HubSpot und Google Drive. (Für mehr Details darüber, wo MCP im Vergleich zu Skills steht, sieh dir unseren Leitfaden über Agenten-Skills vs. MCP an.)
Anthropic adressierte einen Teil davon im Januar 2026 mit MCP Tool Search. In aktuellen Claude Code-Versionen ist es standardmäßig aktiv: MCP-Tools werden verzögert und bei Bedarf gefunden, statt alle vorab zu laden (ENABLE_TOOL_SEARCH=auto kehrt zum alten Verhalten „erst nach Überschreitung von 10 % des Kontexts" zurück). Aber nicht alle Agenten-Frameworks tun das, und Claude Code 2.1.296 (9. Oktober 2026) verdoppelte das Standardlimit für vorab gesendete MCP-Tool-Beschreibungen von 2.048 auf 4.096 Zeichen. Längere erlaubte Beschreibungen bedeuten mehr Tokens pro Tool, wo immer Tools vorab geladen werden – was die Kürzung wichtiger macht, nicht weniger.
Bei BetterClaw fungieren Agenten als MCP-Clients, und du hakst nur die benötigten Tools ab bei jedem MCP-Server – dieselbe Kürzung ohne das Bearbeiten von Konfigurationsdateien. Skills werden genauso geladen: Nur Skills, die für die aktuelle Aufgabe relevant sind, verbrauchen Kontext-Tokens.
Methode 5: Kontext-Injektion statt Kontext-Wiederholung
Die teuerste Gewohnheit von allen ist, denselben Projektkontext in jedem Gespräch erneut zu senden.
Projektstruktur: 800 Tokens. Abhängigkeiten: 600. Coding-Standards: 400. Architekturentscheidungen: 700. API-Dokumentation: 500. Frühere Entscheidungen: 400. Gesamt: 3.400 Tokens, die zu Beginn jedes Gesprächs gesendet werden. Zehn Gespräche pro Tag bedeuten 34.000 Tokens für wiederholten Kontext; in einem Monat über 1.000.000 Tokens, die keinerlei neue Information tragen.
Die Lösung: Speichere Kontext in einem persistenten, effizienten Format und injiziere ihn bei Bedarf, statt ihn im Rohformat erneut zu senden. Das ist es, was Prompt-Caching auf Anbieterebene tut (bei Claude Opus 5.5 kosten gecachte Inputs $0,20 pro Million Tokens gegenüber $4 ohne Cache; sieh dir unseren Leitfaden über Prompt-Caching für Agenten an). Du kannst es auch auf Skill-Ebene tun – und genau das machen caveman-compress und claude-token-optimizer: Statt ein 2.000-Token-README zu laden, halte eine 200-Token-Zusammenfassung mit den wichtigen Entscheidungen und Konventionen vor, und lass den Agenten die vollständige Datei nur bei Bedarf öffnen.
Wie senken Token-Komprimierungs-Tools Kosten, ohne die Output-Qualität zu reduzieren?
Sie verwerfen Wörter, die weder das Modell noch der Leser benötigt, und lassen die bedeutungstragenden Teile exakt so stehen. Caveman lässt Code, Befehle und Fehlermeldungen unberührt und verwirft nur die umgebende Prosa; RTK filtert das Rauschen aus Befehlsausgaben, bevor der Agent sie liest. JetBrains maß 8,5 % weniger Output-Tokens ohne messbare Qualitätseinbußen bei der Verwendung von Caveman bei 86 Coding-Aufgaben.
Qualität sinkt an zwei Stellen. Übermäßig komprimierte Projektkontextzusammenfassungen können Entscheidungen auslassen, die der Agent benötigt – beginne also mit leichter Komprimierung und prüfe die Outputs, bevor du weitergehst. Und prägnante Prosa passt nicht für alles, was Kunden lesen. Komprimiere, was Maschinen lesen; lass, was Menschen lesen, wie es ist.
Der Zinseszins-Effekt
Diese Methoden summieren sich nicht – sie multiplizieren sich. Output-Komprimierung kürzt Tokens pro Antwort auf ihrer stärksten Stufe um 65–75 %. Beim ersten Versuch richtig liegen eliminiert 30–50 % der Hin-und-Hers. Code-Skripte kürzen den Anweisungs-Overhead um bis zu 90 %. MCP-Kürzung gibt 24 %+ des Kontextfensters zurück. Kontext-Injektion eliminiert 90 %+ des wiederholten Kontexts.
Wende alle fünf an, und eine Sitzung, die 150.000 Tokens verbrauchen würde, könnte nur 25.000–40.000 verwenden. Dieselbe Arbeit, dieselbe Output-Qualität, 75–85 % weniger Kosten.
Ein praktisches Starter-Kit für Claude Code:
- Führe
/contextundnpx -y claude-token-optimizer measureaus, um deine Basislinie zu sehen. - Kürze CLAUDE.md auf unter 200 Zeilen, oder führe caveman-compress darauf aus.
- Installiere RTK und führe
rtk init -gaus. - Installiere Caveman und verwende
/cavemanfür Coding-Sitzungen, schalte es für das Schreiben aus. - Trenne MCP-Server, die du heute nicht verwendest.
- Miss nach einer Woche erneut mit
npx ccusage@latest.
Gartner prognostiziert, dass 40 % der Enterprise-Anwendungen bis Ende 2026 KI-Agenten einbetten werden. Mit wachsender Adoption sind die Teams, die Token-Kosten jetzt optimieren, die Teams, die mehr Agenten, häufiger, für schwierigere Probleme betreiben können. Für die Modell-Auswahl-Seite desselben Problems sieh dir unseren Modell-Routing-Setup-Leitfaden an sowie unseren Leitfaden zum Kürzen von Agenten-API-Kosten um 80 %.
Melde dich bei BetterClaw an, wenn du möchtest, dass die Token-Optimierung für dich übernommen wird. Kontextverwaltung, die Aufblähung von vornherein verhindert, Skills, die nur bei Bedarf geladen werden, 500+ Konnektoren mit MCP-Auswahl pro Tool in bezahlten Tarifen und 28+ Modellanbieter mit deinem eigenen Schlüssel ohne Aufschlag. Erstelle einen BetterClaw-Account, und Pro kostet $49/Monat für 5 Agenten, mit einem Kill Switch in jedem Plan. Wir kümmern uns um die Token-Kosten. Du kümmerst dich um die Agenten-Logik.
Häufig gestellte Fragen
Welche sind die besten Claude-Skills zur Reduzierung des Token-Verbrauchs?
Caveman für den Output (4.119 Output-Tokens statt 6.983 im Standardmodus und 2.693 mit /ultracave in den eigenen Zehn-Fragen-Tests), RTK für Shell- und Test-Output (60–90 % kleiner bei gängigen Dev-Befehlen) und caveman-compress oder claude-token-optimizer für Dateien, die Claude zu Sitzungsbeginn lädt. Füge MCP-Kürzung hinzu, und du hast die vier größten Verschwendungsquellen angegangen. Die meisten anderen Skills fügen Tokens hinzu.
Sparen Skills Tokens?
Nur die, die zum Verwerfen von Tokens erstellt wurden. Skills, die Output komprimieren, Dateien komprimieren oder an günstigere Modelle weiterleiten, sparen Tokens; Skills, die Fähigkeiten hinzufügen (Suche, Tools, Dateizugriff), fügen Tokens hinzu. Selbst sparende Skills haben einen Preis: Cavedmans Regeln fügen etwa 1.000–1.500 Input-Tokens pro Runde hinzu, solange sie aktiv sind, und gleichen das durch das Kürzen von Output-Tokens aus, die in Claude 5× kosten.
Was ist die Caveman-Skill?
Eine Open-Source-Skill für Claude Code und 30+ andere Coding-Agenten (JuliusBrussee/caveman, ~115.000 GitHub-Sterne), die den Agenten dazu bringt, prägnant und direkt zu antworten, während der Code exakt erhalten bleibt. Installiere es in Claude Code mit claude plugin marketplace add JuliusBrussee/caveman und claude plugin install caveman@caveman, dann verwende /caveman, /ultracave oder /caveman off.
Gibt es eine Token-Optimizer-Skill für Claude Code?
Ja. Der claude-token-optimizer von nadimtuhin kürzt, was Claude Code zu Sitzungsbeginn lädt (~11.000 auf ~800 Startup-Tokens im Projekt des Autors); führe npx -y claude-token-optimizer measure aus, um deine zu prüfen. Andere Repos mit ähnlichen Namen sind kleinere Prompt-Protokolle und Checklisten.
Was ist RTK (Rust Token Killer)?
Ein einzelnes Rust-Binary (rtk-ai/rtk, ~85.000 GitHub-Sterne), das Befehlsausgaben filtert, bevor dein Agent sie liest, und sie bei gängigen Dev-Befehlen um 60–90 % kürzt. RTK funktioniert mit Claude Code, Codex, Cursor, Copilot, Gemini CLI und 13 weiteren Tools. Installiere es mit brew install rtk, dann rtk init -g (füge --codex für Codex hinzu).
Wie reduziert man den Token-Verbrauch in Claude Code, ohne etwas zu installieren?
Prüfe /context, halte CLAUDE.md unter 200 Zeilen, füge Read-Ablehnungsregeln für Build-Ordner und Lockfiles hinzu, verwende /clear zwischen Aufgaben und /compact innerhalb langer Aufgaben, lasse MCP Tool Search aktiv, trenne MCP-Server, die du nicht verwendest, und nutze den Planungsmodus vor großen Änderungen.
Wie viel kürzen Token-Reduktions-Skills wirklich die Kosten?
Jede Methode liefert messbare Ergebnisse: Output-Komprimierung spart auf ihrer stärksten Stufe 65–75 % pro Antwort (Towards AI), Code-Skripte sparen bis zu 90 % gegenüber Markdown (MindStudio) und MCP-Kürzung kann 24 %+ des Kontextfensters zurückgewinnen (Damian Galarza). Kombiniert multiplizieren sie sich zu einer Gesamtreduktion von 75–85 % pro Sitzung. In unserem Berechnungsbeispiel fällt ein reiner Opus-Agent mit 200 Aufrufen pro Tag von ~$304 auf ~$56 pro Monat.
Können Token-Reduktions-Skills die Output-Qualität senken?
Output-Komprimierung reduziert Erklärungen – was bei Code in Ordnung ist, aber weniger gut für geschriebene Inhalte –, also mach es ein- und ausschaltbar. Beim ersten Versuch richtig liegen und Code-Skripte verbessern die Qualität, während sie Tokens reduzieren. MCP-Kürzung betrifft nur Tokens, solange du die benötigten Server behältst. Kontextkomprimierung kann die Qualität senken, wenn die Zusammenfassung wichtige Entscheidungen auslässt; beginne leicht und prüfe die Outputs, bevor du weitergehst.
Funktionieren Token-Reduktions-Skills in BetterClaw?
Ja. Mit deinem eigenen Modell-Schlüssel (BYOK) geht jeder Token, den du sparst, direkt in deine Anbieter-Rechnung – ohne Aufschlag. Kontextverwaltung ist bereits eingebaut: Skills werden nur geladen, wenn die Aufgabe sie benötigt, und in bezahlten Tarifen kannst du auswählen, welche Tools jeder MCP-Server dem Agenten zugänglich macht.