Gemma 4 ou Qwen 3.8? A escolha rápida por tamanho de GPU e tipo de trabalho (código, tool calling, chat), com links para cada comparativo direto que já testamos.
Duas famílias open-weight, treze modelos entre elas, e uma pergunta que a maioria das comparações ignora: qual par você deveria realmente comparar?
O download do modelo terminou à 1h40 da madrugada. Vinte e dois gigabytes, baixados num wifi de hotel, porque alguém num fórum disse que era esse o modelo certo.
Ele carregou. Respondeu a primeira pergunta em uns quarenta segundos. Aí começou a pensar, e pensar, e ainda estava pensando quando o limite de saída o cortou no meio da frase, depois de produzir mil e cem tokens de raciocínio e zero tokens de resposta.
Essa é a experiência real de escolher um modelo local em 2026, e não é um problema de benchmark. É um problema de confronto.
Escolha rápida por GPU
| Sua VRAM | Rode isto | Por quê | Comparação completa |
|---|---|---|---|
| 8 GB | Qwen 3.5 9B (4 bits), ou Gemma 4 E4B para áudio | Melhor capacidade por gigabyte, com espaço sobrando para contexto | Gemma 4 12B vs Qwen 3.5 9B |
| 12 GB | Qwen 3.5 9B para tool calling, Gemma 4 12B para imagens e áudio | O 12B cabe em cerca de 7 a 8GB em 4 bits, mas deixa menos espaço para contexto | Gemma 4 12B vs Qwen 3.5 9B |
| 16 GB | Gemma 4 12B (multimodal, multilíngue) ou Qwen 3.5 9B (agentes) | A disputa mais apertada de qualquer uma das famílias | Gemma 4 12B vs Qwen 3.5 9B |
| 24 GB | Qwen 3.8 27B para código, Gemma 4 26B A4B para velocidade | Os dois cabem em 4 bits; o Qwen 3.8 é o melhor programador, o MoE do Gemma é o mais rápido | Gemma 4 vs Qwen 3.8 |
| 32 GB+ | Gemma 4 31B com folga real de contexto, ou Qwen 3.6 35B A3B | Qualidade densa contra um MoE leve | Gemma 4 31B vs Qwen 3.6 27B |
O detalhe por trás de cada linha está em Qual escolher por hardware, mais abaixo.
Se você só se importa com o Qwen mais novo na faixa de 24GB, nosso comparativo Gemma 4 vs Qwen 3.8 cobre esse confronto separadamente.
Agora, veja por que a maioria dos artigos de comparação erra antes mesmo de começar.
A linha completa de tamanhos, lado a lado
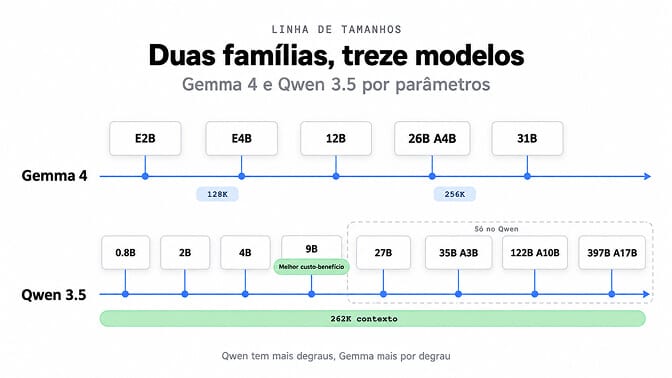
As duas famílias chegaram com menos de oito semanas de diferença em 2026. As duas são Apache 2.0. As duas são multimodais. A semelhança termina aí, porque elas têm formatos completamente diferentes.
Gemma 4 (Google DeepMind, 2 de abril de 2026 para E2B, E4B, 26B A4B e 31B, com o 12B adicionado em 3 de junho de 2026, Apache 2.0, mais de 140 idiomas):
| Modelo | Parâmetros | Contexto | VRAM aprox. em 4 bits | Observações |
|---|---|---|---|---|
| E2B | ~2.3B efetivos | 128K | ~4GB | Classe celular e navegador, áudio nativo |
| E4B | ~4.5B efetivos | 128K | ~5 a 6GB | Classe notebook, áudio e vídeo nativos |
| 12B | 11.95B unificados | 256K | ~7 a 8GB | Sem encoder, trata texto, imagem e áudio num único decoder |
| 26B A4B | 25.2B no total, 3.8B ativos | 256K | ~14 a 18GB | Mixture of Experts, a aposta em eficiência |
| 31B | 30.7B denso | 256K | ~18 a 20GB | O pico de qualidade da família |
Qwen 3.5 (Alibaba, lançado ao longo de fevereiro e março de 2026, Apache 2.0, 201 idiomas):
| Modelo | Parâmetros | Contexto | VRAM aprox. em 4 bits | Observações |
|---|---|---|---|---|
| 0.8B | 0.8B | 262K | ~1 a 2GB | Edge e embarcado |
| 2B | 2B | 262K | ~2 a 3GB | Classe celular |
| 4B | 4B | 262K | ~4 a 5GB | Classe notebook |
| 9B | 9B | 262K | ~6 a 8GB | Melhor custo-benefício da faixa intermediária |
| 27B | 27B denso | 262K | ~16 a 20GB | O modelo denso aberto mais forte em código da família |
| 35B A3B | 35B no total, 3B ativos | 262K | ~20 a 24GB | MoE, roda surpreendentemente pequeno |
| 122B A10B | 122B no total, 10B ativos | 262K | Classe workstation | Líder em benchmarks agênticos |
| 397B A17B | 397B no total, 17B ativos | 262K | Só multi-GPU | Carro-chefe |
Os números de VRAM são regras práticas com quantização de 4 bits. Some uma folga para contexto e KV cache, e some bastante folga se você pretende usar algo perto daquela janela de 262K.
Duas coisas chamam a atenção. O menor modelo da Qwen tem um terço do tamanho do menor modelo do Gemma. E todo modelo Qwen 3.5 vem com os mesmos 262.144 tokens de contexto, extensíveis a cerca de um milhão com YaRN, enquanto o Gemma se divide em 128K para os modelos pequenos e 256K para todo o resto.
A Qwen oferece mais degraus na escada. O Gemma oferece menos degraus, mas coloca mais coisa em cada um.
Qual par você deve realmente comparar?
Aqui é onde as pessoas se perdem, e é por isso que "Gemma 4 vs Qwen 3.5" é uma pergunta quase sem sentido até você torná-la específica.
As contagens de parâmetros não se alinham entre essas famílias. Os E2B e E4B do Gemma usam embeddings por camada, então o "E" significa efetivo, ou seja, os parâmetros realmente carregados na VRAM durante o cálculo. Comparar um modelo de 4.5B efetivos com um modelo denso de 4B pelo número do rótulo não diz nada útil.
Pior, o 26B A4B do Gemma é um Mixture of Experts que ativa só 3.8B de parâmetros por token. Ele ocupa a memória de um modelo de 26B e tem o custo de computação de um de 4B. O 35B A3B da Qwen faz o mesmo truque com 3B ativos. Então uma comparação "26B vs 35B" é, na verdade, uma comparação entre dois modelos esparsos com tamanhos ativos parecidos e pegadas totais diferentes.
Este é o mapeamento que realmente se sustenta:
- Gemma 4 E2B contra Qwen 3.5 2B. Classe celular e edge.
- Gemma 4 E4B contra Qwen 3.5 4B. Classe notebook. Aqui o Gemma acrescenta áudio e vídeo nativos.
- Gemma 4 12B contra Qwen 3.5 9B. O confronto mais próximo e mais útil de toda a comparação.
- Gemma 4 26B A4B contra Qwen 3.5 35B A3B. Esparso contra esparso.
- Gemma 4 31B contra Qwen 3.5 27B. Denso contra denso, e o que todo mundo usa nos benchmarks.
Acima dessa linha, a Qwen corre sozinha. Não existe resposta do Gemma 4 para o 122B ou o 397B. E não existe nenhum Gemma 4 27B, apesar do que a caixa de busca sugira; o tamanho 27B era do Gemma 3.
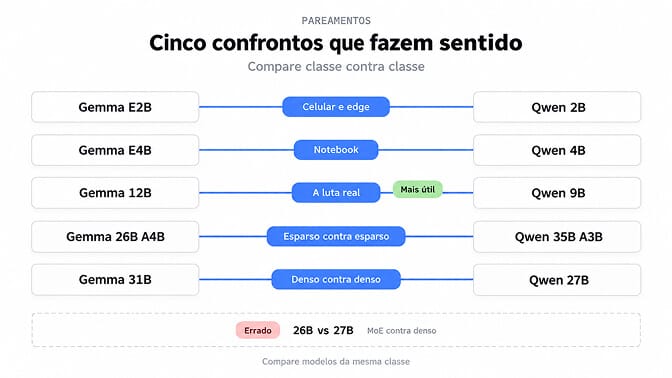
Confronto direto por faixa de tamanho
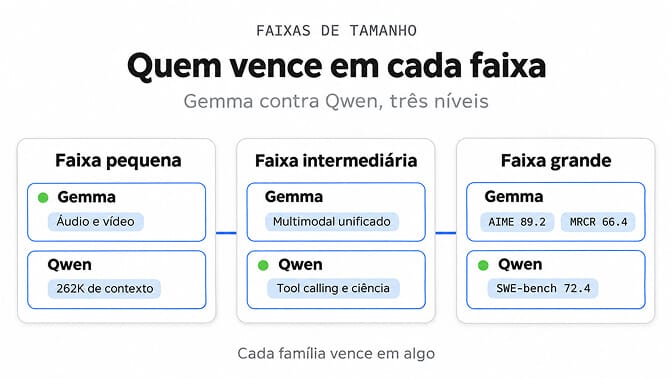
Faixa pequena: E2B e E4B contra Qwen 2B e 4B
O Gemma vence esta faixa em capacidade por gigabyte, e não é nem de longe apertado em trabalho multimodal. Os E2B e E4B trazem entrada de áudio nativa, incluindo reconhecimento de fala, e tratam vídeo a mais ou menos um quadro por segundo por até um minuto. Os modelos pequenos da Qwen também são multimodais, mas áudio não é a história deles.
A Qwen vence em contexto. Um modelo de 2B com janela de 262K é incomum e útil para mastigar documentos longos em hardware que não tem nenhuma obrigação de dar conta.
Se você está construindo algo que escuta, use o Gemma. Se está construindo algo que lê muito, use a Qwen.
Faixa intermediária: Gemma 4 12B contra Qwen 3.5 9B
A luta mais interessante, e a que a maioria das pessoas com uma máquina de 16GB vai realmente ter.
O 12B do Gemma é estranho de um jeito bom em termos de arquitetura. Ele é unificado e sem encoder, ou seja, abandona os encoders separados de visão e áudio e projeta patches de imagem brutos e áudio direto no decoder. Comparações de terceiros o colocam à frente em benchmarks práticos de código e em raciocínio multilíngue.
O 9B da Qwen leva os benchmarks de conhecimento, ciência e uso agêntico de ferramentas por margens claras, com a diferença em uso de ferramentas sendo uma das maiores de toda a comparação. Ele também deixa um pouco mais de folga, já que o 9B em 4 bits fica confortavelmente abaixo de 7GB enquanto o 12B pede perto de 8.
Nenhum dos dois tem um Elo publicado na Arena nesta faixa, então quem citar um número para você está chutando.
Faixa grande: Gemma 4 31B contra Qwen 3.5 27B
Os dois cabem numa única placa de 24GB. Os dois reivindicam o território do outro. Os números publicados discordam dependendo de quem os rodou, que é a coisa mais honesta que alguém pode dizer sobre este confronto.
O cartão do Google e rodadas de terceiros colocam o Gemma 4 31B em 89.2 no AIME 2026, 80.0 no LiveCodeBench v6, 84.3 no GPQA Diamond, 85.2 no MMLU Pro e 66.4 no MRCR v2 de recuperação de contexto longo. Esse último número é o que mais importa: o Gemma 3 27B, o topo anterior da família, marcou 13.5 no mesmo teste. A janela de 128K do Gemma 3 era quase decorativa. A janela de 256K do Gemma 4 realmente recupera.
O Qwen 3.5 27B marca 72.4 no SWE-bench Verified, o que empata com o GPT-5 mini e é um número sério para um modelo denso totalmente aberto desse tamanho. Uma avaliação independente dos checkpoints em BF16 encontrou o Gemma 4 31B à frente na maioria dos benchmarks, com MMLU Pro e GPQA Diamond como exceções. Outro ranking mostra a Qwen bem à frente em código, puxada quase inteiramente pelo SWE-Rebench.
Os dois não podem estar certos, e isso já diz alguma coisa.
Colocamos a briga densa da faixa grande contra o 27B mais novo da Qwen no nosso comparativo Gemma 4 31B vs Qwen 3.6 27B.
Onde entram o Qwen 3.6 e o Qwen 3.8
O Qwen 3.5 era a linha atual quando esta comparação foi publicada em agosto. Ele não é mais o Qwen mais novo, e importa exatamente quais lançamentos mais recentes você consegue rodar.
O Qwen 3.6 (abril de 2026) lançou pesos abertos em dois tamanhos: um modelo mixture-of-experts 35B-A3B e um modelo denso de 27B lançado em 22 de abril. Os dois aceitam texto, imagem e vídeo, os dois têm 262K de contexto nativo, e os dois estão no Ollama como qwen3.6:35b-a3b e qwen3.6:27b. O cartão da própria Alibaba para o Qwen3.6-27B o coloca à frente do Gemma 4 31B no SWE-bench Verified (77.2 contra 52.0), GPQA Diamond (87.8 contra 84.3), LiveCodeBench v6 (83.9 contra 80.0) e AIME 2026 (94.1 contra 89.2). São números informados pelo próprio fornecedor, e o cartão do Google mostra a força do 31B em recuperação de contexto longo, que a tabela da Alibaba não inclui.
O Qwen 3.7 (Max e Plus, maio e junho de 2026) é só por API. Sem pesos abertos, nada para baixar no Ollama.
O Qwen 3.8 é a linha open-weight atual. O Qwen3.8-27B chegou em 14 de agosto de 2026: denso, Apache 2.0, 262K de contexto nativo, entrada de texto, imagem e vídeo, com thinking ligado por padrão e profundidade de raciocínio ajustável. Está no Ollama como qwen3.8:27b, com cerca de 18GB. Em 26 de agosto de 2026, a Qwen acrescentou o Qwen3.8-Flash-Next: um Mixture of Experts de 125B de parâmetros com 6B ativos por token, pesos abertos sob a licença Qwen Community 1.0 e uma prévia antecipada da arquitetura Qwen4. Ele ativa poucos parâmetros por token, mas você ainda precisa manter todos os 125B na memória, então é um modelo de workstation ou multi-GPU, não um rival para nada da linha Gemma 4. O último lançamento aberto do 3.8 é um modelo da classe Max de 2.4T de parâmetros que nenhuma configuração doméstica vai rodar. Se você pretende colocá-lo atrás de um agente, leia antes nossa correção do tool calling do Qwen3.8 27B, porque algumas integrações de agentes travam com ele pelo endpoint /v1 do Ollama.
O que isso muda nos confrontos acima:
- Faixas pequena e intermediária: nada. Nem o Qwen 3.6 nem o 3.8 lançam um modelo aberto abaixo de 27B, então E2B, E4B e 12B continuam sendo comparados da melhor forma com os 2B, 4B e 9B do Qwen 3.5.
- Faixa esparsa: o Gemma 4 26B A4B agora pode ser comparado também com o Qwen 3.6 35B A3B, além da versão 3.5. Se agentes de código são o seu trabalho, olhe também o Ornith 1.5 35B, construído sobre a mesma arquitetura MoE do Qwen 3.5, com os mesmos 3B de parâmetros ativos.
- Faixa densa grande: o rival real do Gemma 4 31B agora é o Qwen 3.6 27B ou o Qwen 3.8 27B, não o Qwen 3.5 27B. Mesma pegada de memória, modelo mais novo.
Gemma vs Qwen para código
Qwen, em toda versão da Qwen que cabe numa placa de 24GB ao lado do Gemma 4 31B. Os números de código espalhados por esta página apontam todos para o mesmo lado quando você os coloca em fila.
| Confronto | Resultado em código (Gemma vs Qwen) | Melhor para código |
|---|---|---|
| Gemma 4 31B vs Qwen 3.8 27B | LiveCodeBench v6: 80.0 vs 90.3 (cartões dos fornecedores). Suíte independente de 12 tarefas: 6/12 vs 12/12 | Qwen 3.8 27B |
| Gemma 4 31B vs Qwen 3.6 27B | LiveCodeBench v6: 80.0 vs 83.9 (cartões dos fornecedores). Mesma suíte independente: 6/12 vs 8/12 | Qwen 3.6 27B |
| Gemma 4 31B vs Qwen 3.5 27B | A Qwen marca 72.4 no SWE-bench Verified. O Google não publica nota de SWE-bench para o 31B, e rankings de terceiros discordam | Pende para o Qwen 3.5 27B |
| Gemma 4 12B vs Qwen 3.5 9B | As comparações publicadas discordam neste tamanho | Apertado demais para dizer |
Gemma 4 vs Qwen 3.6 para código. O Qwen 3.6 27B vence o Gemma 4 31B em código, mas está uma geração atrás do Qwen 3.8 27B, que é o mesmo download de 18GB e lidera o 3.6 em todo benchmark de código que a Alibaba publica (61.7 contra 53.5 no SWE-bench Pro, 73.0 contra 63.4 no Terminal Bench 2.1). A menos que o seu framework de agentes caia no travamento de tool calling do Qwen 3.8 no /v1, comece novos projetos de código no 3.8. O detalhamento completo está no nosso comparativo Gemma 4 31B vs Qwen 3.6 27B.
Onde o Gemma ainda ganha lugar numa configuração de código é na formatação estrita de tool calls. No mesmo teste independente, o Gemma 4 31B fez 90 de 90 em chamadas únicas e 30 de 30 em execuções de vários passos. Se o seu agente de código quebra por chamadas malformadas e não por código ruim, esse histórico pesa mais do que a diferença em código.
O que os benchmarks dizem ao longo da faixa, e onde deixam de ser úteis
Isto é o que você enxerga depois de ler tabelas suficientes. Os benchmarks estáticos favorecem a Qwen em mais linhas individuais. Os testes de preferência humana favorecem o Gemma no topo. O Gemma 4 31B chegou ao terceiro lugar no ranking de texto da Arena com cerca de 1452 de Elo, com o MoE de 26B em sexto, com uns 1441.
Esse resultado do 26B merece um segundo olhar. Ele alcança cerca de 97% da qualidade do 31B denso ativando 3.8B de parâmetros por token em vez de 30.7B. Oito vezes menos computação por passo, sexto lugar num ranking cheio de modelos com muito mais parâmetros ativos.
E eis o que a maioria dos guias deixa de fora sobre rodar qualquer uma das famílias em casa. A quantização não custa só precisão, custa conclusões. Um teste com uma quantização INT4 do Qwen 3.5 com raciocínio ativado encontrou cerca de 70% das respostas do AIME 2025 truncadas por bater no teto de saída de 32K, contra aproximadamente 30% do modelo em precisão total. Os pesos quase não perderam precisão. O modelo só passou a pensar demais para terminar.
Esse é o modo de falha que você vai realmente encontrar à 1h40 da madrugada. Não respostas erradas. Respostas inacabadas.
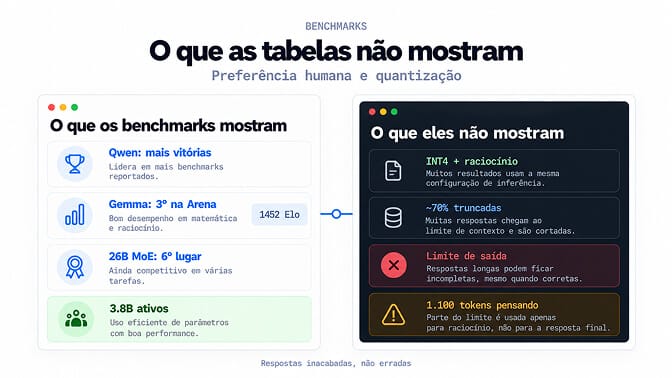
Se você está escolhendo um modelo para ficar atrás de um agente, e não de uma janela de chat, essa distinção importa mais do que qualquer linha de ranking, e nosso guia sobre como escolher o modelo certo para a tarefa explica quais modos de falha realmente quebram os loops de agentes.
Um aparte rápido sobre onde isto se encaixa. Nós construímos uma plataforma de agentes no-code, e trabalhamos com bring-your-own-key em 28 provedores, sem acréscimo no custo de inferência, o que significa que não temos nenhum motivo financeiro para empurrar você para um modelo em vez de outro. Se você quer apontar um agente para o que escolher entre os dois, nossa configuração de provedor e BYOK leva cerca de um minuto, e é só entrar no BetterClaw para começar.
Qual escolher por hardware
Pule tudo o que está acima e comece aqui se você já sabe a sua VRAM.
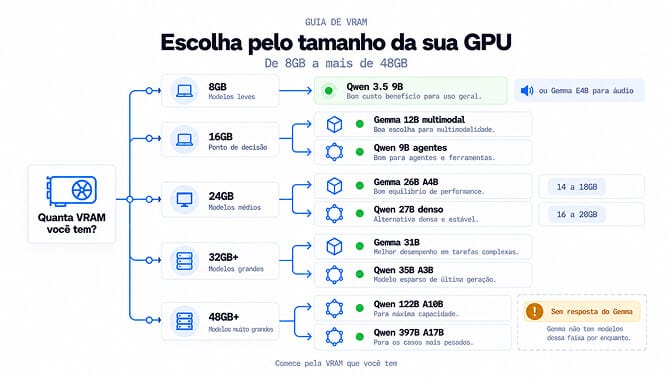
8GB. Qwen 3.5 9B em 4 bits, ou Gemma 4 E4B se você precisa de áudio. O 9B é o modelo com melhor capacidade por gigabyte das duas famílias e deixa espaço para você realmente usar a janela de contexto. O 12B do Gemma tecnicamente vai carregar, e depois vai brigar com você por memória.
16GB. Este é o ponto de decisão real. Gemma 4 12B se o seu trabalho é multimodal ou multilíngue. Qwen 3.5 9B se o seu trabalho é tool calling agêntico, gastando a memória que sobra em mais contexto. O MoE de 26B também é alcançável aqui com quantização agressiva, mas você vai sentir.
24GB. Os finalistas são o Gemma 4 26B A4B e um Qwen denso de 27B. O MoE do Gemma é mais rápido e econômico, cerca de 14 a 18GB em 4 bits, e multimodal. O Qwen denso de 27B é o melhor programador, cerca de 16 a 20GB, e nesse tamanho você pode escolher entre Qwen 3.5, 3.6 ou 3.8. O Gemma 4 31B cabe com 18 a 20GB, mas deixa pouco espaço para contexto.
32GB ou mais. Gemma 4 31B denso em 4 bits com folga real para contexto (em 8 bits ele precisa de cerca de 35GB), ou Qwen 3.5 ou 3.6 35B A3B, que roda muito mais leve do que a contagem total de parâmetros sugere, porque só 3B ativam por token. Acima de 48GB, o 122B A10B da Qwen é o líder em benchmarks agênticos e o Gemma não tem resposta.
Uma observação prática para quem roda isso atrás de um agente sempre ligado, e não numa sessão interativa: o teto de memória não é a sua restrição, a vazão sustentada é.
Todos os comparativos Gemma vs Qwen que já testamos
- Gemma 4 vs Qwen 3.8: o Qwen mais novo contra a família Gemma 4, com os números detalhados do Qwen 3.8.
- Gemma 4 12B vs Qwen 3.5 9B: a decisão dos 16GB, benchmark por benchmark.
- Gemma 4 31B vs Qwen 3.6 27B: o topo denso numa placa de 24GB, incluindo a suíte independente de código e tool calls.
O confronto mais próximo merece uma página própria
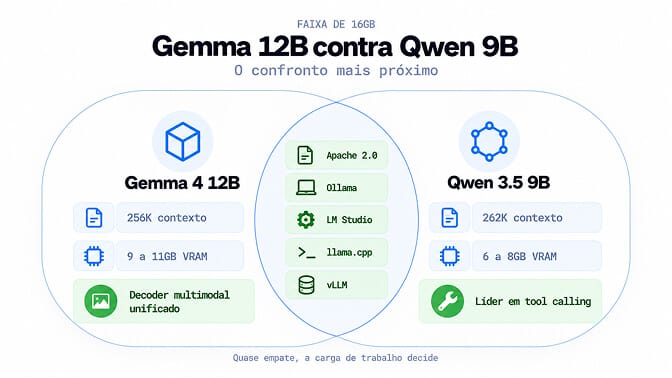
Se você está numa máquina de 16GB, a decisão entre Gemma 4 12B e Qwen 3.5 9B é a única que importa para você, e é apertada o bastante para que um parágrafo não a resolva.
Os dois estão sob Apache 2.0. As janelas de contexto são quase idênticas, 256K e 262K. Os dois rodam no Ollama, LM Studio, llama.cpp e vLLM. A diferença está entre o decoder multimodal unificado do Gemma e as notas de tool calling e conhecimento da Qwen, mais um gigabyte ou pouco mais de folga de memória.
Rodamos esse confronto direito, benchmark por benchmark, no comparativo completo Gemma 4 12B vs Qwen 3.5 9B. Se a sua máquina tem 16GB, leia aquele em vez deste. Se você tem uma placa de 24GB e quer o topo denso, o comparativo Gemma 4 31B vs Qwen 3.6 27B é o que você deve ler.
Se algo disso fez sentido para você, comece com o BetterClaw. Traga a sua própria chave (BYOK) e pague o seu provedor diretamente, sem nenhum acréscimo por cima. O Pro custa $49 por mês para cinco agentes, ou $39 no plano anual. Os preços completos estão aqui. O seu primeiro deploy leva cerca de um minuto, e a escolha do modelo continua sendo sua.
Um último pensamento. Um ano atrás, a pergunta interessante sobre modelos abertos era se eles conseguiam competir com os fechados. Essa pergunta está resolvida. A pergunta interessante agora é qual dos oito ou treze modelos que um único fornecedor lança num único trimestre é o certo para a sua máquina específica, e nenhum ranking vai responder isso por você. Baixe dois. Passe a sua própria carga de trabalho pelos dois. Vence o que termina as próprias frases.
Perguntas Frequentes
Qual é a diferença entre o Gemma 4 e o Qwen 3.5?
O Gemma 4 é a família open-weight do Google DeepMind, lançada em 2 de abril de 2026 com o 12B adicionado em 3 de junho, e tem cinco tamanhos, do E2B até um carro-chefe denso de 31B (não existe Gemma 4 27B), mais de 140 idiomas e áudio nativo nos menores modelos. O Qwen 3.5 é a família da Alibaba lançada ao longo de fevereiro e março de 2026, com oito tamanhos, de 0.8B até um carro-chefe Mixture of Experts de 397B, 201 idiomas e uma janela de contexto uniforme de 262K. Os dois têm licença Apache 2.0, sem restrições comerciais.
Devo usar o Qwen 3.6 ou o Qwen 3.8 em vez do Qwen 3.5?
Só se você tiver memória para um modelo da classe de 27B. O Qwen 3.6 lança pesos abertos em 27B denso e 35B A3B, e o modelo local prático do Qwen 3.8 é o Qwen3.8-27B, lançado em 14 de agosto de 2026. Os dois estão no Ollama. O Qwen3.8-Flash-Next (MoE de 125B, 6B ativos, pesos abertos desde 26 de agosto de 2026) também pode ser baixado, mas precisa de muito mais memória do que qualquer modelo Gemma 4. Abaixo de 27B, o Qwen 3.5 ainda é o Qwen mais novo que você consegue rodar, então em máquinas de 8 a 16GB a comparação Gemma 4 contra Qwen 3.5 continua valendo. O Qwen 3.7 é só por API e não pode ser rodado localmente.
Como o Gemma 4 31B se compara ao Qwen 3.5 27B?
É o confronto mais próximo da faixa grande, e os dois cabem numa única GPU de 24GB. O Gemma 4 31B lidera em multimodal, multilíngue e recuperação de contexto longo, marcando 66.4 no MRCR v2 contra 13.5 do seu antecessor Gemma 3. O Qwen 3.5 27B lidera em código, marcando 72.4 no SWE-bench Verified. Avaliações independentes discordam sobre o vencedor geral, o que é um bom sinal de que a sua própria carga de trabalho deve decidir.
Como rodo o Gemma 4 ou o Qwen 3.5 localmente?
As duas famílias são suportadas no Ollama, LM Studio, llama.cpp, vLLM e MLX, com quantizações GGUF publicadas no Hugging Face. Baixe o modelo que cabe na sua VRAM em 4 bits e depois limite o tamanho do contexto em vez de aceitar os 256K de fábrica, porque a alocação de KV cache em contexto máximo vai esgotar a memória em hardware de consumo muito antes dos pesos.
O Gemma 4 ou o Qwen 3.5 é mais barato de rodar?
Os dois são gratuitos para baixar sob Apache 2.0, então o custo é inteiramente de hardware e eletricidade. Os vencedores em eficiência são os modelos esparsos: o Gemma 4 26B A4B ativa 3.8B de parâmetros por token e alcança cerca de 97% da qualidade do 31B denso, e o Qwen 3.5 35B A3B ativa apenas 3B. Se você está comparando com APIs hospedadas, lembre que qualquer plataforma de agentes gerenciada que cobra acréscimo sobre a inferência é um custo recorrente que esses modelos não têm.
Modelos abertos como esses são confiáveis o bastante para ficar atrás de um agente em produção?
Para tarefas estreitas e bem delimitadas, sim, e milhares de equipes já fazem isso. O risco não é a precisão, é o comportamento sob quantização: quantizações com raciocínio ativado podem esgotar os limites de tokens de saída antes de produzir uma resposta, o que parece um travamento e não um erro. Teste com os seus prompts reais no seu nível real de quantização, defina um teto de saída e coloque uma etapa de aprovação na frente de qualquer coisa destrutiva antes de deixá-lo rodar sem supervisão.