¿Gemma 4 o Qwen 3.8? La elección rápida según el tamaño de tu GPU y la tarea (código, llamadas a herramientas, chat), con enlaces a cada comparación directa que hemos probado.
Dos familias de pesos abiertos, trece modelos entre ambas y una pregunta que casi todas las comparaciones se saltan: ¿qué par deberías comparar en realidad?
El modelo terminó de descargarse a la 1:40 a. m. Veintidós gigabytes, bajados con el wifi de un hotel, porque alguien en un foro dijo que este era el bueno.
Cargó. Respondió la primera pregunta en unos cuarenta segundos. Luego empezó a pensar, y a pensar, y seguía pensando cuando el límite de salida lo cortó a mitad de frase, después de producir mil cien tokens de razonamiento y cero tokens de respuesta.
Esa es la experiencia real de elegir un modelo local en 2026, y no es un problema de benchmarks. Es un problema de emparejamiento.
Elección rápida según tu GPU
| Tu VRAM | Ejecuta esto | Por qué | Comparación completa |
|---|---|---|---|
| 8 GB | Qwen 3.5 9B (4 bits), o Gemma 4 E4B para audio | La mejor capacidad por gigabyte, con espacio de sobra para el contexto | Gemma 4 12B vs Qwen 3.5 9B |
| 12 GB | Qwen 3.5 9B para llamadas a herramientas, Gemma 4 12B para imágenes y audio | El 12B cabe en unos 7 a 8GB a 4 bits, pero deja menos espacio para el contexto | Gemma 4 12B vs Qwen 3.5 9B |
| 16 GB | Gemma 4 12B (multimodal, multilingüe) o Qwen 3.5 9B (agentes) | El duelo más parejo de ambas familias | Gemma 4 12B vs Qwen 3.5 9B |
| 24 GB | Qwen 3.8 27B para código, Gemma 4 26B A4B para velocidad | Ambos caben a 4 bits; Qwen 3.8 programa mejor, el MoE de Gemma es más rápido | Gemma 4 vs Qwen 3.8 |
| 32 GB+ | Gemma 4 31B con espacio real para contexto, o Qwen 3.6 35B A3B | Calidad densa frente a un MoE ligero | Gemma 4 31B vs Qwen 3.6 27B |
El detalle detrás de cada fila está más abajo, en Qué elegir según tu hardware.
Si solo te interesa el Qwen más nuevo en el nivel de 24GB, nuestra comparación Gemma 4 vs Qwen 3.8 cubre ese duelo por separado.
Ahora te explico por qué la mayoría de los artículos comparativos fallan antes de empezar.
Toda la gama de tamaños, lado a lado
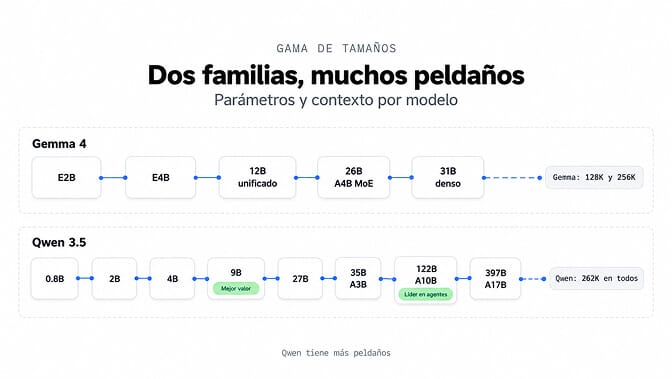
Las dos familias llegaron con ocho semanas de diferencia en 2026. Las dos son Apache 2.0. Las dos son multimodales. Ahí terminan las similitudes, porque tienen formas completamente distintas.
Gemma 4 (Google DeepMind, 2 de abril de 2026 para E2B, E4B, 26B A4B y 31B, con el 12B añadido el 3 de junio de 2026, Apache 2.0, más de 140 idiomas):
| Modelo | Parámetros | Contexto | VRAM aprox. a 4 bits | Notas |
|---|---|---|---|---|
| E2B | ~2.3B efectivos | 128K | ~4GB | Clase teléfono y navegador, audio nativo |
| E4B | ~4.5B efectivos | 128K | ~5 a 6GB | Clase laptop, audio y video nativos |
| 12B | 11.95B unificados | 256K | ~7 a 8GB | Sin codificador, maneja texto, imagen y audio en un solo decodificador |
| 26B A4B | 25.2B en total, 3.8B activos | 256K | ~14 a 18GB | Mixture of Experts, la apuesta por la eficiencia |
| 31B | 30.7B densos | 256K | ~18 a 20GB | El punto más alto de calidad de la familia |
Qwen 3.5 (Alibaba, lanzado entre febrero y marzo de 2026, Apache 2.0, 201 idiomas):
| Modelo | Parámetros | Contexto | VRAM aprox. a 4 bits | Notas |
|---|---|---|---|---|
| 0.8B | 0.8B | 262K | ~1 a 2GB | Borde y sistemas embebidos |
| 2B | 2B | 262K | ~2 a 3GB | Clase teléfono |
| 4B | 4B | 262K | ~4 a 5GB | Clase laptop |
| 9B | 9B | 262K | ~6 a 8GB | La mejor relación valor-precio de gama media |
| 27B | 27B densos | 262K | ~16 a 20GB | El mejor modelo abierto denso para código de la familia |
| 35B A3B | 35B en total, 3B activos | 262K | ~20 a 24GB | MoE, corre con sorprendentemente poca memoria |
| 122B A10B | 122B en total, 10B activos | 262K | Clase estación de trabajo | Líder en benchmarks de agentes |
| 397B A17B | 397B en total, 17B activos | 262K | Solo multi-GPU | Modelo insignia |
Las cifras de VRAM son reglas generales con cuantización a 4 bits. Deja margen para el contexto y la caché KV, y deja mucho más si piensas usar algo cercano a esa ventana de 262K.
Dos cosas saltan a la vista. El modelo más pequeño de Qwen es un tercio del tamaño del más pequeño de Gemma. Y cada modelo Qwen 3.5 trae el mismo contexto de 262,144 tokens, ampliable a cerca de un millón con YaRN, mientras que Gemma se divide en 128K para los modelos pequeños y 256K para todo lo demás.
Qwen te da más peldaños en la escalera. Gemma te da menos peldaños, pero pone más en cada uno.
¿Qué pareja deberías comparar en realidad?
Esta es la parte que confunde a la gente, y es la razón por la que "Gemma 4 vs Qwen 3.5" es casi una pregunta sin sentido hasta que la haces específica.
Los conteos de parámetros no se alinean entre estas familias. Los E2B y E4B de Gemma usan embeddings por capa, así que la "E" significa efectivo, es decir, los parámetros que realmente se cargan en la VRAM durante el cálculo. Comparar un modelo de 4.5B efectivos con uno denso de 4B por el número de la etiqueta no te dice nada útil.
Peor aún, el 26B A4B de Gemma es un Mixture of Experts que activa solo 3.8B parámetros por token. Ocupa la memoria de un modelo de 26B y el costo de cómputo de uno de 4B. El 35B A3B de Qwen hace el mismo truco con 3B activos. Así que una comparación "26B contra 35B" es en realidad una comparación entre dos modelos dispersos con tamaños activos parecidos y huellas totales distintas.
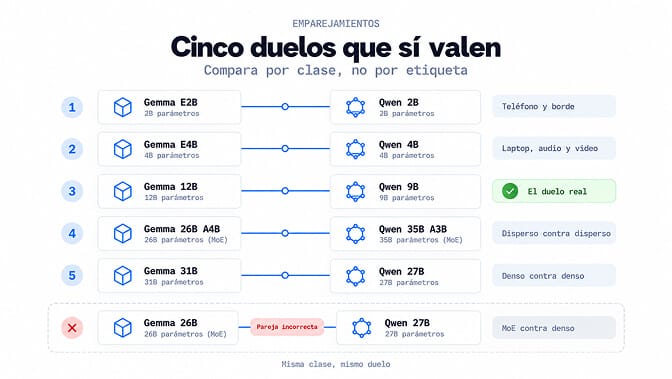
Este es el emparejamiento que sí se sostiene:
- Gemma 4 E2B contra Qwen 3.5 2B. Clase teléfono y borde.
- Gemma 4 E4B contra Qwen 3.5 4B. Clase laptop. Aquí Gemma suma audio y video nativos.
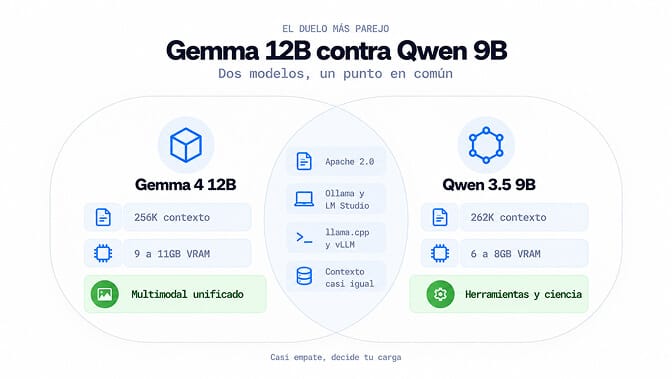
- Gemma 4 12B contra Qwen 3.5 9B. El duelo más parejo y más útil de toda la comparación.
- Gemma 4 26B A4B contra Qwen 3.5 35B A3B. Disperso contra disperso.
- Gemma 4 31B contra Qwen 3.5 27B. Denso contra denso, y el que todos miden.
Por encima de esa línea, Qwen corre solo. No hay respuesta de Gemma 4 al 122B ni al 397B. Y tampoco existe un Gemma 4 27B, diga lo que diga un buscador; el tamaño 27B era de Gemma 3.
Cara a cara por nivel de tamaño
Nivel pequeño: E2B y E4B contra Qwen 2B y 4B
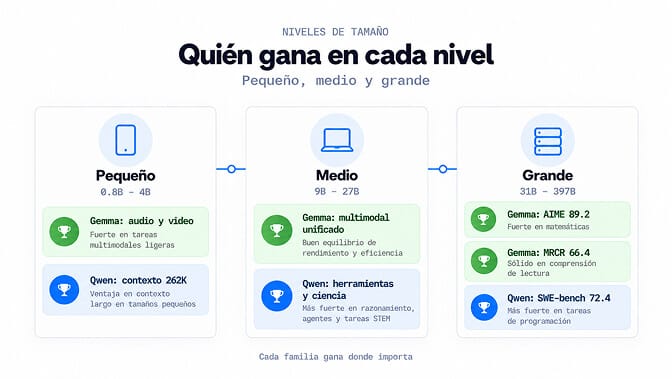
Gemma gana este nivel en capacidad por gigabyte, y en trabajo multimodal la diferencia no es pequeña. Los E2B y E4B traen entrada de audio nativa, incluido reconocimiento de voz, y manejan video a más o menos un cuadro por segundo durante hasta un minuto. Los modelos pequeños de Qwen también son multimodales, pero el audio no es su fuerte.
Qwen gana en contexto. Un modelo de 2B con una ventana de 262K es poco común y sirve para procesar documentos largos en un hardware que no debería poder hacerlo.
Si estás construyendo algo que escucha, elige Gemma. Si estás construyendo algo que lee mucho, elige Qwen.
Nivel medio: Gemma 4 12B contra Qwen 3.5 9B
La pelea más interesante, y la que casi todos los que tienen una máquina de 16GB van a vivir.
El 12B de Gemma es arquitectónicamente extraño, y para bien. No tiene codificadores y es unificado: elimina los codificadores separados de visión y audio y proyecta directamente en el decodificador los parches de imagen y el audio sin procesar. Comparaciones de terceros lo ponen por delante en benchmarks prácticos de código y en razonamiento multilingüe.
El 9B de Qwen se lleva los benchmarks de conocimiento, ciencia y uso agéntico de herramientas por márgenes claros, y la brecha en uso de herramientas es una de las más amplias de toda la comparación. Además te deja un poco más de margen, porque el 9B a 4 bits cabe cómodamente en menos de 7GB, mientras que el 12B pide cerca de 8.
Ninguno tiene un Elo de Arena publicado en este nivel, así que quien te cite uno está adivinando.
Nivel grande: Gemma 4 31B contra Qwen 3.5 27B
Los dos caben en una sola tarjeta de 24GB. Los dos reclaman el territorio del otro. Los números publicados no coinciden según quién los corrió, que es lo más honesto que se puede decir de este duelo.
La ficha de Google y pruebas de terceros ponen a Gemma 4 31B en 89.2 en AIME 2026, 80.0 en LiveCodeBench v6, 84.3 en GPQA Diamond, 85.2 en MMLU Pro y 66.4 en MRCR v2 de recuperación de contexto largo. Ese último número es el que más importa: Gemma 3 27B, el mejor modelo anterior de la familia, sacó 13.5 en la misma prueba. La ventana de 128K de Gemma 3 era casi decorativa. La ventana de 256K de Gemma 4 sí recupera información.
Qwen 3.5 27B registra 72.4 en SWE-bench Verified, lo que empata con GPT-5 mini y es una cifra seria para un modelo denso totalmente abierto de ese tamaño. Una evaluación independiente de los checkpoints en BF16 encontró a Gemma 4 31B por delante en la mayoría de los benchmarks, con MMLU Pro y GPQA Diamond como excepciones. Otro ranking pone a Qwen muy por delante en código, impulsado casi por completo por SWE-Rebench.
No pueden tener razón los dos, y eso ya te dice algo.
El duelo denso del nivel grande contra el Qwen 27B más nuevo lo pusimos en nuestra comparación Gemma 4 31B vs Qwen 3.6 27B.
Dónde encajan Qwen 3.6 y Qwen 3.8
Qwen 3.5 era la línea vigente cuando esta comparación salió en agosto. Ya no es el Qwen más nuevo, y importa exactamente qué versiones más recientes puedes ejecutar de verdad.
Qwen 3.6 (abril de 2026) lanzó pesos abiertos en dos tamaños: un modelo mixture-of-experts 35B-A3B y un modelo denso de 27B publicado el 22 de abril. Ambos aceptan texto, imagen y video, ambos tienen un contexto nativo de 262K, y ambos están en Ollama como qwen3.6:35b-a3b y qwen3.6:27b. La ficha propia de Alibaba para Qwen3.6-27B lo pone por delante de Gemma 4 31B en SWE-bench Verified (77.2 contra 52.0), GPQA Diamond (87.8 contra 84.3), LiveCodeBench v6 (83.9 contra 80.0) y AIME 2026 (94.1 contra 89.2). Son cifras reportadas por el fabricante, y la ficha de Google muestra la fortaleza del 31B en recuperación de contexto largo, que la tabla de Alibaba no incluye.
Qwen 3.7 (Max y Plus, mayo y junio de 2026) es solo por API. No hay pesos abiertos, nada que descargar en Ollama.
Qwen 3.8 es la línea de pesos abiertos vigente. Qwen3.8-27B salió el 14 de agosto de 2026: denso, Apache 2.0, contexto nativo de 262K, entrada de texto, imagen y video, con el razonamiento activado por defecto y profundidad de razonamiento ajustable. Está en Ollama como qwen3.8:27b y pesa unos 18GB. El 26 de agosto de 2026, Qwen añadió Qwen3.8-Flash-Next: un Mixture of Experts de 125B parámetros con 6B activos por token, pesos abiertos bajo la licencia Qwen Community 1.0 y una vista previa temprana de la arquitectura Qwen4. Activa pocos parámetros por token, pero igual tienes que mantener los 125B en memoria, así que es un modelo para estación de trabajo o multi-GPU, no un rival para nada de la gama Gemma 4. El otro lanzamiento abierto de la serie 3.8 es un modelo de clase Max con 2.4T de parámetros que ninguna configuración casera va a ejecutar. Si piensas ponerlo detrás de un agente, lee primero nuestra solución al tool calling de Qwen3.8 27B, porque algunas integraciones de agentes se cuelgan con él a través del endpoint /v1 de Ollama.
Lo que esto cambia en los duelos de arriba:
- Niveles pequeño y medio: nada. Ni Qwen 3.6 ni 3.8 lanzan un modelo abierto por debajo de 27B, así que E2B, E4B y 12B se siguen comparando mejor con los 2B, 4B y 9B de Qwen 3.5.
- Nivel disperso: ahora el Gemma 4 26B A4B se puede comparar con el Qwen 3.6 35B A3B además de con la versión 3.5. Si lo tuyo son los agentes de código, mira también Ornith 1.5 35B, construido sobre la misma arquitectura MoE de Qwen 3.5 con los mismos 3B parámetros activos.
- Nivel denso grande: el verdadero rival de Gemma 4 31B es ahora Qwen 3.6 27B o Qwen 3.8 27B, no Qwen 3.5 27B. Misma huella de memoria, modelo más nuevo.
Gemma vs Qwen para código
Qwen, en cada versión de Qwen que puedas meter en una tarjeta de 24GB junto a Gemma 4 31B. Los números de código repartidos por esta página apuntan todos en la misma dirección una vez que los alineas.
| Duelo | Resultado en código (Gemma vs Qwen) | Mejor para código |
|---|---|---|
| Gemma 4 31B vs Qwen 3.8 27B | LiveCodeBench v6: 80.0 vs 90.3 (fichas de los fabricantes). Suite independiente de 12 tareas: 6/12 vs 12/12 | Qwen 3.8 27B |
| Gemma 4 31B vs Qwen 3.6 27B | LiveCodeBench v6: 80.0 vs 83.9 (fichas de los fabricantes). Misma suite independiente: 6/12 vs 8/12 | Qwen 3.6 27B |
| Gemma 4 31B vs Qwen 3.5 27B | Qwen registra 72.4 en SWE-bench Verified. Google no publica ninguna puntuación SWE-bench para el 31B, y los rankings de terceros no coinciden | Se inclina por Qwen 3.5 27B |
| Gemma 4 12B vs Qwen 3.5 9B | Las comparaciones publicadas no coinciden en este tamaño | Demasiado parejo para decidir |
Gemma 4 vs Qwen 3.6 para código. Qwen 3.6 27B supera a Gemma 4 31B en código, pero va una generación por detrás de Qwen 3.8 27B, que es la misma descarga de 18GB y lidera a la 3.6 en cada benchmark de código que publica Alibaba (61.7 contra 53.5 en SWE-bench Pro, 73.0 contra 63.4 en Terminal Bench 2.1). A menos que tu framework de agentes caiga en el cuelgue de tool calling de Qwen 3.8 por /v1, empieza los proyectos nuevos de código con la 3.8. El desglose completo está en nuestra comparación Gemma 4 31B vs Qwen 3.6 27B.
Donde Gemma todavía se gana un lugar en una configuración de código es en el formato estricto de las llamadas a herramientas. En la misma prueba independiente, Gemma 4 31B acertó 90 de 90 llamadas simples y 30 de 30 en ejecuciones de varios pasos. Si tu agente de código falla por llamadas mal formadas y no por código malo, ese historial importa más que la brecha en código.
Lo que dicen los benchmarks en toda la gama, y dónde dejan de servir
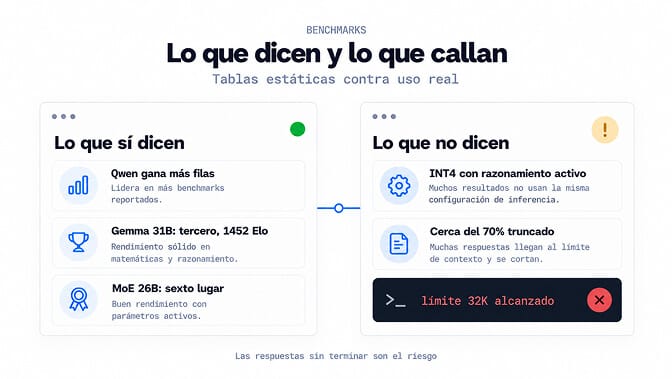
Esto es lo que ves cuando lees suficientes de estas tablas. Los benchmarks estáticos favorecen a Qwen en más filas individuales. Las pruebas de preferencia humana favorecen a Gemma en la gama alta. Gemma 4 31B llegó al tercer lugar en el ranking de texto de Arena con unos 1452 de Elo, y el MoE de 26B quedó sexto con alrededor de 1441.
Ese resultado del 26B merece una segunda mirada. Alcanza cerca del 97% de la calidad del 31B denso mientras activa 3.8B parámetros por token en lugar de 30.7B. Ocho veces menos cómputo por paso, y sexto lugar en un ranking lleno de modelos con muchos más parámetros activos.
Y esto es lo que la mayoría de las guías omite sobre ejecutar cualquiera de las dos familias en casa. La cuantización no solo te cuesta precisión, te cuesta respuestas completas. Una prueba de una cuantización INT4 de Qwen 3.5 con razonamiento activado encontró que truncaba cerca del 70% de las respuestas de AIME 2025 al chocar con el tope de salida de 32K, frente a más o menos 30% del modelo en precisión completa. Los pesos casi no perdieron precisión. Simplemente, el modelo empezó a pensar demasiado para terminar.
Ese es el modo de falla que vas a encontrar a la 1:40 a. m. No respuestas equivocadas. Respuestas sin terminar.
Si estás eligiendo un modelo para ponerlo detrás de un agente y no de una ventana de chat, esa distinción importa más que cualquier fila de un ranking, y nuestra guía para elegir el modelo adecuado para la tarea explica qué modos de falla rompen de verdad los ciclos de un agente.
Un comentario rápido sobre dónde encaja esto. Construimos una plataforma de agentes sin código, y somos bring-your-own-key con 28 proveedores y sin ningún recargo sobre la inferencia, lo que significa que no tenemos ningún interés económico en empujarte hacia un modelo u otro. Si quieres apuntar un agente a cualquiera de estos dos que elijas, nuestra configuración de proveedores y BYOK toma cerca de un minuto, y puedes entrar a BetterClaw y conectar tu clave de inmediato.
Qué elegir según tu hardware
Sáltate todo lo anterior y empieza aquí si ya sabes cuánta VRAM tienes.
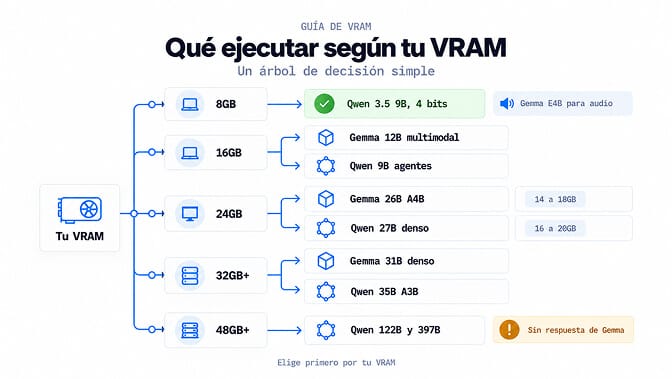
8GB. Qwen 3.5 9B a 4 bits, o Gemma 4 E4B si necesitas audio. El 9B es el modelo con mejor capacidad por gigabyte de las dos familias y te deja espacio para usar de verdad la ventana de contexto. El 12B de Gemma técnicamente carga, y después pelea contigo por la memoria.
16GB. Este es el verdadero punto de decisión. Gemma 4 12B si tu trabajo es multimodal o multilingüe. Qwen 3.5 9B si tu trabajo son las llamadas agénticas a herramientas, usando la memoria sobrante para un contexto más largo. El MoE de 26B también es alcanzable aquí con cuantización agresiva, aunque lo vas a notar.
24GB. Los finalistas son Gemma 4 26B A4B y un Qwen denso de 27B. El MoE de Gemma es más rápido y frugal, unos 14 a 18GB a 4 bits, y multimodal. El Qwen denso de 27B programa mejor, ocupa unos 16 a 20GB, y en este tamaño puedes elegir entre Qwen 3.5, 3.6 o 3.8. Gemma 4 31B cabe con 18 a 20GB, pero te deja poco espacio para el contexto.
32GB o más. Gemma 4 31B denso a 4 bits con espacio real para contexto (a 8 bits necesita unos 35GB), o Qwen 3.5 o 3.6 35B A3B, que corre mucho más ligero de lo que sugiere su conteo total de parámetros porque solo 3B se activan por token. Por encima de 48GB, el 122B A10B de Qwen es el líder en benchmarks de agentes y Gemma no tiene respuesta.
Una nota práctica para quienes los ejecutan detrás de un agente siempre activo y no en una sesión interactiva: el límite de memoria no es tu restricción, lo es el rendimiento sostenido.
Todas las comparaciones Gemma vs Qwen que hemos probado
- Gemma 4 vs Qwen 3.8: el Qwen más nuevo contra la familia Gemma 4, con los números detallados de Qwen 3.8.
- Gemma 4 12B vs Qwen 3.5 9B: la decisión de 16GB, benchmark por benchmark.
- Gemma 4 31B vs Qwen 3.6 27B: el extremo denso en una tarjeta de 24GB, incluida la suite independiente de código y llamadas a herramientas.
El duelo más parejo merece su propia página
Si tienes una máquina de 16GB, la decisión entre Gemma 4 12B y Qwen 3.5 9B es la única que te importa, y es tan pareja que un párrafo no la resuelve.
Los dos están bajo Apache 2.0. Las ventanas de contexto son casi idénticas, de 256K y 262K. Los dos corren en Ollama, LM Studio, llama.cpp y vLLM. La diferencia está entre el decodificador multimodal unificado de Gemma y los puntajes de llamadas a herramientas y conocimiento de Qwen, más un gigabyte aproximado de margen de memoria.
Lo corrimos en serio, benchmark por benchmark, en la comparación completa Gemma 4 12B vs Qwen 3.5 9B. Si tu máquina tiene 16GB, lee esa en lugar de esta. Si tienes una tarjeta de 24GB y quieres el extremo denso, la comparación Gemma 4 31B vs Qwen 3.6 27B es la que debes leer.
Si algo de esto te resonó, empieza con BetterClaw. Trae tu propia clave y paga a tu proveedor directamente, sin nada añadido encima. Pro cuesta $49 al mes por cinco agentes, o $39 en el plan anual. Aquí están todos los precios. Tu primer despliegue toma cerca de un minuto, y la elección del modelo sigue siendo tuya.
Una última reflexión. Hace un año, la pregunta interesante sobre los modelos abiertos era si podían competir con los cerrados. Esa pregunta ya está resuelta. La pregunta interesante ahora es cuál de los ocho o trece modelos que un solo fabricante lanza en un solo trimestre es el correcto para tu máquina en particular, y ningún ranking va a responderla por ti. Descarga dos. Corre tu propia carga de trabajo en ambos. Gana el que termina sus frases.
Preguntas frecuentes
¿Cuál es la diferencia entre Gemma 4 y Qwen 3.5?
Gemma 4 es la familia de pesos abiertos de Google DeepMind, lanzada el 2 de abril de 2026 con el 12B añadido el 3 de junio. Tiene cinco tamaños, desde E2B hasta un insignia denso de 31B (no existe un Gemma 4 27B), más de 140 idiomas y audio nativo en los modelos más pequeños. Qwen 3.5 es la familia de Alibaba lanzada entre febrero y marzo de 2026, con ocho tamaños desde 0.8B hasta un insignia Mixture of Experts de 397B, 201 idiomas y una ventana de contexto uniforme de 262K. Ambas tienen licencia Apache 2.0 sin restricciones comerciales.
¿Debo usar Qwen 3.6 o Qwen 3.8 en lugar de Qwen 3.5?
Solo si tienes la memoria para un modelo de clase 27B. Qwen 3.6 lanza pesos abiertos en 27B denso y 35B A3B, y el modelo local práctico de Qwen 3.8 es Qwen3.8-27B, publicado el 14 de agosto de 2026. Ambos están en Ollama. Qwen3.8-Flash-Next (125B MoE, 6B activos, pesos abiertos desde el 26 de agosto de 2026) también se puede descargar, pero necesita mucha más memoria que cualquier modelo Gemma 4. Por debajo de 27B, Qwen 3.5 sigue siendo el Qwen más nuevo que puedes ejecutar, así que en máquinas de 8 a 16GB la comparación de Gemma 4 contra Qwen 3.5 sigue vigente. Qwen 3.7 es solo por API y no se puede ejecutar en local.
¿Cómo se compara Gemma 4 31B con Qwen 3.5 27B?
Es el duelo más parejo del nivel grande y ambos caben en una sola GPU de 24GB. Gemma 4 31B lidera en multimodal, multilingüe y recuperación de contexto largo, con 66.4 en MRCR v2 frente a 13.5 de su predecesor Gemma 3. Qwen 3.5 27B lidera en código, con 72.4 en SWE-bench Verified. Las evaluaciones independientes no coinciden sobre el ganador general, lo cual es una buena señal de que tu propia carga de trabajo debe decidirlo.
¿Cómo ejecuto Gemma 4 o Qwen 3.5 en local?
Ambas familias son compatibles con Ollama, LM Studio, llama.cpp, vLLM y MLX, con cuantizaciones GGUF publicadas en Hugging Face. Descarga el modelo que quepa en tu VRAM a 4 bits y luego limita la longitud de contexto en lugar de aceptar el valor por defecto de 256K, porque la asignación de caché KV con el contexto completo agotará la memoria del hardware de consumo mucho antes que los pesos.
¿Es más barato ejecutar Gemma 4 o Qwen 3.5?
Ambos se descargan gratis bajo Apache 2.0, así que el costo es solo de hardware y electricidad. Los ganadores en eficiencia son los modelos dispersos: Gemma 4 26B A4B activa 3.8B parámetros por token y alcanza cerca del 97% de la calidad del 31B denso, y Qwen 3.5 35B A3B activa solo 3B. Si lo comparas con APIs alojadas, recuerda que cualquier plataforma de agentes administrada que cobre un recargo sobre la inferencia genera un costo recurrente que estos modelos no tienen.
¿Son los modelos abiertos como estos lo bastante confiables para ponerlos detrás de un agente en producción?
Para tareas acotadas y bien definidas, sí, y miles de equipos ya lo hacen. El riesgo no es la precisión, sino el comportamiento bajo cuantización: las cuantizaciones con razonamiento activado pueden agotar los límites de tokens de salida antes de producir una respuesta, y eso parece un cuelgue y no un error. Prueba con tus prompts reales y con tu nivel real de cuantización, fija un tope de salida y pon un paso de aprobación delante de cualquier acción destructiva antes de dejarlo correr sin supervisión.