Gemma 4 oder Qwen 3.8? Die schnelle Wahl nach GPU-Größe und Einsatz (Coding, Tool Calling, Chat), mit Links zu allen Kopf-an-Kopf-Vergleichen, die wir getestet haben.
Zwei Open-Weight-Familien, dreizehn Modelle zusammen, und eine Frage, die die meisten Vergleiche überspringen: Welche Paarung sollten Sie eigentlich vergleichen?
Der Download des Modells war um 1:40 Uhr nachts fertig. Zweiundzwanzig Gigabyte, gezogen über das WLAN eines Hotels, weil jemand in einem Forum geschrieben hatte, genau dieses sei das richtige.
Es lud. Die erste Frage beantwortete es nach etwa vierzig Sekunden. Dann fing es an zu denken, und zu denken, und es dachte noch immer, als das Ausgabelimit mitten im Satz zuschlug. Es hatte elfhundert Token Überlegung produziert und null Token Antwort.
So fühlt sich die Wahl eines lokalen Modells im Jahr 2026 tatsächlich an, und es ist kein Benchmark-Problem. Es ist ein Paarungsproblem.
Schnelle Auswahl nach GPU
| Ihr VRAM | Das laufen lassen | Warum | Vollständiger Vergleich |
|---|---|---|---|
| 8 GB | Qwen 3.5 9B (4-Bit), oder Gemma 4 E4B für Audio | Beste Leistung pro Gigabyte, mit Platz für Kontext | Gemma 4 12B vs Qwen 3.5 9B |
| 12 GB | Qwen 3.5 9B für Tool Calling, Gemma 4 12B für Bilder und Audio | Das 12B passt in 4-Bit mit etwa 7 bis 8GB, lässt aber weniger Platz für Kontext | Gemma 4 12B vs Qwen 3.5 9B |
| 16 GB | Gemma 4 12B (multimodal, mehrsprachig) oder Qwen 3.5 9B (Agenten) | Die knappste Entscheidung in beiden Familien | Gemma 4 12B vs Qwen 3.5 9B |
| 24 GB | Qwen 3.8 27B für Coding, Gemma 4 26B A4B für Tempo | Beide passen in 4-Bit; Qwen 3.8 ist der stärkere Coder, das Gemma-MoE das schnellere Modell | Gemma 4 vs Qwen 3.8 |
| 32 GB+ | Gemma 4 31B mit echtem Kontextspielraum, oder Qwen 3.6 35B A3B | Dichte Qualität gegen ein leichtes MoE | Gemma 4 31B vs Qwen 3.6 27B |
Die Details zu jeder Zeile finden Sie weiter unten unter Welches Modell zu welcher Hardware passt.
Wenn Sie sich nur für das neueste Qwen in der 24GB-Klasse interessieren, behandelt unser Vergleich Gemma 4 vs Qwen 3.8 genau diese Paarung für sich.
Jetzt zeigen wir, warum die meisten Vergleichsartikel schon vor dem Start danebenliegen.
Alle Größen im direkten Vergleich
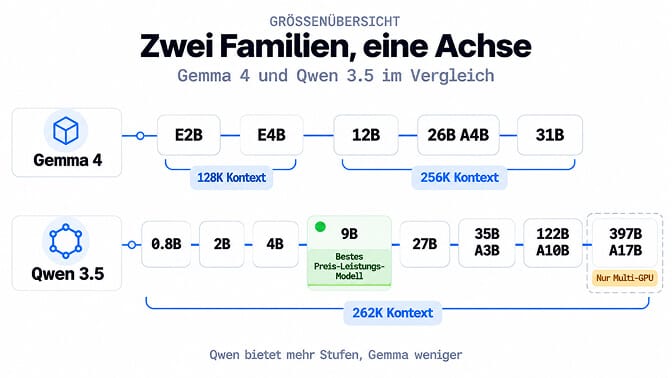
Beide Familien erschienen 2026 im Abstand von acht Wochen. Beide stehen unter Apache 2.0. Beide sind multimodal. Dort enden die Gemeinsamkeiten auch schon, denn sie sind völlig unterschiedlich geschnitten.
Gemma 4 (Google DeepMind, 2. April 2026 für E2B, E4B, 26B A4B und 31B, das 12B kam am 3. Juni 2026 dazu, Apache 2.0, 140+ Sprachen):
| Modell | Parameter | Kontext | Ca. VRAM bei 4-Bit | Hinweise |
|---|---|---|---|---|
| E2B | ~2.3B effektiv | 128K | ~4GB | Smartphone- und Browser-Klasse, natives Audio |
| E4B | ~4.5B effektiv | 128K | ~5 bis 6GB | Laptop-Klasse, natives Audio und Video |
| 12B | 11.95B vereinheitlicht | 256K | ~7 bis 8GB | Ohne Encoder, verarbeitet Text, Bild und Audio in einem Decoder |
| 26B A4B | 25.2B gesamt, 3.8B aktiv | 256K | ~14 bis 18GB | Mixture of Experts, der Effizienz-Ansatz |
| 31B | 30.7B dicht | 256K | ~18 bis 20GB | Qualitätsspitze der Familie |
Qwen 3.5 (Alibaba, im Februar und März 2026 nach und nach veröffentlicht, Apache 2.0, 201 Sprachen):
| Modell | Parameter | Kontext | Ca. VRAM bei 4-Bit | Hinweise |
|---|---|---|---|---|
| 0.8B | 0.8B | 262K | ~1 bis 2GB | Edge und Embedded |
| 2B | 2B | 262K | ~2 bis 3GB | Smartphone-Klasse |
| 4B | 4B | 262K | ~4 bis 5GB | Laptop-Klasse |
| 9B | 9B | 262K | ~6 bis 8GB | Bestes Preis-Leistungs-Modell der Mittelklasse |
| 27B | 27B dicht | 262K | ~16 bis 20GB | Stärkster dichter offener Coder der Familie |
| 35B A3B | 35B gesamt, 3B aktiv | 262K | ~20 bis 24GB | MoE, läuft überraschend klein |
| 122B A10B | 122B gesamt, 10B aktiv | 262K | Workstation-Klasse | Spitzenreiter bei Agenten-Benchmarks |
| 397B A17B | 397B gesamt, 17B aktiv | 262K | Nur Multi-GPU | Flaggschiff |
Die VRAM-Angaben sind Faustwerte bei 4-Bit-Quantisierung. Planen Sie Reserve für Kontext und KV-Cache ein, und eine große Reserve, wenn Sie irgendetwas in die Nähe des 262K-Fensters bringen wollen.
Zwei Dinge fallen auf. Qwens kleinstes Modell ist ein Drittel so groß wie Gemmas kleinstes. Und jedes einzelne Qwen-3.5-Modell liefert denselben Kontext von 262.144 Token, mit YaRN erweiterbar auf etwa eine Million, während Gemma bei den kleinen Modellen bei 128K liegt und bei allem darüber bei 256K.
Qwen gibt Ihnen mehr Sprossen auf der Leiter. Gemma gibt Ihnen weniger Sprossen, packt dafür mehr auf jede einzelne.
Welche Paarungen sollten Sie wirklich vergleichen?
Genau hier stolpern die meisten, und deshalb ist "Gemma 4 vs Qwen 3.5" eine nahezu bedeutungslose Frage, solange Sie sie nicht konkret machen.
Die Parameterzahlen dieser Familien passen nicht zueinander. Gemmas E2B und E4B nutzen Per-Layer-Embeddings, das "E" steht also für "effektiv": die Parameter, die bei der Berechnung tatsächlich in den VRAM geladen werden. Ein effektives 4.5B-Modell anhand der Zahl auf dem Etikett mit einem dichten 4B-Modell zu vergleichen, sagt Ihnen nichts Brauchbares.
Schlimmer noch: Gemmas 26B A4B ist ein Mixture of Experts, der pro Token nur 3.8B Parameter aktiviert. Es belegt den Speicher eines 26B-Modells und hat den Rechenaufwand eines 4B-Modells. Qwens 35B A3B macht denselben Trick mit 3B aktiv. Ein Vergleich "26B gegen 35B" ist also in Wahrheit ein Vergleich zweier spärlicher Modelle mit ähnlicher aktiver Größe und unterschiedlichem Gesamtumfang.
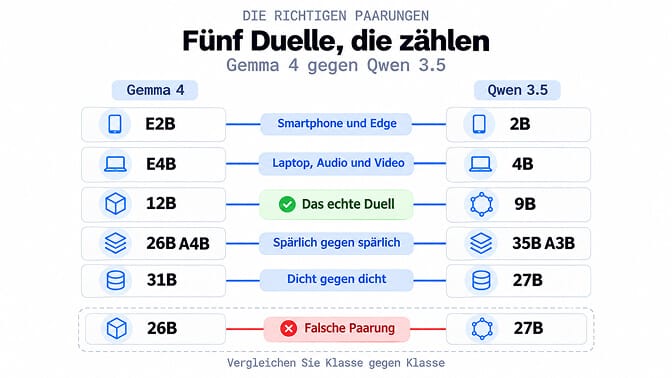
Diese Zuordnung hält einer Prüfung stand:
- Gemma 4 E2B gegen Qwen 3.5 2B. Smartphone- und Edge-Klasse.
- Gemma 4 E4B gegen Qwen 3.5 4B. Laptop-Klasse. Gemma bringt hier natives Audio und Video mit.
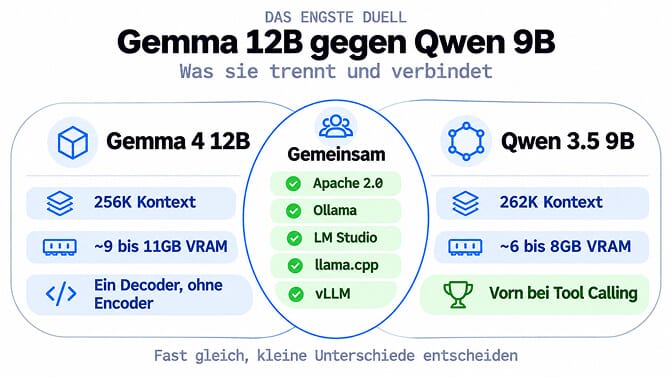
- Gemma 4 12B gegen Qwen 3.5 9B. Das engste und nützlichste Duell im gesamten Vergleich.
- Gemma 4 26B A4B gegen Qwen 3.5 35B A3B. Spärlich gegen spärlich.
- Gemma 4 31B gegen Qwen 3.5 27B. Dicht gegen dicht, und das Duell, das alle benchmarken.
Oberhalb dieser Linie läuft Qwen allein. Auf das 122B oder das 397B gibt es keine Gemma-4-Antwort. Und ein Gemma 4 27B gibt es überhaupt nicht, was auch immer ein Suchfeld vorschlägt; die Größe 27B gehörte zu Gemma 3.
Direktvergleich nach Größenklasse
Kleine Klasse: E2B und E4B gegen Qwen 2B und 4B
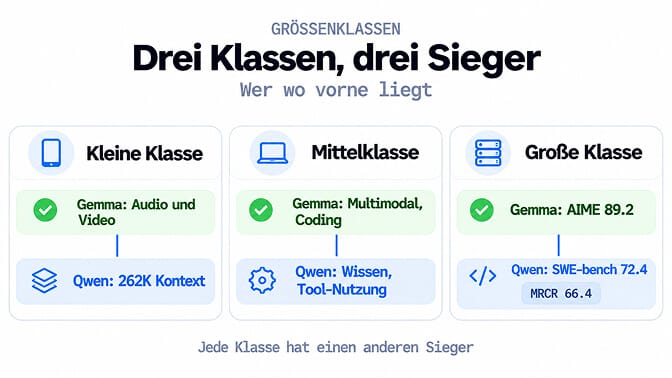
Gemma gewinnt diese Klasse bei der Leistung pro Gigabyte, und bei multimodaler Arbeit ist es nicht einmal knapp. E2B und E4B liefern nativen Audio-Eingang samt Spracherkennung und verarbeiten Video mit etwa einem Bild pro Sekunde bis zu einer Minute Länge. Auch Qwens kleine Modelle sind multimodal, aber Audio ist nicht ihre Stärke.
Qwen gewinnt beim Kontext. Ein 2B-Modell mit einem 262K-Fenster ist ungewöhnlich und nützlich, um lange Dokumente auf Hardware durchzukauen, die dafür eigentlich nicht gedacht ist.
Wenn Sie etwas bauen, das zuhört, nehmen Sie Gemma. Wenn Sie etwas bauen, das viel liest, nehmen Sie Qwen.
Mittelklasse: Gemma 4 12B gegen Qwen 3.5 9B
Der interessanteste Kampf, und der, den die meisten mit einem 16GB-Rechner tatsächlich vor sich haben.
Gemmas 12B ist architektonisch auf gute Weise seltsam. Es ist encoder-frei und vereinheitlicht: Es verzichtet auf die getrennten Vision- und Audio-Encoder und projiziert rohe Bildausschnitte und Audio direkt in den Decoder. Vergleiche von Drittanbietern sehen es bei praxisnahen Coding-Benchmarks und mehrsprachigem Schlussfolgern vorn.
Qwens 9B gewinnt die Benchmarks zu Wissen, Wissenschaft und agentischer Tool-Nutzung mit deutlichem Abstand, wobei die Lücke bei der Tool-Nutzung eine der größten im gesamten Vergleich ist. Es lässt Ihnen außerdem etwas mehr Spielraum, denn 9B in 4-Bit liegt bequem unter 7GB, während das 12B eher an 8GB heranreicht.
Für diese Klasse gibt es bei keinem von beiden ein veröffentlichtes Arena-Elo. Wer Ihnen eines nennt, rät also.
Große Klasse: Gemma 4 31B gegen Qwen 3.5 27B
Beide passen auf eine einzelne 24GB-Karte. Beide erheben Anspruch auf das Revier des anderen. Die veröffentlichten Zahlen widersprechen sich, je nachdem, wer sie gemessen hat, und das ist das Ehrlichste, was sich zu diesem Duell sagen lässt.
Googles Modellkarte und Läufe von Drittanbietern sehen Gemma 4 31B bei 89.2 auf AIME 2026, 80.0 auf LiveCodeBench v6, 84.3 auf GPQA Diamond, 85.2 auf MMLU Pro und 66.4 auf MRCR v2 für Long-Context-Retrieval. Die letzte Zahl ist die wichtigste: Gemma 3 27B, die vorherige Spitze der Familie, erreichte im selben Test 13.5. Das 128K-Fenster von Gemma 3 war größtenteils Dekoration. Das 256K-Fenster von Gemma 4 findet tatsächlich etwas.
Qwen 3.5 27B erreicht 72.4 auf SWE-bench Verified, was GPT-5 mini entspricht und für ein vollständig offenes dichtes Modell dieser Größe eine ernstzunehmende Zahl ist. Eine unabhängige Auswertung der BF16-Checkpoints sah Gemma 4 31B bei den meisten Benchmarks vorn, mit MMLU Pro und GPQA Diamond als Ausnahmen. Ein anderes Leaderboard sieht Qwen beim Coding deutlich vorn, getrieben fast ausschließlich von SWE-Rebench.
Beide können nicht recht haben, und das sagt Ihnen etwas.
Den Kampf der dichten großen Klasse gegen Qwens neueres 27B haben wir in unserem Vergleich Gemma 4 31B vs Qwen 3.6 27B ausgetragen.
Wo Qwen 3.6 und Qwen 3.8 hineinpassen
Qwen 3.5 war die aktuelle Linie, als dieser Vergleich im August erschien. Es ist nicht mehr das neueste Qwen, und es kommt genau darauf an, welche neueren Releases Sie tatsächlich betreiben können.
Qwen 3.6 (April 2026) erschien mit offenen Gewichten in zwei Größen: einem 35B-A3B-Mixture-of-Experts-Modell und einem dichten 27B-Modell, veröffentlicht am 22. April. Beide verarbeiten Text, Bild und Video, beide haben 262K nativen Kontext, und beide gibt es in Ollama als qwen3.6:35b-a3b und qwen3.6:27b. Alibabas eigene Karte für Qwen3.6-27B sieht es vor Gemma 4 31B bei SWE-bench Verified (77.2 gegen 52.0), GPQA Diamond (87.8 gegen 84.3), LiveCodeBench v6 (83.9 gegen 80.0) und AIME 2026 (94.1 gegen 89.2). Das sind vom Hersteller gemeldete Zahlen, und Googles Karte zeigt die Stärke des 31B beim Long-Context-Retrieval, das in Alibabas Tabelle nicht vorkommt.
Qwen 3.7 (Max und Plus, Mai und Juni 2026) gibt es nur per API. Keine offenen Gewichte, nichts, was Sie in Ollama ziehen könnten.
Qwen 3.8 ist die aktuelle Open-Weight-Linie. Qwen3.8-27B erschien am 14. August 2026: dicht, Apache 2.0, 262K nativer Kontext, Eingabe von Text, Bild und Video, mit standardmäßig aktivem Denken und einstellbarer Denktiefe. Es gibt es in Ollama als qwen3.8:27b mit etwa 18GB. Am 26. August 2026 ergänzte Qwen Qwen3.8-Flash-Next: ein Mixture of Experts mit 125 Milliarden Parametern und 6B aktiv pro Token, offene Gewichte unter der Qwen Community 1.0 License und eine frühe Vorschau auf die Qwen4-Architektur. Es aktiviert pro Token nur wenige Parameter, aber alle 125B müssen trotzdem im Speicher liegen, es ist also ein Workstation- oder Multi-GPU-Modell und kein Rivale für irgendetwas aus der Gemma-4-Reihe. Der übrige offene 3.8-Release ist ein Modell der Max-Klasse mit 2.4T Parametern, das kein Heimaufbau betreiben wird. Wenn Sie es hinter einen Agenten schalten wollen, lesen Sie zuerst unsere Lösung für das Tool-Calling-Problem von Qwen3.8 27B, denn manche Agenten-Integrationen hängen sich damit über Ollamas /v1-Endpunkt auf.
Was das an den obigen Paarungen ändert:
- Kleine und mittlere Klasse: nichts. Weder Qwen 3.6 noch 3.8 liefert ein offenes Modell unter 27B, daher werden E2B, E4B und 12B weiterhin am besten mit Qwen 3.5 2B, 4B und 9B verglichen.
- Spärliche Klasse: Gemma 4 26B A4B lässt sich jetzt auch mit Qwen 3.6 35B A3B vergleichen, nicht nur mit der 3.5-Version. Wenn Coding-Agenten die Aufgabe sind, schauen Sie sich zusätzlich Ornith 1.5 35B an, gebaut auf derselben Qwen-3.5-MoE-Architektur mit denselben 3B aktiven Parametern.
- Dichte große Klasse: Der eigentliche Rivale von Gemma 4 31B ist jetzt Qwen 3.6 27B oder Qwen 3.8 27B, nicht mehr Qwen 3.5 27B. Gleicher Speicherbedarf, neueres Modell.
Gemma vs Qwen beim Coding
Qwen, bei jeder Qwen-Version, die neben Gemma 4 31B auf eine 24GB-Karte passt. Die Coding-Zahlen, die sich über diese Seite verteilen, zeigen alle in dieselbe Richtung, sobald man sie nebeneinanderlegt.
| Duell | Coding-Ergebnis (Gemma vs Qwen) | Besser fürs Coding |
|---|---|---|
| Gemma 4 31B vs Qwen 3.8 27B | LiveCodeBench v6: 80.0 vs 90.3 (Herstellerkarten). Unabhängige Suite mit 12 Aufgaben: 6/12 vs 12/12 | Qwen 3.8 27B |
| Gemma 4 31B vs Qwen 3.6 27B | LiveCodeBench v6: 80.0 vs 83.9 (Herstellerkarten). Dieselbe unabhängige Suite: 6/12 vs 8/12 | Qwen 3.6 27B |
| Gemma 4 31B vs Qwen 3.5 27B | Qwen erreicht 72.4 auf SWE-bench Verified. Google veröffentlicht für das 31B keinen SWE-bench-Wert, und Leaderboards von Drittanbietern widersprechen sich | Tendenziell Qwen 3.5 27B |
| Gemma 4 12B vs Qwen 3.5 9B | Veröffentlichte Vergleiche widersprechen sich in dieser Größe | Zu knapp für eine Entscheidung |
Gemma 4 vs Qwen 3.6 beim Coding. Qwen 3.6 27B schlägt Gemma 4 31B beim Code, ist aber eine Generation hinter Qwen 3.8 27B, das derselbe 18GB-Download ist und bei jedem von Alibaba veröffentlichten Coding-Benchmark vor 3.6 liegt (61.7 gegen 53.5 bei SWE-bench Pro, 73.0 gegen 63.4 bei Terminal Bench 2.1). Solange Ihr Agenten-Framework nicht in das /v1-Tool-Calling-Problem von Qwen 3.8 läuft, starten Sie neue Coding-Projekte mit 3.8. Die vollständige Aufschlüsselung steht in unserem Vergleich Gemma 4 31B vs Qwen 3.6 27B.
Wo Gemma in einem Coding-Setup trotzdem seinen Platz verdient, ist das strikte Tool-Call-Format. Im selben unabhängigen Test erreichte Gemma 4 31B 90 von 90 bei einzelnen Tool-Aufrufen und 30 von 30 bei mehrstufigen Läufen. Wenn Ihr Coding-Agent an fehlerhaften Aufrufen scheitert und nicht an schlechtem Code, zählt diese Bilanz mehr als der Abstand beim Coding.
Was die Benchmarks über die ganze Bandbreite sagen, und wo sie nutzlos werden
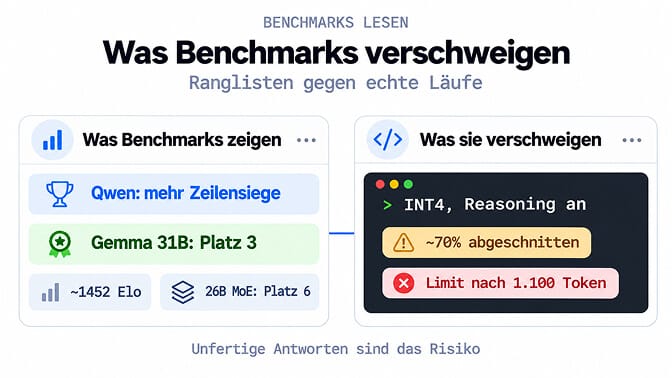
Das sehen Sie, sobald Sie genug dieser Tabellen gelesen haben. Statische Benchmarks bevorzugen Qwen in mehr einzelnen Zeilen. Tests zur menschlichen Präferenz bevorzugen Gemma an der Spitze. Gemma 4 31B erreichte in Arenas Text-Leaderboard mit etwa 1452 Elo den dritten Platz, das 26B-MoE mit rund 1441 den sechsten.
Dieses 26B-Ergebnis verdient einen zweiten Blick. Es erreicht etwa 97% der Qualität des dichten 31B und aktiviert dabei 3.8B Parameter pro Token statt 30.7B. Achtmal weniger Rechenaufwand pro Schritt, sechster Platz in einem Leaderboard voller Modelle mit weit mehr aktiven Parametern.
Und das lassen die meisten Ratgeber aus, wenn es ums Betreiben einer der beiden Familien zu Hause geht. Quantisierung kostet nicht nur Genauigkeit, sie kostet Antworten. Ein Test mit einer INT4-Quantisierung von Qwen 3.5 bei aktiviertem Reasoning ergab, dass etwa 70% der AIME-2025-Antworten abgeschnitten wurden, weil die Obergrenze von 32K Ausgabe-Token erreicht war, gegenüber etwa 30% beim Modell in voller Präzision. Die Gewichte verloren kaum an Genauigkeit. Das Modell begann nur, zu viel zu denken, um fertig zu werden.
Das ist die Fehlerart, die Ihnen um 1:40 Uhr nachts tatsächlich begegnet. Nicht falsche Antworten. Unfertige.
Wenn Sie ein Modell wählen, das hinter einem Agenten sitzen soll und nicht hinter einem Chatfenster, zählt diese Unterscheidung mehr als jede Zeile eines Leaderboards, und unser Leitfaden zur Wahl des richtigen Modells für die Aufgabe erklärt, welche Fehlerarten Agenten-Schleifen tatsächlich zum Scheitern bringen.
Kurzer Einschub, wo das hier hingehört. Wir bauen eine No-Code-Agentenplattform und arbeiten mit Bring-your-own-Key bei 28 Anbietern, ohne Aufschlag auf die Inferenz. Wir haben also keinen finanziellen Grund, Sie zu dem einen oder anderen Modell zu drängen. Wenn Sie einen Agenten auf das Modell richten wollen, für das Sie sich entscheiden, dauert unsere Anbieter- und BYOK-Einrichtung etwa eine Minute, und die Anmeldung geht genauso schnell.
Welches Modell zu welcher Hardware passt
Überspringen Sie alles oben und beginnen Sie hier, wenn Sie Ihren VRAM schon kennen.
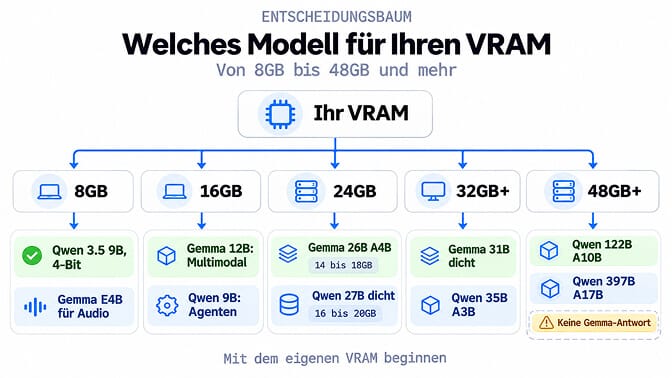
8GB. Qwen 3.5 9B in 4-Bit, oder Gemma 4 E4B, wenn Sie Audio brauchen. Das 9B ist das Modell mit der besten Leistung pro Gigabyte in beiden Familien und lässt Ihnen Platz, das Kontextfenster wirklich zu nutzen. Gemmas 12B lädt technisch gesehen, kämpft dann aber mit Ihnen um den Speicher.
16GB. Das ist der eigentliche Entscheidungspunkt. Gemma 4 12B, wenn Ihre Arbeit multimodal oder mehrsprachig ist. Qwen 3.5 9B, wenn Ihre Arbeit agentisches Tool Calling ist, mit dem übrigen Speicher für längeren Kontext. Das 26B-MoE ist hier bei aggressiver Quantisierung ebenfalls erreichbar, allerdings werden Sie es spüren.
24GB. Die Finalisten sind Gemma 4 26B A4B und ein dichtes Qwen 27B. Das Gemma-MoE ist schneller und sparsam, in 4-Bit etwa 14 bis 18GB, und multimodal. Das dichte Qwen 27B ist der stärkere Coder, etwa 16 bis 20GB, und in dieser Größe können Sie zwischen Qwen 3.5, 3.6 oder 3.8 wählen. Gemma 4 31B passt mit 18 bis 20GB, lässt aber wenig Platz für Kontext.
32GB und mehr. Gemma 4 31B dicht in 4-Bit mit echtem Platz für Kontext (8-Bit braucht etwa 35GB), oder Qwen 3.5 oder 3.6 35B A3B, das weit leichter läuft, als seine Gesamtparameterzahl vermuten lässt, weil nur 3B pro Token aktiv sind. Oberhalb von 48GB ist Qwens 122B A10B der Spitzenreiter bei Agenten-Benchmarks, und Gemma hat keine Antwort darauf.
Ein praktischer Hinweis für alle, die diese Modelle hinter einem dauerhaft laufenden Agenten betreiben statt in einer interaktiven Sitzung: Nicht die Speichergrenze ist Ihr Engpass, sondern der dauerhafte Durchsatz.
Jeder Gemma-vs-Qwen-Vergleich, den wir getestet haben
- Gemma 4 vs Qwen 3.8: das neueste Qwen gegen die Gemma-4-Familie, mit den detaillierten Qwen-3.8-Zahlen.
- Gemma 4 12B vs Qwen 3.5 9B: die 16GB-Entscheidung, Benchmark für Benchmark.
- Gemma 4 31B vs Qwen 3.6 27B: die dichte Spitze auf einer 24GB-Karte, einschließlich der unabhängigen Coding- und Tool-Call-Suite.
Das engste Duell verdient eine eigene Seite
Wenn Sie einen 16GB-Rechner haben, ist die Entscheidung zwischen Gemma 4 12B und Qwen 3.5 9B die einzige, die für Sie zählt, und sie ist so knapp, dass ein Absatz sie nicht klärt.
Beide stehen unter Apache 2.0. Die Kontextfenster sind mit 256K und 262K nahezu identisch. Beide laufen in Ollama, LM Studio, llama.cpp und vLLM. Der Unterschied liegt im vereinheitlichten multimodalen Decoder von Gemma gegenüber Qwens Werten bei Tool Calling und Wissen, plus etwa einem Gigabyte mehr Speicherspielraum.
Wir haben dieses Duell gründlich ausgewertet, Benchmark für Benchmark, im vollständigen Vergleich Gemma 4 12B vs Qwen 3.5 9B. Wenn Ihr Rechner 16GB hat, lesen Sie lieber diesen als den vorliegenden Artikel. Wenn Sie eine 24GB-Karte haben und die dichte Spitze wollen, ist der Vergleich Gemma 4 31B vs Qwen 3.6 27B der richtige.
Wenn Sie hier etwas mitnehmen konnten, starten Sie jetzt mit BetterClaw. Sie bringen Ihren eigenen Schlüssel mit und zahlen Ihren Anbieter direkt, ohne Aufschlag obendrauf. Pro kostet $49 im Monat für fünf Agenten, oder $39 bei jährlicher Zahlung. Alle Preise finden Sie hier. Ihr erstes Deployment dauert etwa eine Minute, und die Modellwahl bleibt bei Ihnen.
Ein letzter Gedanke. Vor einem Jahr lautete die interessante Frage zu offenen Modellen, ob sie mit geschlossenen mithalten können. Diese Frage ist entschieden. Die interessante Frage lautet heute, welches der acht oder dreizehn Modelle, die ein einzelner Anbieter in einem einzigen Quartal herausbringt, das richtige für Ihre konkrete Maschine ist, und kein Leaderboard wird Ihnen das je beantworten. Laden Sie zwei herunter. Schicken Sie Ihre eigene Arbeitslast durch beide. Das Modell, das seine Sätze zu Ende bringt, gewinnt.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Gemma 4 und Qwen 3.5?
Gemma 4 ist die Open-Weight-Familie von Google DeepMind, erschienen am 2. April 2026 mit dem 12B als Ergänzung am 3. Juni. Sie umfasst fünf Größen von E2B bis zu einem dichten 31B-Flaggschiff (ein Gemma 4 27B existiert nicht), 140+ Sprachen und natives Audio bei den kleinsten Modellen. Qwen 3.5 ist Alibabas Familie, die im Februar und März 2026 nach und nach erschien, mit acht Größen von 0.8B bis zu einem Mixture-of-Experts-Flaggschiff mit 397B, 201 Sprachen und einheitlich 262K Kontextfenster. Beide stehen unter Apache 2.0 ohne kommerzielle Einschränkungen.
Sollte ich Qwen 3.6 oder Qwen 3.8 statt Qwen 3.5 verwenden?
Nur, wenn Sie den Speicher für ein Modell der 27B-Klasse haben. Qwen 3.6 erscheint mit offenen Gewichten als 27B dicht und 35B A3B, und das praktische lokale Modell von Qwen 3.8 ist Qwen3.8-27B, veröffentlicht am 14. August 2026. Beide gibt es in Ollama. Qwen3.8-Flash-Next (125B MoE, 6B aktiv, offene Gewichte seit dem 26. August 2026) lässt sich ebenfalls herunterladen, braucht aber weit mehr Speicher als jedes Gemma-4-Modell. Unterhalb von 27B ist Qwen 3.5 weiterhin das neueste Qwen, das Sie betreiben können, daher gilt der Vergleich Gemma 4 gegen Qwen 3.5 auf Rechnern mit 8 bis 16GB weiterhin. Qwen 3.7 gibt es nur per API und kann nicht lokal betrieben werden.
Wie schneidet Gemma 4 31B im Vergleich zu Qwen 3.5 27B ab?
Es ist das engste Duell der großen Klasse, und beide passen auf eine einzelne 24GB-GPU. Gemma 4 31B liegt vorn bei Multimodalität, Mehrsprachigkeit und Long-Context-Retrieval und erreicht 66.4 auf MRCR v2, gegenüber 13.5 beim Vorgänger Gemma 3. Qwen 3.5 27B liegt vorn beim Coding und erreicht 72.4 auf SWE-bench Verified. Unabhängige Auswertungen sind sich über den Gesamtsieger nicht einig, ein guter Hinweis darauf, dass Ihre eigene Arbeitslast entscheiden sollte.
Wie betreibe ich Gemma 4 oder Qwen 3.5 lokal?
Beide Familien werden von Ollama, LM Studio, llama.cpp, vLLM und MLX unterstützt, mit GGUF-Quantisierungen auf Hugging Face. Ziehen Sie das Modell, das in 4-Bit zu Ihrem VRAM passt, und begrenzen Sie dann die Kontextlänge, statt den Standard von 256K zu übernehmen, denn die KV-Cache-Belegung bei vollem Kontext erschöpft den Speicher auf Consumer-Hardware lange vor den Gewichten.
Ist Gemma 4 oder Qwen 3.5 günstiger im Betrieb?
Beide lassen sich unter Apache 2.0 kostenlos herunterladen, die Kosten bestehen also ausschließlich aus Hardware und Strom. Die Effizienzsieger sind die spärlichen Modelle: Gemma 4 26B A4B aktiviert 3.8B Parameter pro Token und erreicht etwa 97% der Qualität des dichten 31B, und Qwen 3.5 35B A3B aktiviert nur 3B. Wenn Sie stattdessen mit gehosteten APIs vergleichen, denken Sie daran, dass jede verwaltete Agentenplattform, die einen Aufschlag auf die Inferenz verlangt, laufende Kosten verursacht, die bei diesen Modellen entfallen.
Sind offene Modelle wie diese zuverlässig genug für einen Agenten in der Produktion?
Für eng umrissene, klar abgegrenzte Aufgaben ja, und Tausende Teams tun es bereits. Das Risiko ist nicht die Genauigkeit, sondern das Verhalten unter Quantisierung: Quantisierungen mit aktiviertem Reasoning können die Grenzen für Ausgabe-Token aufbrauchen, bevor sie eine Antwort liefern, was wie ein Hänger aussieht und nicht wie ein Fehler. Testen Sie mit Ihren echten Prompts bei Ihrer echten Quantisierungsstufe, setzen Sie eine Obergrenze für die Ausgabe und schalten Sie vor alles Destruktive einen Freigabeschritt, bevor Sie es unbeaufsichtigt laufen lassen.